KI für EinsteigerAnleitung
Preis pro 1M Tokens vs. Kosten pro Aufgabe: So vergleichst du KI-Modelle
Ein Modell mit einem niedrigeren Preis pro 1M Tokens kann trotzdem mehr pro erledigter Aufgabe kosten. Lerne, die Kosten pro Aufgabe aus Tokens rein, Tokens out und Versuchen zu berechnen.
Auf dieser Seite
Vergleiche Modelle nach dem, was eine erledigte Aufgabe kostet, nicht nach dem Preis pro 1M Tokens. Eine Aufgabe kostet Tokens in × Eingabepreis + Tokens out × Ausgabepreis, multipliziert mit der Anzahl der Versuche, die nötig sind. Ein Modell zum halben Preis pro Token kann dir also trotzdem die größere Rechnung präsentieren.
Das ist die übliche Überraschung: Der Agent ist fertig, die Preisliste sah günstig aus, und die Rechnung ist größer, als die Aufgabe verdient hätte. Finden wir heraus, wo sich der Unterschied versteckt.
Ein Preis pro Token ist ein Preis pro Kilo#
Ein Preis pro Kilo Mehl sagt dir nichts über die Kosten des Abendessens. Du musst wissen, wie viele Kilos das Rezept braucht, und ob du die erste Charge verbrennst und neu anfängst.
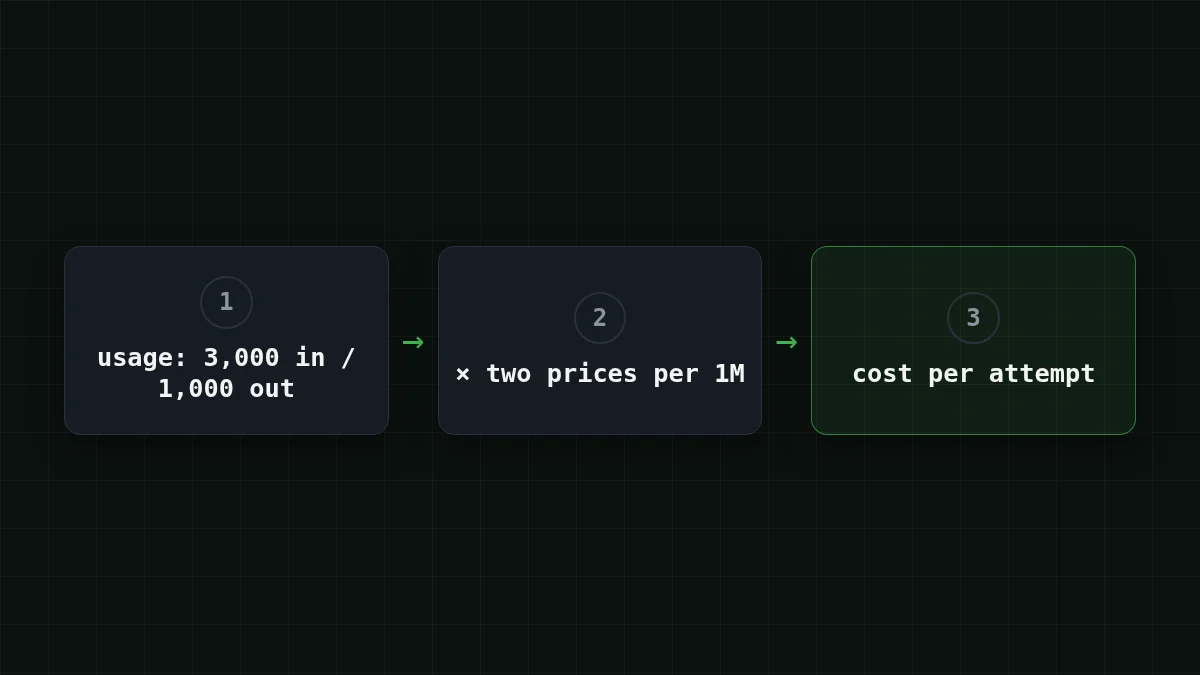
KI-Modelle funktionieren genauso. Der Preis pro 1M Tokens ist der Preis pro Kilo. Die Aufgabe ist das Abendessen. Jede Anfrage wird auf zwei Seiten abgerechnet: die Tokens, die du sendest (Input), und die Tokens, die das Modell zurückschreibt (Output). Beide Zahlen kommen im Feld usage jeder Antwort einer OpenAI-kompatiblen API wie der CheapTokens API unter https:/ zurück (geprüft am 29. Oktober 2026), du musst sie also nie raten.
Hier ist die ganze Formel:
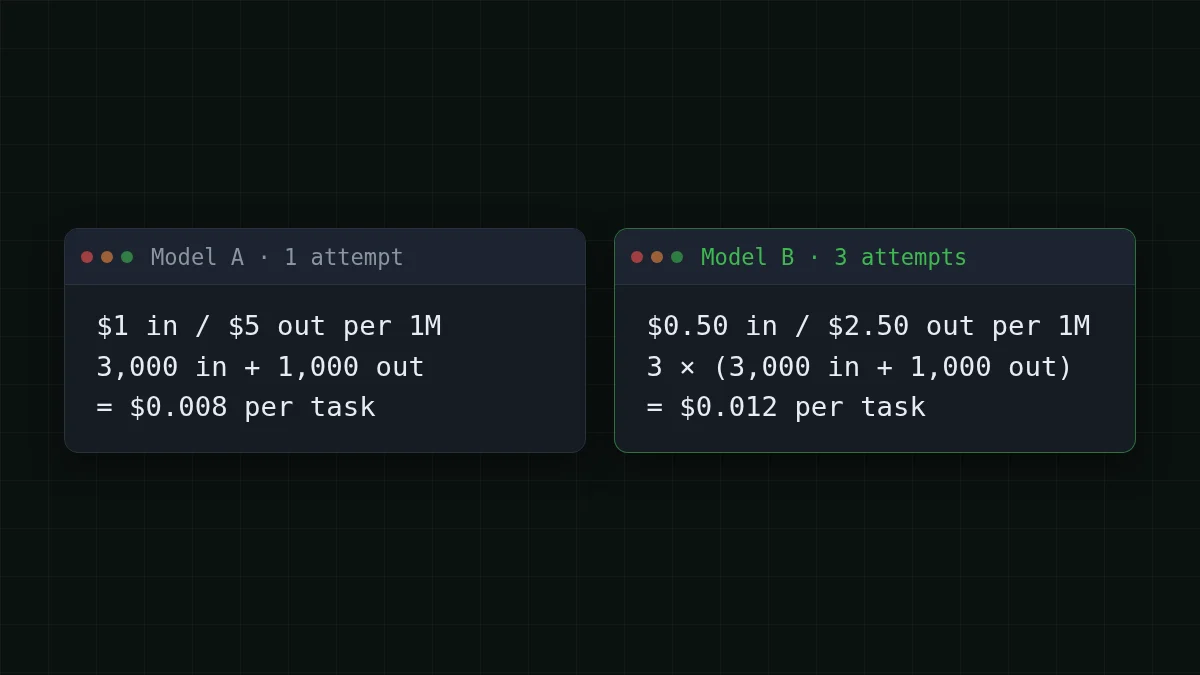
cost per task = attempts × (tokens in × input price + tokens out × output price)Sagen wir, eine Aufgabe sendet 3.000 Tokens und bekommt 1.000 zurück. Modell A kostet $1 pro 1M Tokens für Input und $5 für Output. Modell B kostet die Hälfte: $0,50 und $2,50. (Das sind erfundene runde Preise für die Rechnung, nicht die Preisliste von irgendwem.)
Modell A, ein Versuch:
- 3.000 × $1 ÷ 1.000.000 = $0,003 für Input
- 1.000 × $5 ÷ 1.000.000 = $0,005 für Output
- $0,003 + $0,005 = $0,008 pro Aufgabe
Modell B sieht nach dem Schnäppchen aus. Aber sagen wir, es braucht drei Versuche für ein brauchbares Ergebnis, und jeder Versuch kostet gleich viel:
- 3.000 × $0,50 ÷ 1.000.000 = $0,0015 für Input
- 1.000 × $2,50 ÷ 1.000.000 = $0,0025 für Output
- $0,0015 + $0,0025 = $0,004 pro Versuch
- 3 × $0,004 = $0,012 pro Aufgabe
Halber Preis pro Token, eineinhalbfacher Preis pro Aufgabe. Dasselbe passiert ohne Wiederholungen, wenn B einfach längere Antworten schreibt: mit 3.000 Output-Tokens in einem Versuch ergibt 3.000 × $2,50 ÷ 1.000.000 = $0,0075, und $0,0015 + $0,0075 = $0,009. Immer noch mehr als A's $0,008.
Und umgekehrt gilt es auch. Wenn B es beim ersten Mal richtig macht, kostet es $0,004 pro Aufgabe, die Hälfte von A. Der Preis pro Token gewinnt nur, wenn die Anzahl der Tokens und Versuche etwa gleich ist. Genau das ist der Punkt, den man prüfen sollte.
Lernkarten
Begriffe, die dir in jeder API-Doku begegnen
Tippe auf eine Karte, um sie umzudrehen
Wohin die Tokens pro Aufgabe tatsächlich gehen#
Drei Dinge bewegen die Token-Anzahl, und keines davon steht auf einer Preisliste.
- Antwortlänge. Ein Modell, das sich ausführlich erklärt, schreibt mehr Output-Tokens als eines, das in einer Zeile antwortet.
- Wiederholungen. Eine fehlgeschlagene oder unbrauchbare Antwort hat trotzdem Tokens gekostet, und der nächste Versuch zahlt erneut.
- Erneut gesendeter Kontext. Eine API erinnert sich nicht: Jeder Schritt eines Agenten sendet die Anweisungen, die Dateien und den Verlauf erneut. Falls das neu ist, zeigt warum ein langer Chat mehr kostet den Mechanismus.
Der dritte Punkt ist der große bei Agenten. Nimm einen Coding-Agenten, der in 20 Schritten arbeitet. Gehe von einem schweren Agenten-Schritt aus: 20.000 Tokens rein und 1.000 zurück. Für einen leichteren Lauf mit echten Schritt-für-Schritt-Zahlen siehe warum KI-Agenten so viele Tokens verbrauchen. Die Antworten sind kurz. Der Input nicht.
Zahl erraten
Wie viele Input-Tokens sendet ein 20-Schritte-Agent insgesamt, wenn jeder Schritt 20.000 sendet?
Deine Schätzung
01.000.000
Antwort anzeigen
Antwort: 400.000
20 × 20.000 = 400.000. Jeder Schritt sendet den Kontext erneut, also stapelt sich der Input, obwohl jede Antwort kurz ist.
Für diesen Job entscheidet also die Input-Seite über die Rechnung, und die Output-Seite spielt kaum eine Rolle. Ein Modell mit günstigem Input-Preis kann hier gewinnen, selbst wenn sein Output-Preis gewöhnlich aussieht. Das zeigt dir eine Preisliste nur, wenn du sie mit deiner eigenen Aufgabe im Kopf liest.
Hier ist genau dieser Job, 20 Schritte mit 20.000 rein und 1.000 out, auf den bei CheapTokens verfügbaren Modellen. Die Tabelle ist live, die Zahlen folgen also den aktuellen Preisen, und die OpenRouter-Spalte ist zum Vergleich da. Mit Input und Output zusammengezählt sind alle drei insgesamt günstiger als OpenRouter.
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 20 Anfragen | OpenRouter, 20 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00044 | $0.0088 | $0.0151 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0004 | $0.008 | $0.0308 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0012 | $0.023 | $0.276 |
20.000 Input- und 1.000 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Für Agenten-Schleifen wie diese ist DeepSeek-V4-Flash ein natürlicher Fit: 380K Kontext, bis zu 32.768 Output-Tokens pro Antwort und ein Preis zu jeder Tageszeit, ein Nachtlauf kostet also dasselbe wie ein Tageslauf. Der ganze Job über alle 20 Schritte darauf kommt auf $0.008. Siehe die Modellseite für Details und die Preistabelle für jedes Modell.
Ein Chatbot ist die entgegengesetzte Geschichte#
Nimm jetzt einen Support-Bot. Sagen wir, er bekommt 1.000 Anfragen pro Tag, und jede ist eine 2.000-Token-Frage mit Kontext und eine 500-Token-Antwort. Keine Schleife, kein wachsender Verlauf, ein Versuch.
Hier ist der Preis pro Token fast der Preis pro Aufgabe, weil nichts ihn multipliziert. Auf GLM-5.3-Flash, mit 390K Kontext und bis zu 8.192 Output-Tokens pro Antwort, kostet eine Anfrage $0.00006 und der ganze Tag mit 1.000 Anfragen kostet $0.06.
Die Faustregel ist also einfach. Eine kurze Einzelaufgabe: Der Preis pro Token ist ein fairer Anhaltspunkt. Eine Schleife, ein wiederholungsanfälliger Job oder ein Job mit langen Antworten: Kalkuliere eine ganze Aufgabe, bevor du wählst.
Miss deine eigene Aufgabe in zehn Minuten#
Deine eigenen Zahlen schlagen jedes Beispiel hier. Das Skript unten sendet eine Anfrage und gibt aus, was sie tatsächlich verbraucht hat und was das kostet. Die Preise darin sind ein Beispiel: ersetze sie durch die aktuellen aus der Preistabelle.
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1", api_key="YOUR_KEY")

# example prices per 1M tokens, substitute current ones
PRICE_IN, PRICE_OUT = 1.00, 5.00

resp = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Summarize this ticket in one sentence: <your text>"}],
    max_tokens=300,
)
u = resp.usage
cost = (u.prompt_tokens * PRICE_IN + u.completion_tokens * PRICE_OUT) / 1_000_000
print(u.prompt_tokens, u.completion_tokens, round(cost, 6))
Wenn es funktioniert, bekommst du drei Zahlen in einer Zeile: Tokens rein, Tokens out und die Kosten dieses Versuchs. Dann:
- Führe 20 echte Aufgaben von dir aus, keine Spielzeugaufgaben.
- Addiere die Kosten jedes Versuchs, auch der verworfenen.
- Teile durch 20. Das sind deine Kosten pro Aufgabe.
- Wiederhole das mit dem anderen Modell und vergleiche die beiden Ergebnisse.
Für einen längeren Lauf fügt das Verfolgen der Token-Kosten von Agenten in Python demselben Gedanken ein Budget und einen Stopp hinzu, und wie viele Tokens eine Anfrage verbraucht zeigt typische Größen zum Starten.
Kurzer Check#
Kurzer Check
Modell B kostet halb so viel pro Token wie Modell A. Wann kann B trotzdem mehr pro erledigter Aufgabe kosten?
Antwort anzeigen
Antwort: Wenn es mehr Versuche braucht oder viel längere Antworten schreibt
Kosten pro Aufgabe = Versuche × Tokens × Preis. Halbiere den Preis, verdreifache die Versuche, und du zahlst das 1,5-Fache.
Als Nächstes erklärt Input vs Output Tokens, warum die beiden Seiten unterschiedlich bepreist sind, und die Docs bringen dich von einem Key zur ersten Anfrage.


