AI per principiantiGuida
Prezzo per 1M di token vs costo per attività: come confrontare i modelli AI
Un modello con un prezzo per 1M di token più basso può comunque costare di più per attività completata. Impara a calcolare il costo per attività da token in, token out e tentativi.
In questa pagina
Confronta i modelli in base a quanto costa un'attività completata, non in base al prezzo per 1M di token. Un'attività costa token in × prezzo di input + token out × prezzo di output, moltiplicato per il numero di tentativi necessari. Quindi un modello a metà del prezzo per token può comunque presentarti il conto più salato.
Questa è la sorpresa abituale: l'agente ha finito, il listino sembrava economico e la fattura è più alta di quanto l'attività meritasse. Scopriamo dove si nasconde la differenza.
Un prezzo per token è un prezzo al chilo#
Un prezzo al chilo della farina non ti dice nulla sul costo della cena. Devi sapere quanti chili richiede la ricetta e se bruci la prima infornata e ricominci.
I modelli AI funzionano allo stesso modo. Il prezzo per 1M di token è il prezzo al chilo. L'attività è la cena. Ogni richiesta viene fatturata su due lati: i token che invii (input) e i token che il modello scrive in risposta (output). Entrambi i numeri tornano nel campo usage di ogni risposta di un'API compatibile con OpenAI, come l'API CheapTokens su https:/ (verificato il 29 ottobre 2026), quindi non devi mai indovinarli.
Ecco la formula completa:
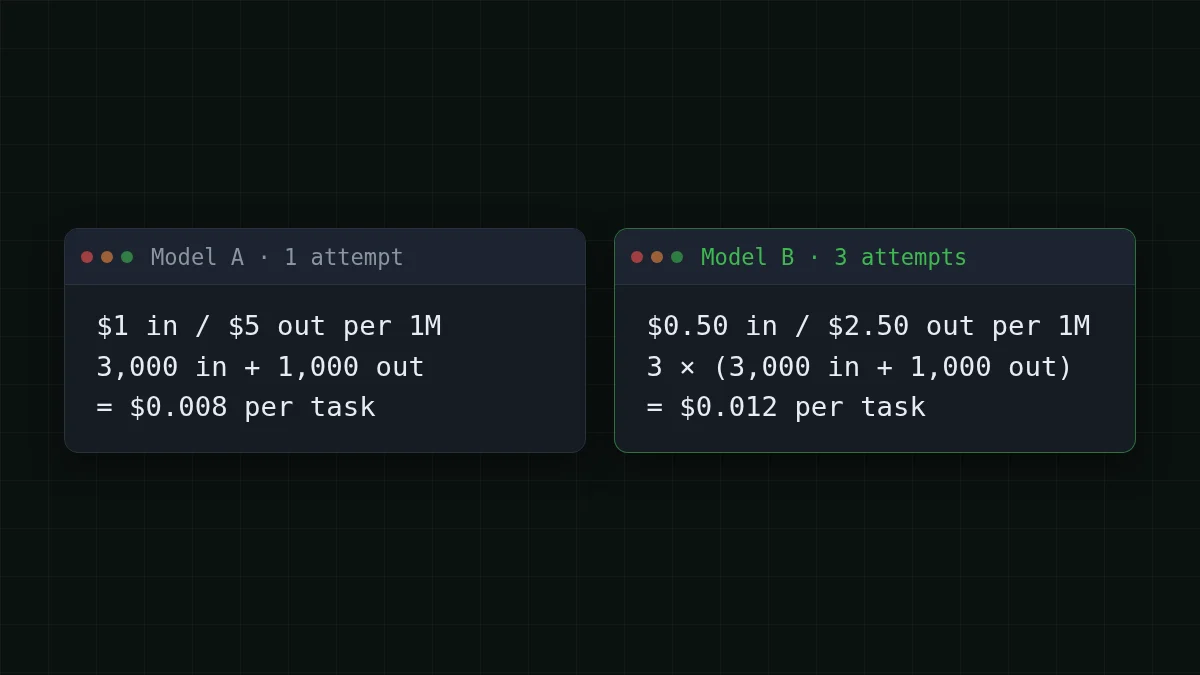
cost per task = attempts × (tokens in × input price + tokens out × output price)Supponiamo che un'attività invii 3.000 token e ne riceva 1.000 indietro. Il modello A costa $1 per 1M di token per l'input e $5 per l'output. Il modello B costa la metà: $0,50 e $2,50. (Sono prezzi tondi inventati per il calcolo, non il listino di nessuno.)
Modello A, un tentativo:
- 3.000 × $1 ÷ 1.000.000 = $0,003 per l'input
- 1.000 × $5 ÷ 1.000.000 = $0,005 per l'output
- $0,003 + $0,005 = $0,008 per attività
Il modello B sembra l'affare. Ma supponiamo che servano tre tentativi per ottenere un risultato utilizzabile, e che ogni tentativo costi lo stesso:
- 3.000 × $0,50 ÷ 1.000.000 = $0,0015 per l'input
- 1.000 × $2,50 ÷ 1.000.000 = $0,0025 per l'output
- $0,0015 + $0,0025 = $0,004 per tentativo
- 3 × $0,004 = $0,012 per attività
Metà del prezzo per token, una volta e mezza il prezzo per attività. La stessa cosa accade senza tentativi se B semplicemente scrive risposte più lunghe: con 3.000 token di output in un solo tentativo, 3.000 × $2,50 ÷ 1.000.000 = $0,0075, e $0,0015 + $0,0075 = $0,009. Comunque più degli $0,008 di A.
E vale anche il contrario. Se B ci azzecca al primo tentativo, costa $0,004 per attività, la metà di A. Il prezzo per token vince solo quando il numero di token e di tentativi è più o meno uguale. Che è esattamente la cosa da verificare.
Flashcard
Parole che incontrerai in ogni documentazione API
Tocca una carta per girarla
Dove finiscono davvero i token per attività#
Tre cose muovono il conteggio dei token, e nessuna compare su un listino.
- Lunghezza della risposta. Un modello che si spiega a lungo scrive più token di output di uno che risponde in una riga.
- Nuovi tentativi. Una risposta fallita o inutilizzabile è comunque costata token, e il tentativo successivo paga di nuovo.
- Contesto reinviato. Un'API non ricorda: ogni passo di un agente invia di nuovo le istruzioni, i file e la cronologia. Se è una novità, perché una chat lunga costa di più mostra il meccanismo.
Il terzo è quello grosso per gli agenti. Prendi un agente di coding che lavora in 20 passi. Ipotizza un passo pesante: 20.000 token in e 1.000 indietro. Per un'esecuzione più leggera con numeri reali passo per passo, vedi perché gli agenti AI usano così tanti token. Le risposte sono brevi. L'input no.
Indovina il numero
Quanti token di input invia in totale un agente da 20 passi, se ogni passo ne invia 20.000?
La tua risposta
01.000.000
Mostra risposta
Risposta: 400.000
20 × 20.000 = 400.000. Ogni passo reinvia il contesto, quindi l'input si accumula anche se ogni risposta è breve.
Quindi per questo lavoro è il lato input a decidere il conto, e il lato output conta poco. Un modello con un prezzo di input basso può vincere qui anche se il suo prezzo di output sembra nella media. È una cosa che un listino ti mostra solo quando lo leggi con la tua attività in mente.
Ecco esattamente quel lavoro, 20 passi da 20.000 in e 1.000 out, sui modelli disponibili su CheapTokens. La tabella è live, quindi i numeri seguono i prezzi attuali, e la colonna OpenRouter è lì per confronto. Contando insieme input e output, tutti e tre costano meno di OpenRouter in totale.
| Modello | Input $/1M | Output $/1M | Per richiesta | 20 richieste | OpenRouter, 20 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00044 | $0.0088 | $0.0151 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0004 | $0.008 | $0.0308 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0012 | $0.023 | $0.276 |
20.000 token di input e 1000 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
Per cicli di agenti come questo, DeepSeek-V4-Flash è una scelta naturale: contesto da 380K, fino a 32.768 token di output per risposta e un unico prezzo a qualsiasi ora del giorno, quindi un'esecuzione notturna costa come una diurna. L'intero lavoro su tutti i 20 passi con questo modello arriva a $0.008. Vedi la pagina del modello per i dettagli e la tabella dei prezzi per ogni modello.
Un chatbot è la storia opposta#
Ora prendi un bot di supporto. Supponiamo che riceva 1.000 richieste al giorno, e che ognuna sia una domanda da 2.000 token con contesto e una risposta da 500 token. Nessun ciclo, nessuna cronologia che cresce, un solo tentativo.
Qui il prezzo per token è quasi il costo per attività, perché nulla lo moltiplica. Su GLM-5.3-Flash, con contesto da 390K e fino a 8.192 token di output per risposta, una richiesta costa $0.00006 e l'intera giornata di 1.000 richieste costa $0.06.
Quindi la regola pratica è semplice. Un'attività breve e a colpo singolo: il prezzo per token è una guida equa. Un ciclo, un lavoro soggetto a nuovi tentativi o un lavoro con risposte lunghe: calcola il prezzo di un'intera attività prima di scegliere.
Misura la tua attività in dieci minuti#
I tuoi numeri battono qualsiasi esempio qui. Lo script qui sotto invia una richiesta e stampa ciò che ha effettivamente usato e quanto costa. I prezzi al suo interno sono un esempio: sostituiscili con quelli attuali da la tabella dei prezzi.
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1", api_key="YOUR_KEY")

# example prices per 1M tokens, substitute current ones
PRICE_IN, PRICE_OUT = 1.00, 5.00

resp = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Summarize this ticket in one sentence: <your text>"}],
    max_tokens=300,
)
u = resp.usage
cost = (u.prompt_tokens * PRICE_IN + u.completion_tokens * PRICE_OUT) / 1_000_000
print(u.prompt_tokens, u.completion_tokens, round(cost, 6))
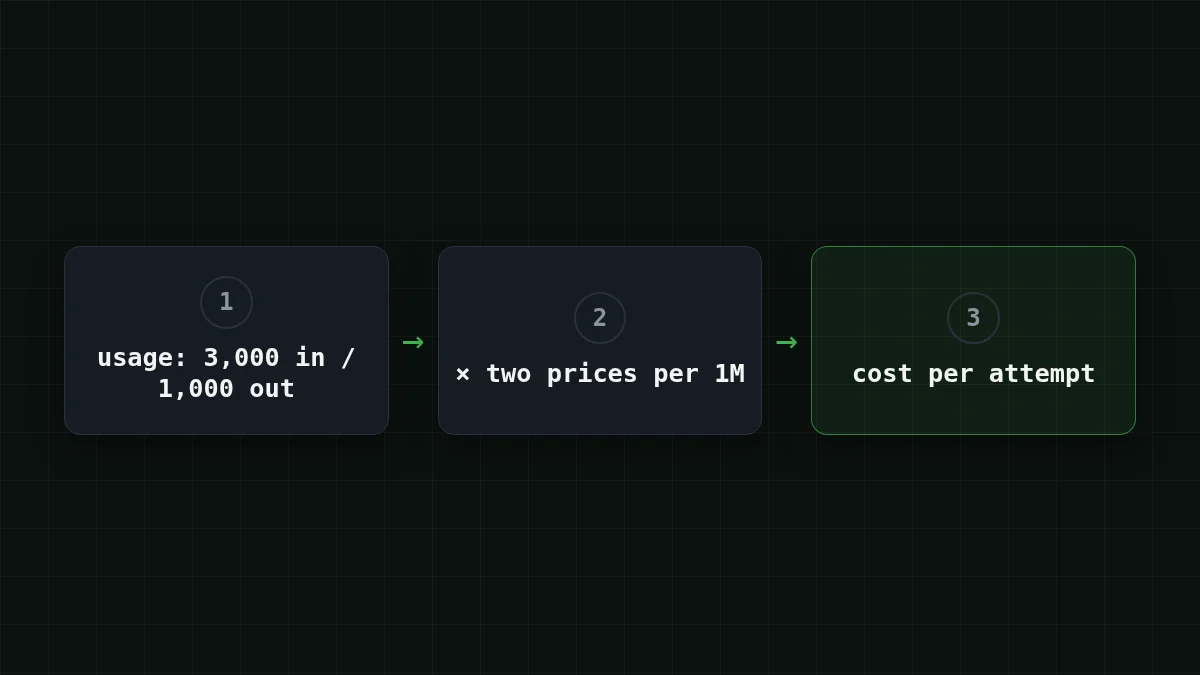
Quando funziona ottieni tre numeri su una riga: token in, token out e il costo di quel tentativo. Poi:
- Esegui 20 attività reali tue, non di prova.
- Somma il costo di ogni tentativo, inclusi quelli che hai scartato.
- Dividi per 20. Questo è il tuo costo per attività.
- Ripeti con l'altro modello e confronta i due risultati.
Per un'esecuzione più lunga, tracciare il costo dei token degli agenti in Python aggiunge un budget e uno stop alla stessa idea, e quanti token usa una richiesta mostra le dimensioni tipiche da cui partire.
Verifica rapida#
Verifica rapida
Il modello B costa la metà per token del modello A. Quando può comunque costare di più per attività completata?
Mostra risposta
Risposta: Quando servono più tentativi o scrive risposte molto più lunghe
Costo per attività = tentativi × token × prezzo. Dimezza il prezzo, triplica i tentativi e paghi 1,5 volte tanto.
Poi, token di input vs output spiega perché i due lati hanno prezzi diversi, e la documentazione ti porta da una chiave alla prima richiesta.


