Preço por 1M de tokens vs custo por tarefa: como comparar modelos de IA
Um modelo com preço menor por 1M de tokens ainda pode custar mais por tarefa concluída. Aprenda a calcular o custo por tarefa a partir de tokens de entrada, tokens de saída e tentativas.
Nesta página
Compare modelos pelo que uma tarefa concluída custa, não pelo preço por 1M de tokens. Uma tarefa custa tokens de entrada × preço de entrada + tokens de saída × preço de saída, multiplicado pelo número de tentativas necessárias. Então um modelo com metade do preço por token ainda pode te entregar a conta maior.
Essa é a surpresa de sempre: o agente terminou, a tabela de preços parecia barata, e a fatura é maior do que a tarefa merecia. Vamos descobrir onde a diferença se esconde.
Preço por token é preço por quilo#
O preço do quilo de farinha não diz nada sobre o custo do jantar. Você precisa saber quantos quilos a receita leva, e se você queima a primeira fornada e começa de novo.
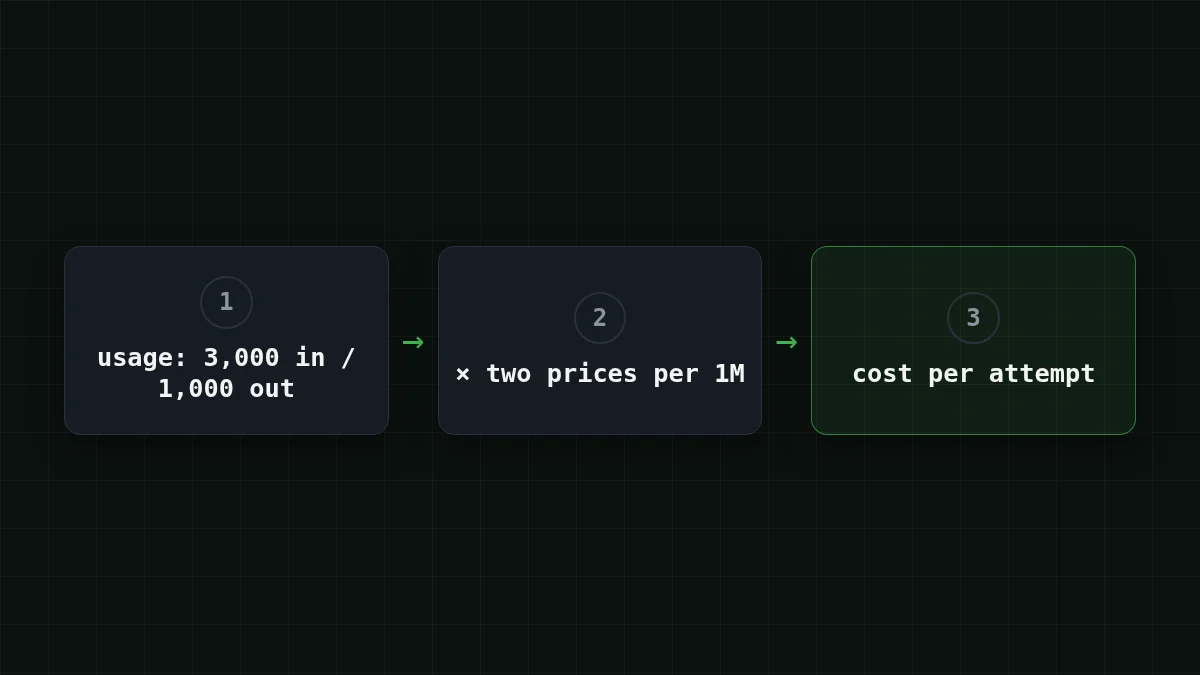
Modelos de IA funcionam do mesmo jeito. O preço por 1M de tokens é o preço por quilo. A tarefa é o jantar. Cada requisição é cobrada dos dois lados: os tokens que você envia (entrada) e os tokens que o modelo escreve de volta (saída). Os dois números voltam no campo usage de toda resposta de uma API compatível com OpenAI, como a API da CheapTokens em https:/ (verificado em 29 de outubro de 2026), então você nunca precisa adivinhá-los.
Aqui está a fórmula inteira:
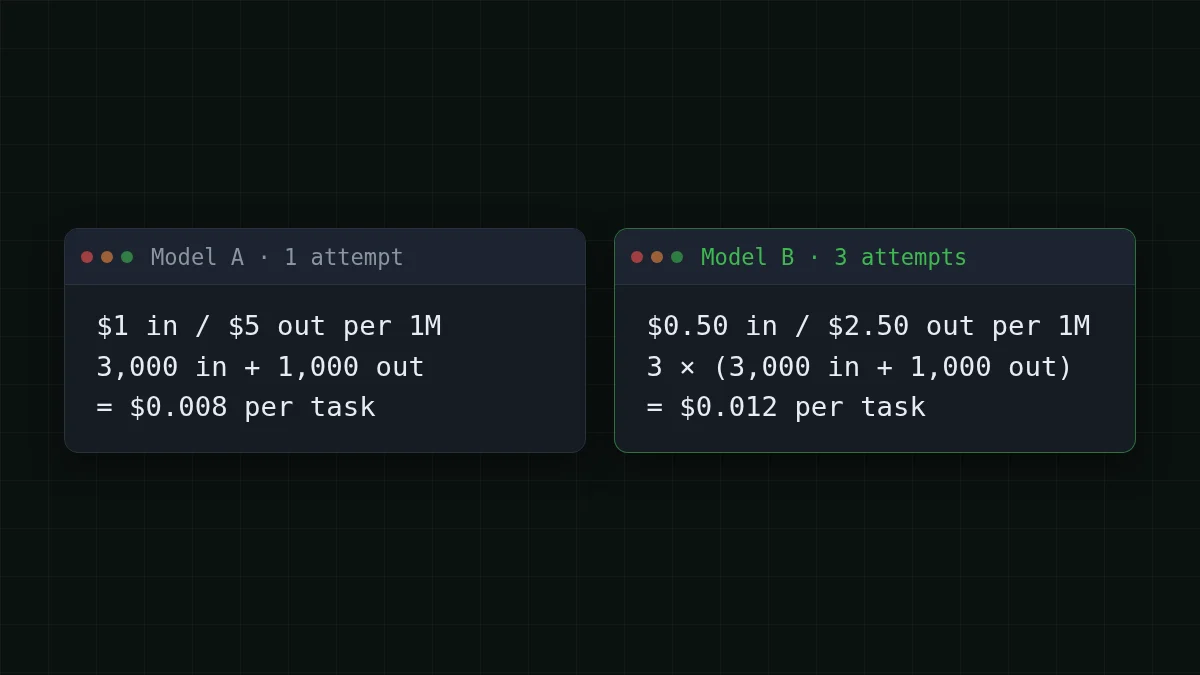
cost per task = attempts × (tokens in × input price + tokens out × output price)Digamos que uma tarefa envie 3.000 tokens e receba 1.000 de volta. O modelo A custa $1 por 1M de tokens de entrada e $5 de saída. O modelo B custa metade: $0,50 e $2,50. (São preços redondos inventados para a conta, não a tabela de preços de ninguém.)
Modelo A, uma tentativa:
- 3.000 × $1 ÷ 1.000.000 = $0,003 de entrada
- 1.000 × $5 ÷ 1.000.000 = $0,005 de saída
- $0,003 + $0,005 = $0,008 por tarefa
O modelo B parece a pechincha. Mas digamos que ele precise de três tentativas para chegar a um resultado utilizável, e cada tentativa custe o mesmo:
- 3.000 × $0,50 ÷ 1.000.000 = $0,0015 de entrada
- 1.000 × $2,50 ÷ 1.000.000 = $0,0025 de saída
- $0,0015 + $0,0025 = $0,004 por tentativa
- 3 × $0,004 = $0,012 por tarefa
Metade do preço por token, uma vez e meia o preço por tarefa. A mesma coisa acontece sem retentativas se B simplesmente escrever respostas mais longas: com 3.000 tokens de saída em uma tentativa, 3.000 × $2,50 ÷ 1.000.000 = $0,0075, e $0,0015 + $0,0075 = $0,009. Ainda mais que os $0,008 de A.
E o contrário também vale. Se B acerta de primeira, custa $0,004 por tarefa, metade de A. O preço por token só vence quando o número de tokens e de tentativas é mais ou menos igual. Que é exatamente o que se deve verificar.
Flashcards
Palavras que você vai encontrar em toda doc de API
Toque num cartão para virar
Para onde vão de fato os tokens por tarefa#
Três coisas movem a contagem de tokens, e nenhuma delas aparece numa tabela de preços.
- Tamanho da resposta. Um modelo que se explica longamente escreve mais tokens de saída do que um que responde em uma linha.
- Retentativas. Uma resposta falha ou inutilizável ainda custou tokens, e a próxima tentativa paga de novo.
- Contexto reenviado. Uma API não lembra: cada passo de um agente reenvia as instruções, os arquivos e o histórico. Se isso é novidade, por que um chat longo custa mais mostra o mecanismo.
A terceira é a grande para agentes. Pegue um agente de código que trabalha em 20 passos. Suponha um passo pesado de agente: 20.000 tokens de entrada e 1.000 de volta. Para uma execução mais leve com números reais passo a passo, veja por que agentes de IA usam tantos tokens. As respostas são curtas. A entrada não.
Adivinhar o número
Quantos tokens de entrada um agente de 20 passos envia no total, se cada passo envia 20.000?
O seu palpite
01.000.000
Mostrar resposta
Resposta: 400.000
20 × 20.000 = 400.000. Cada passo reenvia o contexto, então a entrada se acumula mesmo que cada resposta seja curta.
Então, para esse trabalho, o lado da entrada decide a conta, e o lado da saída quase não importa. Um modelo com preço de entrada barato pode vencer aqui mesmo que seu preço de saída pareça comum. Isso é algo que uma tabela de preços só mostra quando você a lê pensando na sua própria tarefa.
Aqui está exatamente esse trabalho, 20 passos de 20.000 de entrada e 1.000 de saída, nos modelos disponíveis na CheapTokens. A tabela é ao vivo, então os números acompanham os preços atuais, e a coluna OpenRouter está lá para comparação. Com entrada e saída somadas, os três são mais baratos que o OpenRouter no total.
| Modelo | Entrada $/1M | Saída $/1M | Por solicitação | 20 solicitações | OpenRouter, 20 solicitações |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00044 | $0.0088 | $0.0151 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0004 | $0.008 | $0.0308 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0012 | $0.023 | $0.276 |
20.000 tokens de entrada e 1.000 tokens de saída por solicitação. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
Para loops de agente como esse, o DeepSeek-V4-Flash é uma escolha natural: contexto de 380K, até 32.768 tokens de saída por resposta, e um preço único em qualquer hora do dia, então uma execução noturna custa o mesmo que uma diurna. O trabalho inteiro nos 20 passos nele sai por $0.008. Veja a página do modelo para detalhes e a tabela de preços para todos os modelos.
Um chatbot é a história oposta#
Agora pegue um bot de suporte. Digamos que ele receba 1.000 requisições por dia, e cada uma seja uma pergunta de 2.000 tokens com contexto e uma resposta de 500 tokens. Sem loop, sem histórico que cresce, uma tentativa.
Aqui o preço por token é quase o custo por tarefa, porque nada o multiplica. No GLM-5.3-Flash, com contexto de 390K e até 8.192 tokens de saída por resposta, uma requisição custa $0.00006 e o dia inteiro de 1.000 requisições custa $0.06.
Então a regra prática é simples. Uma tarefa curta e de tiro único: o preço por token é um guia justo. Um loop, um trabalho propenso a retentativas ou um trabalho de resposta longa: precifique a tarefa inteira antes de escolher.
Meça sua própria tarefa em dez minutos#
Seus próprios números vencem qualquer exemplo aqui. O script abaixo envia uma requisição e imprime o que ela realmente usou e quanto isso custa. Os preços nele são um exemplo: substitua pelos atuais de a tabela de preços.
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1", api_key="YOUR_KEY")

# example prices per 1M tokens, substitute current ones
PRICE_IN, PRICE_OUT = 1.00, 5.00

resp = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Summarize this ticket in one sentence: <your text>"}],
    max_tokens=300,
)
u = resp.usage
cost = (u.prompt_tokens * PRICE_IN + u.completion_tokens * PRICE_OUT) / 1_000_000
print(u.prompt_tokens, u.completion_tokens, round(cost, 6))
Quando funciona, você recebe três números em uma linha: tokens de entrada, tokens de saída e o custo daquela tentativa. Então:
- Rode 20 tarefas reais suas, não tarefas de brinquedo.
- Some o custo de cada tentativa, incluindo as que você descartou.
- Divida por 20. Esse é o seu custo por tarefa.
- Repita com o outro modelo e compare os dois resultados.
Para uma execução mais longa, rastrear o custo de tokens de agentes em Python adiciona um orçamento e um limite à mesma ideia, e quantos tokens uma requisição usa mostra tamanhos típicos para começar.
Verificação rápida#
Verificação rápida
O modelo B custa metade do preço por token do modelo A. Quando B ainda pode custar mais por tarefa concluída?
Mostrar resposta
Resposta: Quando precisa de mais tentativas ou escreve respostas muito mais longas
Custo por tarefa = tentativas × tokens × preço. Reduza o preço pela metade, triplique as tentativas e você paga 1,5 vez mais.
A seguir, tokens de entrada vs saída explica por que os dois lados têm preços diferentes, e a documentação te leva de uma chave à primeira requisição.


