AI untuk pemulaPanduan
Harga per 1 juta token vs biaya per tugas: cara membandingkan model AI
Model dengan harga per 1 juta token lebih rendah bisa tetap lebih mahal per tugas yang selesai. Pelajari cara menghitung biaya per tugas dari token masuk, token keluar, dan percobaan.
Di halaman ini
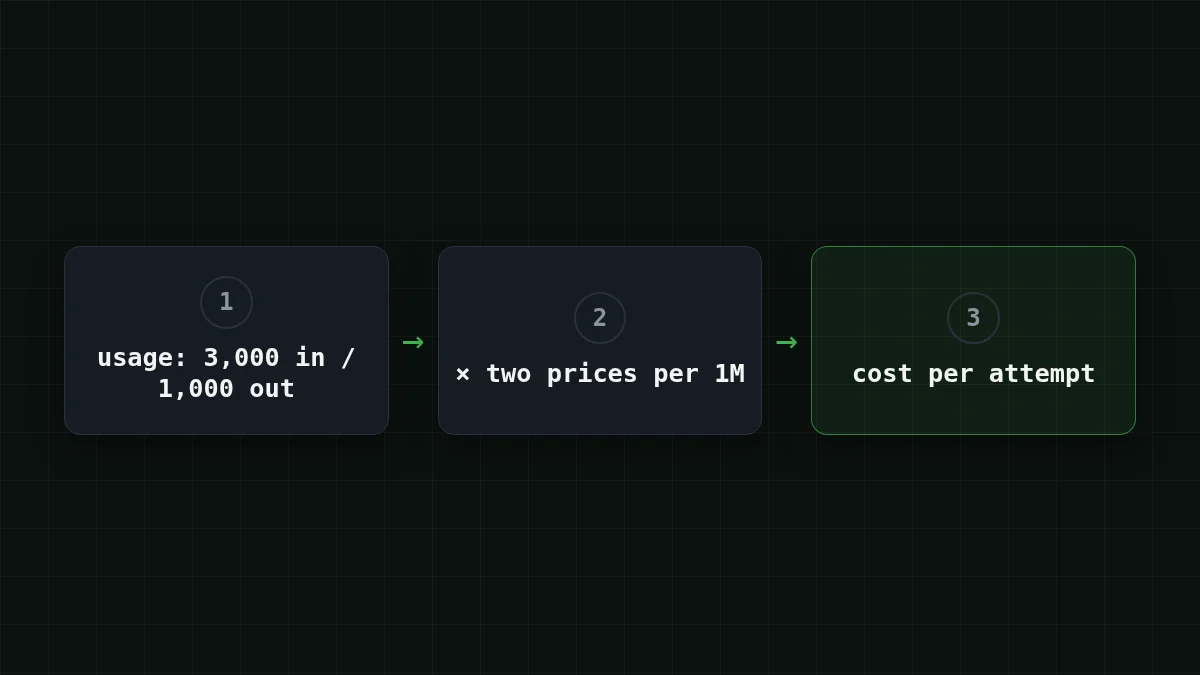
Bandingkan model berdasarkan biaya tugas yang selesai, bukan berdasarkan harga per 1 juta token. Biaya tugas = token masuk × harga input + token keluar × harga output, dikalikan dengan berapa kali percobaan yang dibutuhkan. Jadi model dengan harga per token setengahnya bisa tetap menagih Anda lebih besar.
Itulah kejutan yang biasa terjadi: agen selesai, daftar harga terlihat murah, dan tagihannya lebih besar dari yang seharusnya. Mari kita cari tahu di mana selisihnya bersembunyi.
Harga per token adalah harga per kilo#
Harga per kilo tepung tidak memberi tahu Anda apa pun tentang biaya makan malam. Anda perlu tahu berapa kilo yang dibutuhkan resep, dan apakah Anda membakar batch pertama lalu mulai lagi.
Model AI bekerja dengan cara yang sama. Harga per 1 juta token adalah harga per kilo. Tugasnya adalah makan malam. Setiap permintaan ditagih dari dua sisi: token yang Anda kirim (input) dan token yang ditulis model kembali (output). Kedua angka dikembalikan dalam field usage pada setiap respons dari API yang kompatibel dengan OpenAI seperti API CheapTokens di https:/ (diperiksa 29 Oktober 2026), jadi Anda tidak perlu menebaknya.
Berikut rumus lengkapnya:
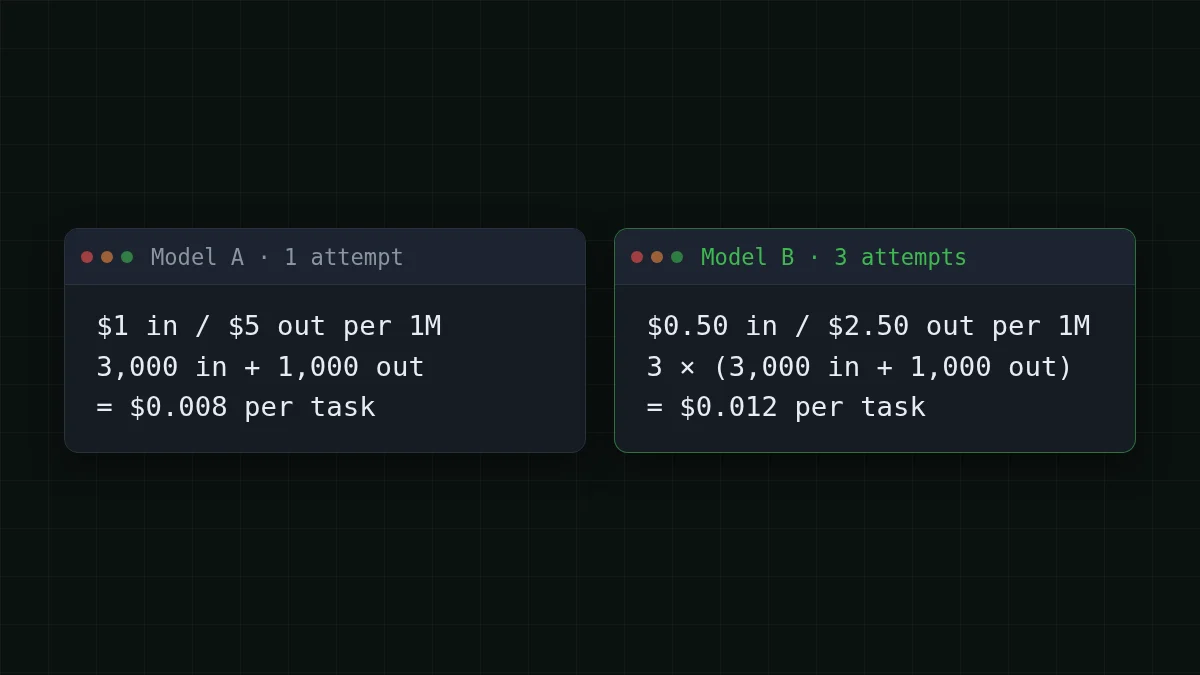
cost per task = attempts × (tokens in × input price + tokens out × output price)Misalkan sebuah tugas mengirim 3.000 token dan menerima 1.000 kembali. Model A berharga $1 per 1 juta token untuk input dan $5 untuk output. Model B setengahnya: $0,50 dan $2,50. (Ini harga bulat karangan untuk perhitungan, bukan daftar harga siapa pun.)
Model A, satu percobaan:
- 3.000 × $1 ÷ 1.000.000 = $0,003 untuk input
- 1.000 × $5 ÷ 1.000.000 = $0,005 untuk output
- $0,003 + $0,005 = $0,008 per tugas
Model B tampak seperti barang murah. Tapi misalkan ia butuh tiga kali percobaan untuk mendapatkan hasil yang bisa dipakai, dan setiap percobaan berbiaya sama:
- 3.000 × $0,50 ÷ 1.000.000 = $0,0015 untuk input
- 1.000 × $2,50 ÷ 1.000.000 = $0,0025 untuk output
- $0,0015 + $0,0025 = $0,004 per percobaan
- 3 × $0,004 = $0,012 per tugas
Setengah harga per token, satu setengah kali harga per tugas. Hal yang sama terjadi tanpa percobaan ulang jika B sekadar menulis jawaban lebih panjang: dengan 3.000 token output dalam satu percobaan, 3.000 × $2,50 ÷ 1.000.000 = $0,0075, dan $0,0015 + $0,0075 = $0,009. Tetap lebih mahal dari $0,008 milik A.
Dan sebaliknya juga berlaku. Jika B berhasil pada percobaan pertama, biayanya $0,004 per tugas, setengah dari A. Harga per token hanya menang ketika jumlah token dan percobaan kurang lebih sama. Itulah tepatnya hal yang perlu diperiksa.
Kartu kilat
Istilah yang akan Anda temui di setiap dokumentasi API
Ketuk kartu untuk membaliknya
Ke mana token per tugas sebenarnya pergi#
Tiga hal menggerakkan jumlah token, dan tidak satu pun muncul di daftar harga.
- Panjang jawaban. Model yang menjelaskan panjang lebar menulis lebih banyak token output daripada yang menjawab dalam satu baris.
- Percobaan ulang. Jawaban yang gagal atau tidak bisa dipakai tetap memakan token, dan percobaan berikutnya membayar lagi.
- Konteks yang dikirim ulang. API tidak mengingat: setiap langkah agen mengirim ulang instruksi, file, dan riwayat. Jika ini baru bagi Anda, mengapa obrolan panjang lebih mahal menunjukkan mekanismenya.
Yang ketiga adalah yang terbesar untuk agen. Ambil agen coding yang bekerja dalam 20 langkah. Asumsikan langkah agen yang berat: 20.000 token masuk dan 1.000 kembali. Untuk eksekusi yang lebih ringan dengan angka langkah demi langkah nyata, lihat mengapa agen AI memakai begitu banyak token. Jawabannya singkat. Inputnya tidak.
Tebak angkanya
Berapa total token input yang dikirim agen 20 langkah, jika setiap langkah mengirim 20.000?
Tebakan Anda
01.000.000
Tampilkan jawaban
Jawaban: 400.000
20 × 20.000 = 400.000. Setiap langkah mengirim ulang konteks, jadi input menumpuk meskipun setiap jawaban singkat.
Jadi untuk pekerjaan ini sisi input yang menentukan tagihan, dan sisi output hampir tidak berpengaruh. Model dengan harga input murah bisa menang di sini meskipun harga outputnya terlihat biasa. Itu adalah sesuatu yang ditunjukkan daftar harga hanya ketika Anda membacanya dengan tugas Anda sendiri dalam pikiran.
Berikut pekerjaan persis itu, 20 langkah dengan 20.000 masuk dan 1.000 keluar, pada model yang tersedia di CheapTokens. Tabelnya langsung, jadi angkanya mengikuti harga saat ini, dan kolom OpenRouter ada untuk perbandingan. Dengan input dan output dihitung bersama, ketiganya lebih murah daripada OpenRouter secara total.
| Model | Input $/1Jt | Output $/1Jt | Per permintaan | 20 permintaan | OpenRouter, 20 permintaan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00044 | $0.0088 | $0.0151 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0004 | $0.008 | $0.0308 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0012 | $0.023 | $0.276 |
20.000 token input dan 1.000 token output per permintaan. Harga per 1 juta token adalah harga saat ini dan berubah seiring tarif kami; kolom OpenRouter menunjukkan harga referensi untuk beban kerja yang sama.
Untuk loop agen seperti ini, DeepSeek-V4-Flash adalah pilihan alami: konteks 380K, hingga 32.768 token output per jawaban, dan satu harga kapan pun sepanjang hari, jadi eksekusi malam berbiaya sama dengan siang. Seluruh pekerjaan di semua 20 langkah pada model ini menjadi $0.008. Lihat halaman model untuk detail dan tabel harga untuk setiap model.
Chatbot adalah cerita yang berlawanan#
Sekarang ambil bot dukungan. Misalkan ia menerima 1.000 permintaan sehari, dan masing-masing adalah pertanyaan 2.000 token dengan konteks dan jawaban 500 token. Tanpa loop, tanpa riwayat yang membesar, satu percobaan.
Di sini harga per token hampir sama dengan biaya per tugas, karena tidak ada yang mengalikannya. Pada GLM-5.3-Flash, dengan konteks 390K dan hingga 8.192 token output per jawaban, satu permintaan berbiaya $0.00006 dan seluruh hari dengan 1.000 permintaan berbiaya $0.06.
Jadi aturan praktisnya sederhana. Tugas singkat sekali jalan: harga per token adalah panduan yang wajar. Loop, pekerjaan yang rawan percobaan ulang, atau pekerjaan dengan jawaban panjang: hitung harga satu tugas penuh sebelum Anda memilih.
Ukur tugas Anda sendiri dalam sepuluh menit#
Angka Anda sendiri mengalahkan contoh apa pun di sini. Skrip di bawah mengirim satu permintaan dan mencetak apa yang sebenarnya dipakai dan berapa biayanya. Harga di dalamnya adalah contoh: gantikan dengan yang berlaku saat ini dari tabel harga.
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1", api_key="YOUR_KEY")

# example prices per 1M tokens, substitute current ones
PRICE_IN, PRICE_OUT = 1.00, 5.00

resp = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Summarize this ticket in one sentence: <your text>"}],
    max_tokens=300,
)
u = resp.usage
cost = (u.prompt_tokens * PRICE_IN + u.completion_tokens * PRICE_OUT) / 1_000_000
print(u.prompt_tokens, u.completion_tokens, round(cost, 6))
Saat berhasil Anda mendapat tiga angka dalam satu baris: token masuk, token keluar, dan biaya percobaan itu. Lalu:
- Jalankan 20 tugas nyata Anda, bukan tugas mainan.
- Jumlahkan biaya setiap percobaan, termasuk yang Anda buang.
- Bagi dengan 20. Itulah biaya per tugas Anda.
- Ulangi dengan model lain dan bandingkan kedua hasilnya.
Untuk eksekusi yang lebih panjang, melacak biaya token agen di Python menambahkan anggaran dan penghentian pada ide yang sama, dan berapa banyak token yang dipakai sebuah permintaan menunjukkan ukuran tipikal untuk memulai.
Pemeriksaan cepat#
Cek cepat
Model B berbiaya setengah per token dibanding model A. Kapan B masih bisa lebih mahal per tugas yang selesai?
Tampilkan jawaban
Jawaban: Ketika ia butuh lebih banyak percobaan atau menulis jawaban jauh lebih panjang
Biaya per tugas = percobaan × token × harga. Setengahkan harganya, tiga kalikan percobaannya, dan Anda membayar 1,5 kali lipat.
Selanjutnya, token input vs output menjelaskan mengapa kedua sisi diberi harga berbeda, dan dokumentasi membawa Anda dari kunci ke permintaan pertama.


