AI cho người mớiHướng dẫn
Giá trên 1M token so với chi phí mỗi tác vụ: cách so sánh các mô hình AI
Một mô hình có giá trên 1M token thấp hơn vẫn có thể tốn hơn mỗi tác vụ đã hoàn thành. Học cách tính chi phí mỗi tác vụ từ token vào, token ra và số lần thử.
Trên trang này
So sánh các mô hình theo chi phí của một tác vụ đã hoàn thành, chứ không phải theo giá trên 1M token. Một tác vụ tốn tokens in × giá đầu vào + tokens out × giá đầu ra, nhân với số lần thử cần thiết. Vì vậy, một mô hình có giá mỗi token bằng một nửa vẫn có thể khiến bạn phải trả hóa đơn lớn hơn.
Đó là điều bất ngờ thường gặp: agent đã chạy xong, bảng giá trông rẻ, và hóa đơn lại lớn hơn mức tác vụ đáng ra phải tốn. Hãy cùng tìm xem sự khác biệt nằm ở đâu.
Giá mỗi token là giá mỗi kilo#
Giá mỗi kilo bột mì chẳng nói gì về chi phí bữa tối. Bạn cần biết công thức cần bao nhiêu kilo, và liệu bạn có làm cháy mẻ đầu tiên rồi phải làm lại không.
Các mô hình AI cũng vậy. Giá trên 1M token là giá mỗi kilo. Tác vụ là bữa tối. Mỗi yêu cầu được tính tiền ở hai phía: các token bạn gửi đi (đầu vào) và các token mô hình viết trả lại (đầu ra). Cả hai con số đều được trả về trong trường usage của mọi phản hồi từ một API tương thích OpenAI như CheapTokens API tại https:/ (kiểm tra ngày 29 tháng 10 năm 2026), nên bạn không bao giờ phải đoán chúng.
Đây là toàn bộ công thức:
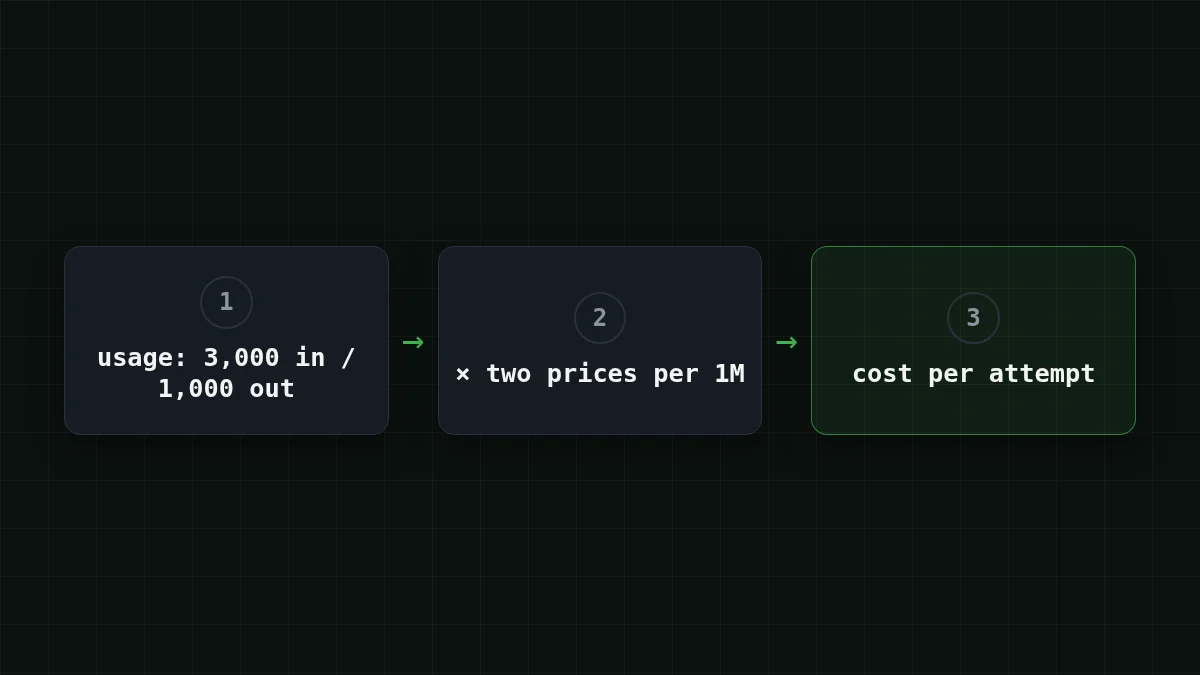
cost per task = attempts × (tokens in × input price + tokens out × output price)Giả sử một tác vụ gửi 3.000 token và nhận lại 1.000. Mô hình A có giá $1 trên 1M token cho đầu vào và $5 cho đầu ra. Mô hình B bằng một nửa: $0,50 và $2,50. (Đây là những mức giá tròn bịa ra để tính tổng, không phải bảng giá của ai cả.)
Mô hình A, một lần thử:
- 3.000 × $1 ÷ 1.000.000 = $0,003 cho đầu vào
- 1.000 × $5 ÷ 1.000.000 = $0,005 cho đầu ra
- $0,003 + $0,005 = $0,008 mỗi tác vụ
Mô hình B trông như món hời. Nhưng giả sử nó cần ba lần thử để có kết quả dùng được, và mỗi lần thử đều tốn như nhau:
- 3.000 × $0,50 ÷ 1.000.000 = $0,0015 cho đầu vào
- 1.000 × $2,50 ÷ 1.000.000 = $0,0025 cho đầu ra
- $0,0015 + $0,0025 = $0,004 mỗi lần thử
- 3 × $0,004 = $0,012 mỗi tác vụ
Giá mỗi token bằng một nửa, giá mỗi tác vụ gấp rưỡi. Điều tương tự cũng xảy ra mà không cần thử lại nếu B chỉ đơn giản viết câu trả lời dài hơn: với 3.000 token đầu ra trong một lần thử, 3.000 × $2,50 ÷ 1.000.000 = $0,0075, và $0,0015 + $0,0075 = $0,009. Vẫn nhiều hơn $0,008 của A.
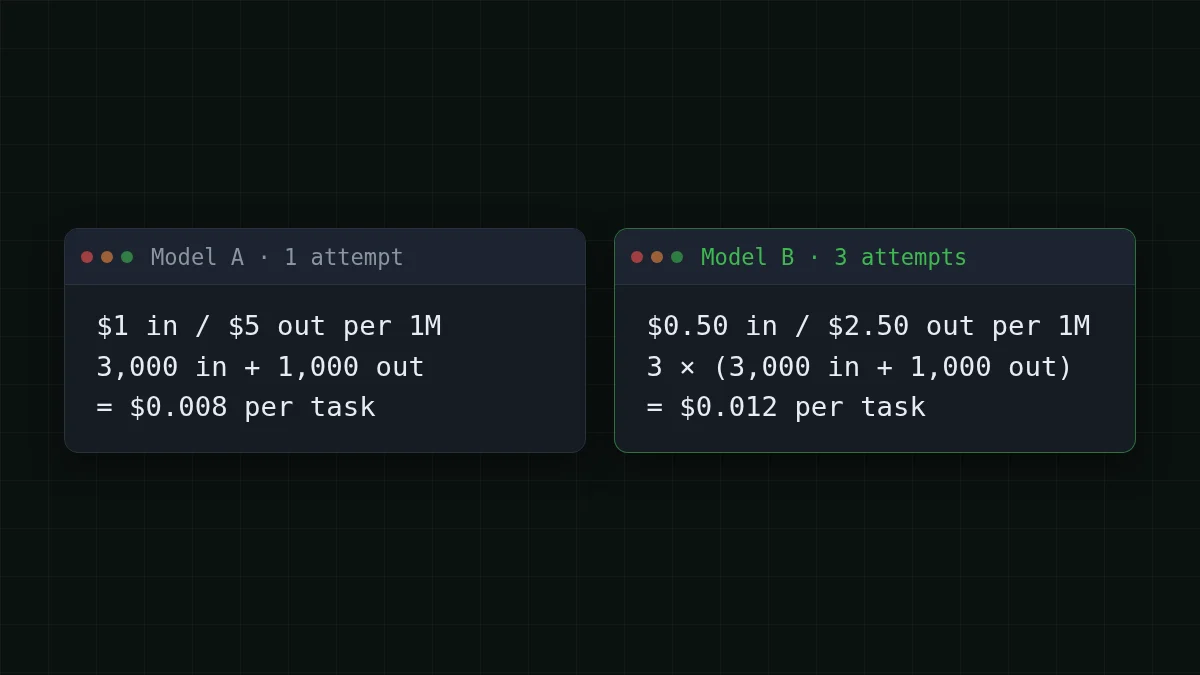
Và điều ngược lại cũng đúng. Nếu B làm đúng ngay lần đầu, nó tốn $0,004 mỗi tác vụ, bằng một nửa của A. Giá mỗi token chỉ thắng khi số lượng token và số lần thử xấp xỉ bằng nhau. Đó chính là điều cần kiểm tra.
Thẻ ghi nhớ
Những từ bạn sẽ gặp trong mọi tài liệu API
Nhấn vào thẻ để lật
Số token mỗi tác vụ thực sự đi đâu#
Ba thứ làm thay đổi số lượng token, và không thứ nào trong số đó xuất hiện trên bảng giá.
- Độ dài câu trả lời. Một mô hình giải thích dài dòng sẽ viết nhiều token đầu ra hơn một mô hình trả lời trong một dòng.
- Thử lại. Một câu trả lời thất bại hoặc không dùng được vẫn tốn token, và lần thử tiếp theo lại phải trả tiền lần nữa.
- Ngữ cảnh gửi lại. API không ghi nhớ: mỗi bước của agent lại gửi hướng dẫn, tệp và lịch sử một lần nữa. Nếu đây là điều mới, vì sao một cuộc trò chuyện dài tốn hơn sẽ giải thích cơ chế.
Điều thứ ba là điều lớn nhất đối với agent. Lấy một coding agent làm việc trong 20 bước. Giả sử một bước agent nặng: 20.000 token vào và 1.000 trả lại. Để xem một lần chạy nhẹ hơn với số liệu thực tế từng bước, xem vì sao AI agent dùng nhiều token đến vậy. Câu trả lời ngắn. Đầu vào thì không.
Đoán số
Một agent 20 bước gửi tổng cộng bao nhiêu token đầu vào, nếu mỗi bước gửi 20.000?
Dự đoán của bạn
01.000.000
Hiện đáp án
Trả lời: 400.000
20 × 20.000 = 400.000. Mỗi bước gửi lại ngữ cảnh, nên đầu vào cứ chồng chất lên dù mỗi câu trả lời đều ngắn.
Vậy với công việc này, phía đầu vào quyết định hóa đơn, còn phía đầu ra hầu như không quan trọng. Một mô hình có giá đầu vào rẻ có thể thắng ở đây ngay cả khi giá đầu ra của nó trông bình thường. Đó là điều mà bảng giá chỉ cho bạn thấy khi bạn đọc nó với chính tác vụ của mình trong đầu.
Đây là chính công việc đó, 20 bước với 20.000 vào và 1.000 ra, trên các mô hình có sẵn tại CheapTokens. Bảng này là trực tiếp, nên các con số theo giá hiện tại, và cột OpenRouter có ở đó để so sánh. Khi tính cả đầu vào và đầu ra, cả ba đều rẻ hơn OpenRouter về tổng cộng.
| Mô hình | Đầu vào $/1M | Đầu ra $/1M | Mỗi yêu cầu | 20 yêu cầu | OpenRouter, 20 yêu cầu |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00044 | $0.0088 | $0.0151 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0004 | $0.008 | $0.0308 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0012 | $0.023 | $0.276 |
20.000 token đầu vào và 1.000 token đầu ra mỗi yêu cầu. Giá trên 1 triệu token là giá hiện hành và thay đổi cùng với biểu phí của chúng tôi; cột OpenRouter hiển thị giá tham chiếu cho cùng khối lượng công việc.
Với các vòng lặp agent như thế này, DeepSeek-V4-Flash là lựa chọn tự nhiên: ngữ cảnh 380K, tối đa 32.768 token đầu ra mỗi câu trả lời, và một mức giá vào bất kỳ thời điểm nào trong ngày, nên một lần chạy ban đêm tốn bằng một lần chạy ban ngày. Toàn bộ công việc qua cả 20 bước trên nó tốn $0.008. Xem trang mô hình để biết chi tiết và bảng giá cho mọi mô hình.
Chatbot là câu chuyện ngược lại#
Giờ lấy một bot hỗ trợ. Giả sử nó nhận 1.000 yêu cầu mỗi ngày, và mỗi yêu cầu là một câu hỏi 2.000 token kèm ngữ cảnh và một câu trả lời 500 token. Không vòng lặp, không lịch sử tăng dần, một lần thử.
Ở đây giá mỗi token gần như chính là chi phí mỗi tác vụ, vì không có gì nhân nó lên. Trên GLM-5.3-Flash, với ngữ cảnh 390K và tối đa 8.192 token đầu ra mỗi câu trả lời, một yêu cầu tốn $0.00006 và cả ngày 1.000 yêu cầu tốn $0.06.
Vậy quy tắc ngón tay cái rất đơn giản. Một tác vụ ngắn, một lần: giá mỗi token là hướng dẫn hợp lý. Một vòng lặp, một công việc dễ phải thử lại hoặc một công việc có câu trả lời dài: hãy tính giá cho cả tác vụ trước khi chọn.
Đo tác vụ của chính bạn trong mười phút#
Con số của chính bạn tốt hơn mọi ví dụ ở đây. Đoạn script dưới đây gửi một yêu cầu và in ra những gì nó thực sự dùng và chi phí của việc đó. Các mức giá trong đó là ví dụ: hãy thay bằng mức giá hiện tại từ bảng giá.
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1", api_key="YOUR_KEY")

# example prices per 1M tokens, substitute current ones
PRICE_IN, PRICE_OUT = 1.00, 5.00

resp = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Summarize this ticket in one sentence: <your text>"}],
    max_tokens=300,
)
u = resp.usage
cost = (u.prompt_tokens * PRICE_IN + u.completion_tokens * PRICE_OUT) / 1_000_000
print(u.prompt_tokens, u.completion_tokens, round(cost, 6))
Khi nó chạy được, bạn nhận được ba con số trên một dòng: token vào, token ra và chi phí của lần thử đó. Sau đó:
- Chạy 20 tác vụ thật của bạn, không phải tác vụ đồ chơi.
- Cộng chi phí của mọi lần thử, kể cả những lần bạn đã bỏ đi.
- Chia cho 20. Đó là chi phí mỗi tác vụ của bạn.
- Lặp lại với mô hình kia và so sánh hai kết quả.
Để chạy lâu hơn, theo dõi chi phí token của agent bằng Python thêm ngân sách và điểm dừng vào cùng ý tưởng đó, và một yêu cầu dùng bao nhiêu token cho thấy các kích thước điển hình để bắt đầu.
Kiểm tra nhanh#
Kiểm tra nhanh
Mô hình B có giá mỗi token bằng một nửa mô hình A. Khi nào B vẫn có thể tốn hơn mỗi tác vụ đã hoàn thành?
Hiện đáp án
Trả lời: Khi nó cần nhiều lần thử hơn hoặc viết câu trả lời dài hơn nhiều
Chi phí mỗi tác vụ = số lần thử × token × giá. Giảm giá một nửa, tăng số lần thử gấp ba và bạn trả gấp 1,5 lần.
Tiếp theo, token đầu vào so với đầu ra giải thích vì sao hai phía được định giá khác nhau, và tài liệu đưa bạn từ một khóa đến yêu cầu đầu tiên.


