Tin tức AICập nhật
Giá API Meta Muse Ember: $0.10 / $0.50, ngữ cảnh 1M
Muse Ember của Meta: các mức giá, ngữ cảnh 1M, đầu ra 512K, và chi phí một phiên agent 50 bước, cùng một lựa chọn tác vụ con rẻ.
Trên trang này
Muse Ember mới của Meta là một mô hình nhỏ được xây dựng cho các bước lặp đi lặp lại, rẻ tiền bên trong một agent, và theo thông báo của Meta, nó có giá $0.10 cho đầu vào và $0.50 cho đầu ra trên mỗi 1M token với prompt lên tới 200K token. Trên 200K, giá tăng gấp ba. Một phiên agent 50 bước với 20K token vào và 500 ra mỗi bước tốn khoảng $0.11 trên Ember, và vai trò tương tự cũng mở ra cho bạn tại CheapTokens với DeepSeek-V4-Flash.
Mô hình được công bố vào ngày 9 tháng 11 năm 2026 trên blog nghiên cứu của Meta (research.meta.ai/blog/muse-ember); bài đăng có ngày nhưng không có giờ. Chúng tôi đã kiểm tra blog và trang mô hình tại dev.meta.ai vào ngày 10 tháng 11 năm 2026.
Meta đã công bố gì#
Muse Ember (model id muse-ember-1.0) là mô hình nhỏ nhất và hiệu quả nhất trong dòng Muse của Meta, hướng tới các tác vụ con của agent: gọi công cụ, trích xuất, định tuyến, phân tích tài liệu dài. Bạn có thể truy cập nó trong Muse Code, Meta Model API (chỉ chế độ Standard), Google Cloud và Oracle Cloud. Meta không công bố trọng số mở, nên API và Muse Code là con đường truy cập. Các khu vực không được nêu.
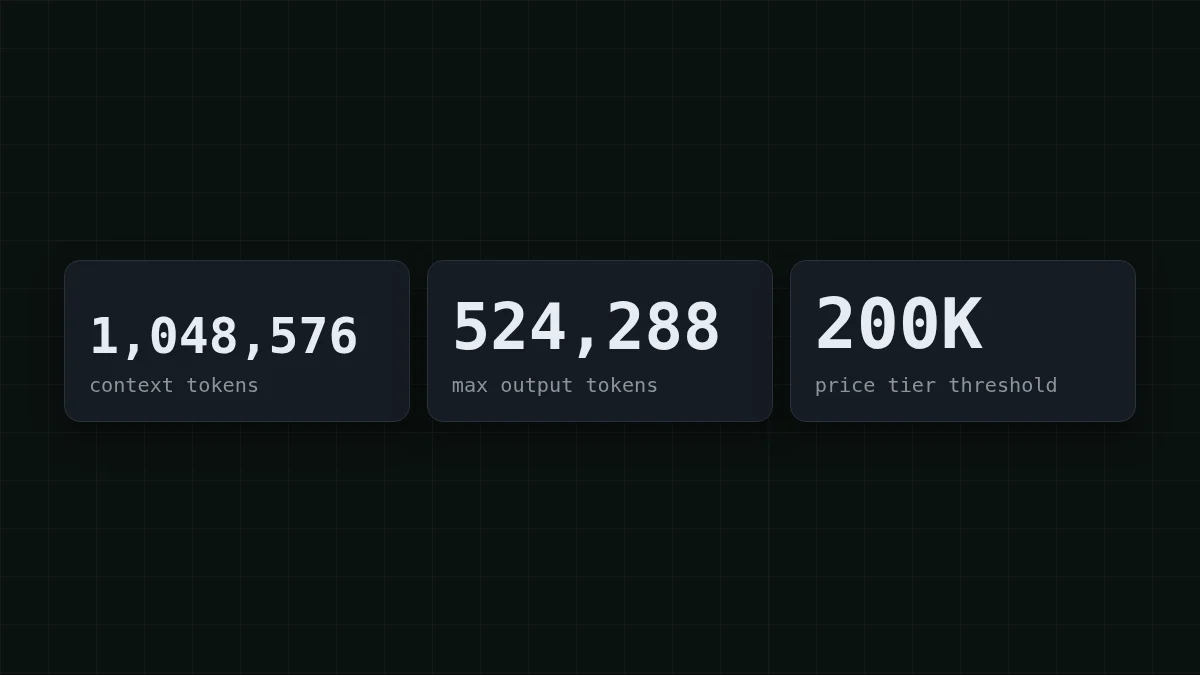
Các giới hạn từ trang mô hình của Meta (dev.meta.ai/docs/muse-ember, trang không có ngày). Cửa sổ ngữ cảnh — 1.048.576 token, đầu ra tối đa — 524.288 token, và mức giá cao hơn bắt đầu trên 200K token prompt.
Nó nhận văn bản, hình ảnh, video, âm thanh và PDF làm đầu vào và trả về văn bản. Bạn có thể gọi nó qua các endpoint Responses, Chat Completions hoặc Messages, với gọi công cụ, đầu ra có cấu trúc, sử dụng máy tính, hiểu hình ảnh và search grounding. Mức nỗ lực suy luận chạy từ minimal đến max, và mặc định là max. Streaming không được đề cập trên trang, nên chúng tôi sẽ không khẳng định điều đó.
Meta cũng công bố các con số benchmark, và chúng là của Meta, chủ yếu ở mức suy luận max: Terminal-Bench 4.0 đạt 40,9% so với 39,2% của Haiku 5.5, AutomationBench-AA đạt 37,8% so với 13,9% và 20,2% của hai mô hình còn lại mà Meta liệt kê, và FrontierCode 2.0-AA đạt 27,2%, đứng sau Haiku 5.5 với 34,9%. Trên Artificial Analysis Intelligence Index, nó đạt 36 so với 37 của Muse Spark 1.3. Hãy coi chúng là tuyên bố của nhà cung cấp cho đến khi bạn chạy các trường hợp của riêng mình.
Một phiên 50 bước tốn bao nhiêu trên Ember#
Bảng giá, theo thông báo của Meta (bản thân trang mô hình trỏ đến một trang giá không có số liệu):
Cuộn bảng sang phải →
| Kích thước prompt | Đầu vào | Đầu vào đã cache | Đầu ra |
|---|---|---|---|
| lên tới 200K token | $0.10 | $0.004 | $0.50 |
| trên 200K token | $0.30 | $0.012 | $1.50 |
Giá tính trên mỗi 1M token, kiểm tra ngày 10 tháng 11 năm 2026. Các nguồn thứ cấp mô tả quy tắc trên 200K khác nhau, nên hãy xác nhận trên trang giá của Meta trước khi lập ngân sách dựa vào đó.
Giờ đến một phiên. Giả sử agent của bạn thực hiện 50 bước, và mỗi bước gửi khoảng 20K token (lịch sử đang tăng cộng với kết quả công cụ) và nhận về khoảng 500 token. Tổng cộng là 1M token vào và 25K ra. Trên Ember: 1 × $0.10 + 0,025 × $0.50 = $0,1125 (số token tính bằng triệu). Phía đầu vào gần như là toàn bộ hóa đơn, đó là lý do giá đầu vào đã cache $0.004 quan trọng nếu agent của bạn giữ nguyên tiền tố.
Đoán số
Giả sử mức giá cao hơn áp dụng cho toàn bộ prompt (cách diễn đạt của Meta đọc là như vậy). Đầu vào của một prompt 250K token tốn bao nhiêu cent trên Ember?
Dự đoán của bạn
020
Hiện đáp án
Trả lời: 7,5
Nếu mức giá cao hơn áp dụng cho toàn bộ prompt: 250.000 × $0.30 trên 1M = $0,075, tức 7,5 cent chỉ cho đầu vào. Năm mươi bước như vậy sẽ là $3,75 đầu vào.
Tại sao lại có prompt dài? Bởi vì agent gửi lại lịch sử ở mỗi bước; nếu điều đó mới với bạn, tại sao một agent đọc lại toàn bộ lịch sử của nó giải thích bằng một ví dụ nhỏ.
Prompt của bạn thuộc mức giá nào?#
Mốc 200K là mốc cần chú ý. Meta niêm yết mức giá cao gấp ba cho prompt dài hơn: $0.30 cho đầu vào, $0.012 cho đầu vào đã cache và $1.50 cho đầu ra.
Chọn trường hợp của bạn
Yêu cầu lớn nhất của agent của bạn nằm ở đâu?
Chọn một tùy chọn để xem đáp án
Dưới 200K token
Bạn ở mức giá thấp hơn. Lập ngân sách với $0.10 vào / $0.50 ra và chú ý phía đầu ra nếu bạn giữ mức nỗ lực suy luận ở mặc định.
Từ 200K đến 1M token
Mức giá cao hơn áp dụng, và cửa sổ 1.048.576 token của Ember vẫn vừa với bạn. Cắt bớt đầu ra công cụ cũ trước khi nó vượt 200K, hoặc chia nhỏ công việc để chỉ một bước mang toàn bộ tài liệu.
Trên 1M token
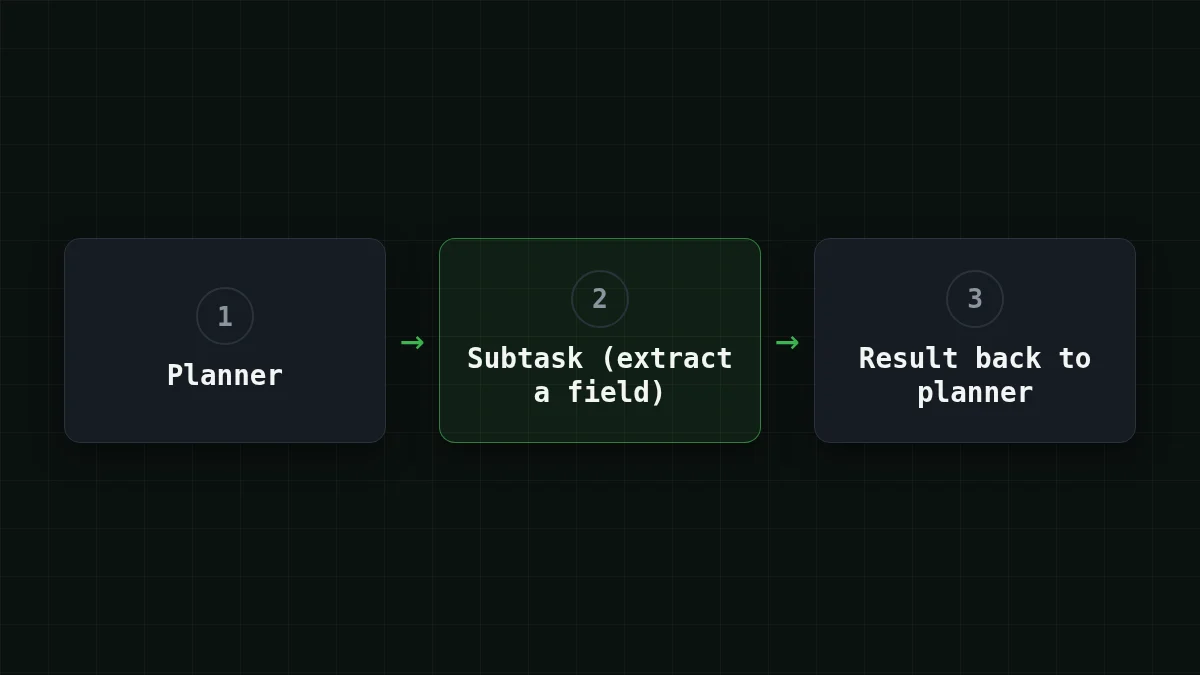
Nó không vừa một yêu cầu. Chia nhỏ đầu vào và để một planner hợp nhất các kết quả.
Vai trò tác vụ con rẻ tiền tương tự tại CheapTokens#
Một bố cục agent phổ biến giữ một mô hình lớn hơn cho việc lập kế hoạch và gửi các tác vụ con lặp lại cho một mô hình rẻ. Cho vị trí thứ hai đó, CheapTokens có DeepSeek-V4-Flash: ngữ cảnh 380K, tối đa 32.768 token đầu ra mỗi câu trả lời, một mức giá bất kể thời điểm trong ngày không có giờ cao điểm, API tương thích OpenAI và Anthropic, và một số dư chung cho tất cả mô hình. GLM-5.3-Flash là lựa chọn khác cho các vòng gọi công cụ và phân tích tài liệu dài, với ngữ cảnh 390K và tối đa 8.192 token đầu ra. Chạy 20 tác vụ con của riêng bạn trên DeepSeek-V4-Flash và so sánh kết quả theo trường usage.
Đây là cùng phiên 50 bước, 20K token vào và 500 ra mỗi bước, được định giá trực tiếp:
| Mô hình | Đầu vào $/1M | Đầu ra $/1M | Mỗi yêu cầu | 50 yêu cầu | OpenRouter, 50 yêu cầu |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00042 | $0.021 | $0.0356 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00035 | $0.0175 | $0.0735 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0011 | $0.0538 | $0.645 |
20.000 token đầu vào và 500 token đầu ra mỗi yêu cầu. Giá trên 1 triệu token là giá hiện hành và thay đổi cùng với biểu phí của chúng tôi; cột OpenRouter hiển thị giá tham chiếu cho cùng khối lượng công việc.
Dòng DeepSeek-V4-Flash cho toàn bộ phiên là $0.0175; tổng cộng, tính cả đầu vào và đầu ra, nó rẻ hơn giá tham chiếu của OpenRouter cho cùng mô hình. Giá trên trang này tự cập nhật.
Dùng thử chỉ cần một yêu cầu. Khóa được đặt trong một biến môi trường, và model id là id đầy đủ từ tài liệu (tài liệu có danh sách; giá là mức giá hiện tại):
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Extract the order number from: Order #48213 shipped today."}],
    "max_tokens": 100
  }'
Phản hồi có đối tượng usage thông thường, nên bạn có thể đọc số token đầu vào và đầu ra thực tế của tác vụ con và đưa vào bảng trên. Về bản thân mẫu định tuyến, xem định tuyến mô hình: mô hình rẻ trước, nâng cấp sau và, để biết thêm về mô hình, DeepSeek trên CheapTokens.
Chú ý phía đầu ra#
Mức nỗ lực suy luận mặc định của Ember là max, và các con số benchmark của chính Meta chủ yếu được chạy theo cách đó. Một tác vụ con chỉ cần lấy một trường ra khỏi tài liệu không cần đến nó, và mức nỗ lực suy luận cao hơn có thể nghĩa là nhiều token đầu ra hơn, phía đắt hơn. Các trang của Meta không nói cách tính token suy luận, nên hãy đọc usage thay vì giả định.
Tự mình thử xemThử xem: làm sao bạn biết một tác vụ con thực sự tốn bao nhiêu?Hiện đáp án
Gửi 20 tác vụ con thực tế ở mức nỗ lực thấp nhất, rồi ở mặc định, và đọc usage trong mỗi phản hồi. Nhân trung bình đầu vào và đầu ra với số bước mỗi ngày của bạn và tính chi phí theo giá của Ember từ bảng trên. Nếu câu trả lời khớp trên các trường hợp của bạn, mức cài đặt rẻ hơn là mức nên giữ. Lý do điều đó hiệu quả nằm trong mức nỗ lực suy luận và token suy nghĩ.
Cách hiểu thực tế cho người xây dựng: Ember được định giá cho vị trí rẻ trong một agent, mốc 200K là con số để thiết kế xoay quanh, và con số duy nhất quyết định là con số từ trường usage của chính bạn.


