Tối ưu chi phíHướng dẫn
Định tuyến mô hình để cắt giảm chi phí API: mô hình rẻ trước, chuyển cấp
Gửi các yêu cầu dễ đến một mô hình rẻ và chỉ chuyển cấp những yêu cầu khó. Xem chi phí hỗn hợp của 10.000 yêu cầu ở mức chuyển cấp 10%, 30% và 50%, cùng một bộ định tuyến Python ngắn.
Trên trang này
Định tuyến có thể cắt giảm hóa đơn khi lượt chạy đầu tiên của mô hình rẻ rẻ hơn nhiều so với mô hình thứ hai và ít yêu cầu được chuyển cấp: gửi mọi yêu cầu đến mô hình rẻ trước và chỉ gửi lại những yêu cầu khó cho mô hình thứ hai. Việc bạn có thực sự tiết kiệm hay không phụ thuộc vào tỷ lệ yêu cầu bạn chuyển cấp. Dưới đây là phép tính cho 10.000 yêu cầu ở mức 10%, 30% và 50%, cùng một hàm Python bạn có thể dán vào dự án của mình.
Mô hình này không mới. Bài đăng kỹ thuật của Anthropic "Building effective agents" (19 tháng 12 năm 2024) gọi đây là quy trình định tuyến: các câu hỏi phổ biến, dễ đi đến một mô hình nhỏ hơn, tiết kiệm chi phí hơn, và những câu hỏi bất thường, khó đi đến một mô hình có năng lực hơn. Bài đăng không đưa ra giá, nên các con số ở đây là của chúng tôi, dựa trên giá trực tiếp của CheapTokens.
Yêu cầu nào của bạn là dễ?#
Định tuyến chỉ hiệu quả nếu bạn có thể nói, bằng một quy tắc, "khó" nghĩa là gì. Không phải bằng cảm giác, mà bằng một quy tắc mà mã có thể kiểm tra. Chọn trường hợp gần nhất với bạn:
Chọn trường hợp của bạn
Chọn trường hợp của bạn
Chọn một tùy chọn để xem đáp án
Chatbot hỗ trợ
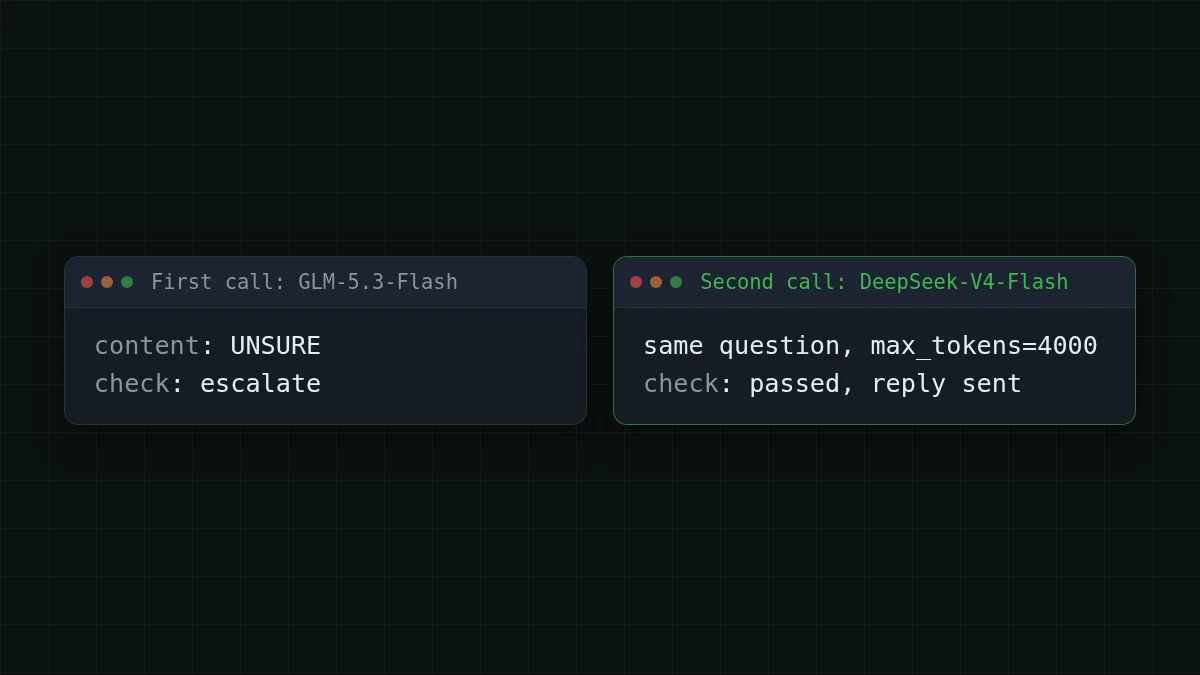
Hầu hết các ticket là câu hỏi ngắn: đơn hàng của tôi ở đâu, làm sao để đặt lại mật khẩu. Một số ít cần câu trả lời dài, cẩn thận. Dễ: mô hình đầu tiên trả lời và không trả lời UNSURE. Khó: nó nói UNSURE, hoặc câu trả lời bị cắt (finish_reason là length).
Quy trình tài liệu
Mọi tài liệu đều qua bước trích xuất trước. Dễ: kết quả phân tích cú pháp thành JSON hợp lệ với tất cả các trường bắt buộc. Khó: phân tích cú pháp thất bại hoặc một trường trống. Chỉ những tài liệu đó mới được chạy lại trên mô hình thứ hai.
Tác nhân lập trình
Các chỉnh sửa đơn giản đi đến mô hình rẻ. Chuyển cấp một bước khi cùng một bước thất bại hai lần liên tiếp, hoặc khi câu trả lời bị cắt (finish_reason là length).
Đừng chuyển cấp khi "mô hình có vẻ không chắc chắn" trừ khi bạn đã bảo nó cách nói điều đó. Một chỉ dẫn một dòng ("trả lời chính xác UNSURE nếu bạn không thể trả lời") biến một cảm giác thành thứ mà if có thể đọc.
10.000 yêu cầu tốn bao nhiêu: thác nước so với bộ định tuyến#
Giả sử bạn chạy một bot hỗ trợ với 10.000 yêu cầu mỗi tháng. Một yêu cầu trung bình là 800 token đầu vào và 300 token đầu ra. Đây là các giả định; hãy thay bằng số của bạn từ usage (bài viết về đếm token của chúng tôi chỉ ra nơi đọc chúng).
Có hai cách để nối định tuyến, và chúng tính phí khác nhau:
- Thác nước. Mọi yêu cầu đi đến mô hình rẻ. Một tỷ lệ p không vượt qua kiểm tra và được gửi lại cho mô hình thứ hai. Những yêu cầu đó bị tính phí hai lần: chi phí = N × [rẻ + p × thứ hai].
- Bộ định tuyến. Một lệnh gọi phân loại nhỏ quyết định trước. Những yêu cầu dễ đi đến mô hình rẻ, những yêu cầu khó đi thẳng đến mô hình thứ hai: chi phí = N × [(1 − p) × rẻ + p × thứ hai], cộng với bộ phân loại trên mọi yêu cầu.
Chúng ta sẽ dùng thác nước, vì nó không cần bộ phân loại và là cách dễ bắt đầu hơn. Lượt đầu tiên là GLM-5.3-Flash (zai-, ngữ cảnh 390K, tối đa 8.192 token đầu ra). Lượt thứ hai là DeepSeek-V4-Flash bản phát hành 0731 (deepseek-, ngữ cảnh 380K, tối đa 32.768 token đầu ra), nên một câu trả lời không vừa trong 8.192 token có chỗ để hoàn thành. Cả hai đều rẻ hơn OpenRouter tổng cộng, với đầu vào và đầu ra được tính cùng nhau; bảng trực tiếp bên dưới hiển thị cột OpenRouter bên cạnh cột của chúng tôi.
Lượt đầu tiên luôn bao phủ tất cả 10.000 yêu cầu: 8.000.000 đầu vào và 3.000.000 token đầu ra. Lượt thứ hai chỉ bao phủ tỷ lệ được chuyển cấp. Cột cuối cùng là phương án thay thế: tất cả 10.000 yêu cầu đi thẳng trên mô hình thứ hai.
Cuộn bảng sang phải →
| Tỷ lệ chuyển cấp | Token lượt thứ hai (vào / ra) | Lượt đầu, tất cả 10.000 | Lượt thứ hai, chỉ chuyển cấp | Tất cả trên mô hình thứ hai, tất cả 10.000 |
|---|---|---|---|---|
| 10% | 800.000 / 300.000 | $0.28 | $0.042 | $0.42 |
| 30% | 2.400.000 / 900.000 | $0.28 | $0.126 | $0.42 |
| 50% | 4.000.000 / 1.500.000 | $0.28 | $0.21 | $0.42 |
Cộng các cột lượt đầu và lượt thứ hai trong mỗi hàng để có tháng của thác nước, sau đó so sánh tổng đó với cột cuối cùng. Lượt đầu là chi phí cố định, và chỉ lượt thứ hai tăng theo p. Đó là toàn bộ câu chuyện của một thác nước: bạn càng chuyển cấp nhiều, bạn càng tiến gần đến việc trả tiền cho công việc hai lần.
Đây là cùng tải cho mọi mô hình cùng một lúc, để bạn có thể thấy các tùy chọn một mô hình nằm ở đâu:
| Mô hình | Đầu vào $/1M | Đầu ra $/1M | Mỗi yêu cầu | 10.000 yêu cầu | OpenRouter, 10.000 yêu cầu |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.28 | $0.517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.42 | $0.98 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.85 | $10.20 |
800 token đầu vào và 300 token đầu ra mỗi yêu cầu. Giá trên 1 triệu token là giá hiện hành và thay đổi cùng với biểu phí của chúng tôi; cột OpenRouter hiển thị giá tham chiếu cho cùng khối lượng công việc.
Khi nào thác nước không đáng? Khi lượt đầu cộng với tỷ lệ chuyển cấp tốn nhiều hơn gửi mọi thứ đến mô hình thứ hai. Theo ký hiệu: rẻ + p × thứ hai < thứ hai, nghĩa là p < 1 − rẻ/thứ hai. Đối với cặp này, lượt đầu tốn một phần đáng kể của giá mô hình thứ hai trên tải này, nên lợi ích từ thác nước giảm đi, và ở tỷ lệ chuyển cấp cao thì nó biến mất. Ở mức 50%, thác nước có thể thua so với việc chỉ gửi tất cả 10.000 yêu cầu đến mô hình thứ hai, vì vậy hãy kiểm tra tổng của hai lượt so với cột cuối cùng trước khi cam kết. Tỷ lệ phụ thuộc vào hỗn hợp đầu vào/đầu ra của bạn, vì hai mô hình định giá hai bên khác nhau, nên hãy đọc nó từ hàng của chính bạn.
Biến thể bộ định tuyến thêm một thứ: bộ phân loại. Giả sử nó đọc 300 token đầu vào và trả lời trong 5 token trên mô hình rẻ, mỗi yêu cầu. Với 10.000 yêu cầu, đó là 3.000.000 đầu vào và 50.000 token đầu ra, tức $0.062 mỗi tháng thêm vào. So sánh dòng này với tỷ lệ p của cột lượt đầu (10%, 30% hoặc 50% của nó): đó là những gì thác nước lãng phí bằng cách chạy lượt đầu trên các yêu cầu sau đó được chuyển cấp. Nếu dòng bộ phân loại lớn hơn, thác nước là khởi đầu rẻ hơn; nếu nhỏ hơn, bộ định tuyến tiết kiệm hơn.
Hãy thử số của riêng bạn trước khi xây dựng bất cứ thứ gì:
Máy tính chi phí
Một tháng của bot hỗ trợ, mọi thứ trên một mô hình
Token đầu vào mỗi yêu cầu: 800 · Token đầu ra mỗi yêu cầu: 300 · Số yêu cầu mỗi ngày: 10.000
| Mô hình | Mỗi ngày | Mỗi tháng |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.28 | $8.40 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.42 | $12.60 |
| MiniMax-M2.7$0.05$0.15 | $0.85 | $25.50 |
Thay đổi runs thành khối lượng của bạn và đọc tổng cho mỗi mô hình. Sau đó dùng bảng trên để xem lượt thứ hai sẽ thêm bao nhiêu.
Một bộ định tuyến trong Python: hai lệnh gọi và một kiểm tra#
Cả hai mô hình nằm sau một URL cơ sở tương thích OpenAI và một số dư, nên định tuyến không cần tài khoản hay khóa thứ hai. Mã bên dưới là một ví dụ: các con số trong đó (max_tokens, quy tắc UNSURE) là của bạn để tinh chỉnh. Lệnh gọi thứ hai nhận max_tokens cao hơn, nên một câu trả lời bị cắt ở 600 token có thể hoàn thành. URL cơ sở, id mô hình và phần còn lại có trong tài liệu CheapTokens.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CHEAP = 'zai-org/GLM-5.3-Flash'
SECOND = 'deepseek-ai/DeepSeek-V4-Flash-0731'
SYSTEM = 'Answer briefly. If you cannot answer well, reply exactly UNSURE.'


def ask(model, question, max_tokens):
    r = client.chat.completions.create(
        model=model,
        max_tokens=max_tokens,
        messages=[
            {'role': 'system', 'content': SYSTEM},
            {'role': 'user', 'content': question},
        ],
    )
    choice = r.choices[0]
    return choice.message.content or '', choice.finish_reason


def needs_escalation(text, finish_reason):
    return finish_reason == 'length' or not text.strip() or 'UNSURE' in text


def answer(question):
    text, why = ask(CHEAP, question, 600)
    if needs_escalation(text, why):
        text, why = ask(SECOND, question, 4000)
        if 'UNSURE' in text:
            text = 'Sorry, I could not answer this one.'
    return text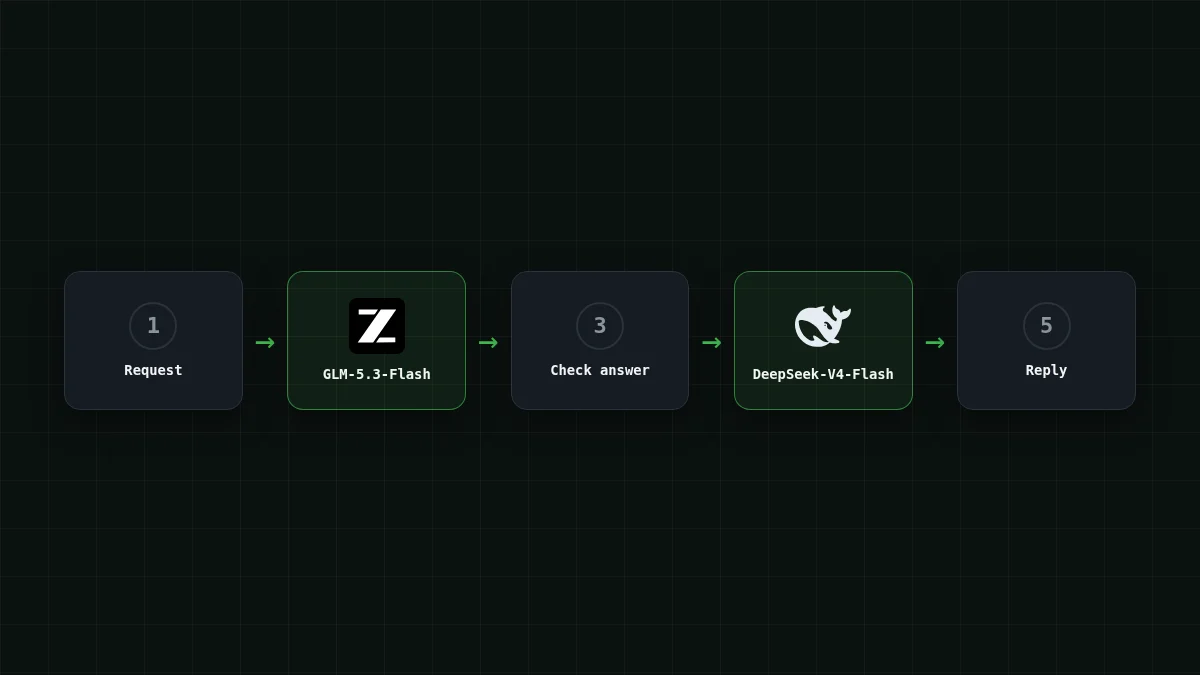
Ba thói quen làm cho điều này trung thực thay vì chỉ rẻ:
- Đếm các lần chuyển cấp. Ghi lại tần suất
needs_escalationkích hoạt. Đó là p của bạn, và đó là con số quyết định liệu thác nước có đáng không. - Chọn mô hình thứ hai trên bộ kiểm tra của riêng bạn. Lấy 50 yêu cầu khó từ nhật ký của bạn, chạy chúng qua cả hai mô hình và chỉ giữ mô hình thứ hai nếu nó sửa được những cái mà mô hình đầu bỏ lỡ. Lợi thế được ghi nhận của nó là giới hạn trả lời 32.768 token, và bộ của riêng bạn cho thấy đó có phải là lợi thế bạn cần không.
- Gửi cùng một yêu cầu, không phải một yêu cầu dài hơn. Nếu bạn dán câu trả lời thất bại vào lệnh gọi thứ hai, bạn trả tiền cho nó như đầu vào. Bắt đầu lượt thứ hai sạch sẽ trừ khi câu trả lời đầu tiên thực sự là ngữ cảnh hữu ích.
Tự kiểm tra#
Kiểm tra nhanh
Trong một thác nước, 30% yêu cầu không vượt qua kiểm tra trên mô hình đầu. Những yêu cầu đó tốn gì?
Hiện đáp án
Trả lời: Giá của mô hình đầu tiên cộng với giá của mô hình thứ hai
Lệnh gọi đầu tiên đã bị tính phí khi bạn vứt bỏ câu trả lời của nó. Các yêu cầu được chuyển cấp trả tiền hai lần, đó là lý do tại sao tỷ lệ p quyết định mọi thứ.
Đi đâu tiếp theo#
Nếu bạn không chắc mô hình nào nên đảm nhận lượt đầu, MiniMax-M2.7 so với DeepSeek-V4-Flash so sánh chúng theo nhiệm vụ. Để có góc nhìn theo nhiệm vụ thay vì theo token, xem giá mỗi 1 triệu token so với chi phí mỗi nhiệm vụ, và đối với các vòng lặp có nhiều bước, cách ước tính chi phí của một tác nhân AI. Giá trực tiếp cho mọi mô hình có trên trang định giá, và các trang mô hình là DeepSeek và GLM.


