コスト最適化ガイド
APIコストを削減するモデルルーティング:安価なモデルを最初に、エスカレーション
簡単なリクエストは安価なモデルに送り、難しいものだけをエスカレーションします。10%、30%、50%のエスカレーション率での10,000リクエストのブレンドコストと、短いPythonルーターをご覧ください。
ルーティングは、安価なモデルの最初のパスが2番目のモデルよりはるかに安く、エスカレーションされるリクエストが少ない場合にコストを削減できます。すべてのリクエストをまず安価なモデルに送り、難しいものだけを2番目のモデルに再送します。実際に節約できるかどうかは、エスカレーションするリクエストの割合によって決まります。以下は10,000リクエストを10%、30%、50%で処理した場合の計算と、プロジェクトに貼り付けられるPython関数です。
このパターンは新しいものではありません。Anthropicのエンジニアリング記事"Building effective agents"(2024年12月19日)はこれをルーティングワークフローと呼んでいます。一般的で簡単な質問はより小さくコスト効率の良いモデルに、珍しく難しい質問はより高性能なモデルに送るというものです。この記事には価格が記載されていないため、ここでの数値はCheapTokensの実際の価格に基づく独自のものです。
どのリクエストが簡単か?#
ルーティングは、「難しい」とは何かをルールで言える場合にのみ機能します。感覚ではなく、コードがチェックできるルールで定義する必要があります。あなたのケースに最も近いものを選んでください:
ケースを選ぶ
ケースを選択
オプションを選択して答えを表示
サポートチャットボット
ほとんどのチケットは短いFAQです:注文はどこか、パスワードをリセットするにはどうすればよいか。一部は長く慎重な回答が必要です。簡単:最初のモデルが回答し、UNSUREを返さない。難しい:UNSUREと言う、または回答が途切れる(finish_reasonがlengthである)。
ドキュメントパイプライン
すべてのドキュメントはまず抽出を通過します。簡単:結果がすべての必須フィールドを含む有効なJSONとしてパースできる。難しい:パースが失敗するか、フィールドが空である。そのようなドキュメントのみが2番目のモデルで再実行されます。
コーディングエージェント
単純な編集は安価なモデルに送ります。同じステップが2回連続で失敗した場合、または回答が途切れた場合(finish_reasonがlengthである)にステップをエスカレーションします。
「モデルが自信なさげに聞こえる」という理由でエスカレーションしないでください。ただし、そう言う方法を指示した場合を除きます。1行の指示(「回答できない場合は正確にUNSUREと返信してください」)で、雰囲気をifが読めるものに変えられます。
10,000リクエストのコスト:カスケード vs ルーター#
月に10,000リクエストを処理するサポートボットを運用しているとします。平均的なリクエストは入力800トークン、出力300トークンです。これらは仮定です。usageから自分の数値に置き換えてください(トークン数に関する記事に読み取り方法が示されています)。
ルーティングを配線する方法は2つあり、請求が異なります:
- カスケード。 すべてのリクエストが安価なモデルに送られます。割合pがチェックに失敗し、2番目のモデルに再送されます。これらのリクエストは2回支払われます:コスト = N × [安価 + p × 2番目]。
- ルーター。 小さな分類器呼び出しが事前に決定します。簡単なものは安価なモデルに、難しいものは直接2番目のモデルに送られます:コスト = N × [(1 − p) × 安価 + p × 2番目]、さらにすべてのリクエストに分類器のコストが加わります。
ここではカスケードを使用します。分類器が不要で、始めるのが簡単だからです。最初のパスはGLM-5.3-Flash(zai-、390Kコンテキスト、最大8,192出力トークン)です。2番目のパスはDeepSeek-V4-Flashリリース0731(deepseek-、380Kコンテキスト、最大32,768出力トークン)なので、8,192トークンに収まらなかった回答を完了する余地があります。どちらも入力と出力を合計するとOpenRouterより安く、下のライブテーブルにOpenRouterの列が私たちの列の隣に表示されています。
最初のパスは常に10,000リクエストすべてをカバーします:入力8,000,000、出力3,000,000トークン。2番目のパスはエスカレーションされた割合のみをカバーします。最後の列は代替案です:10,000リクエストすべてを直接2番目のモデルに送る場合です。
テーブルを右にスクロールしてください →
| エスカレーション割合 | 2番目のパスのトークン(入力 / 出力) | 最初のパス、10,000すべて | 2番目のパス、エスカレーションのみ | 2番目のモデルですべて、10,000すべて |
|---|---|---|---|---|
| 10% | 800,000 / 300,000 | $0.28 | $0.042 | $0.42 |
| 30% | 2,400,000 / 900,000 | $0.28 | $0.126 | $0.42 |
| 50% | 4,000,000 / 1,500,000 | $0.28 | $0.21 | $0.42 |
各行の最初のパスと2番目のパスの列を合計するとカスケードの月額が得られ、その合計を最後の列と比較します。最初のパスは固定費であり、2番目のパスのみがpに応じて増加します。これがカスケードのすべてです:エスカレーションが増えるほど、作業に対して2回支払うことに近づきます。
以下はすべてのモデルを一度に同じ負荷で処理した場合で、単一モデルの選択肢がどこに位置するかがわかります:
| モデル | 入力 $/1M | 出力 $/1M | リクエストあたり | 10,000 リクエスト | OpenRouter、10,000 リクエスト |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.28 | $0.517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.42 | $0.98 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.85 | $10.20 |
リクエストあたり 800 入力トークンと 300 出力トークン。100万トークンあたりの価格は現行のもので、当社の料金体系に合わせて変動します。OpenRouter 列は同じワークロードの参考価格を示しています。
カスケードが割に合わないのはいつですか?最初のパスとエスカレーションされた割合のコストが、すべてを2番目のモデルに送るコストを超える場合です。記号で表すと:安価 + p × 2番目 < 2番目、つまりp < 1 − 安価/2番目です。このペアでは、この負荷で最初のパスが2番目のモデルの価格の無視できない割合を占めるため、カスケードの利得は縮小し、高いエスカレーション割合では消えます。50%では、カスケードは10,000リクエストすべてを2番目のモデルに送るだけの場合に負ける可能性があるため、コミットする前に2つのパスの合計を最後の列と比較してください。比率は入力/出力の混合に依存します。2つのモデルは入力と出力の価格設定が異なるため、自分の行から読み取ってください。
ルーターバリアントは1つ追加します:分類器です。リクエストごとに、安価なモデルで300入力トークンを読み、5トークンで回答すると仮定します。10,000リクエストでは、3,000,000入力トークンと50,000出力トークン、つまり月額$0.062が追加されます。この行を最初のパスの列の割合p(その10%、30%、50%)と比較してください:それが、カスケードがエスカレーションするリクエストに最初のパスを実行することで無駄にするコストです。分類器の行が大きければカスケードの方が安く始められ、小さければルーターの方が節約できます。
何かを構築する前に自分の数値で試してください:
コスト計算機
サポートボットの1か月、すべてを1つのモデルで
リクエストあたりの入力トークン数: 800 · リクエストあたりの出力トークン数: 300 · 1日あたりのリクエスト数: 10,000
| モデル | 1日あたり | 1か月あたり |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.28 | $8.40 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.42 | $12.60 |
| MiniMax-M2.7$0.05$0.15 | $0.85 | $25.50 |
runsをあなたのボリュームに変更し、各モデルの合計を読み取ります。次に上の表を使って、2番目のパスがどれだけ追加するかを確認してください。
Pythonでのルーター:2つの呼び出しと1つのチェック#
両方のモデルは1つのOpenAI互換ベースURLと1つの残高の背後にあるため、ルーティングに2番目のアカウントやキーは不要です。以下のコードは例です:その中の数値(max_tokens、UNSUREルール)は調整してください。2番目の呼び出しはより高いmax_tokensを取得するため、600トークンで途切れた回答を完了できます。ベースURL、モデルIDなどはCheapTokensドキュメントにあります。
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CHEAP = 'zai-org/GLM-5.3-Flash'
SECOND = 'deepseek-ai/DeepSeek-V4-Flash-0731'
SYSTEM = 'Answer briefly. If you cannot answer well, reply exactly UNSURE.'


def ask(model, question, max_tokens):
    r = client.chat.completions.create(
        model=model,
        max_tokens=max_tokens,
        messages=[
            {'role': 'system', 'content': SYSTEM},
            {'role': 'user', 'content': question},
        ],
    )
    choice = r.choices[0]
    return choice.message.content or '', choice.finish_reason


def needs_escalation(text, finish_reason):
    return finish_reason == 'length' or not text.strip() or 'UNSURE' in text


def answer(question):
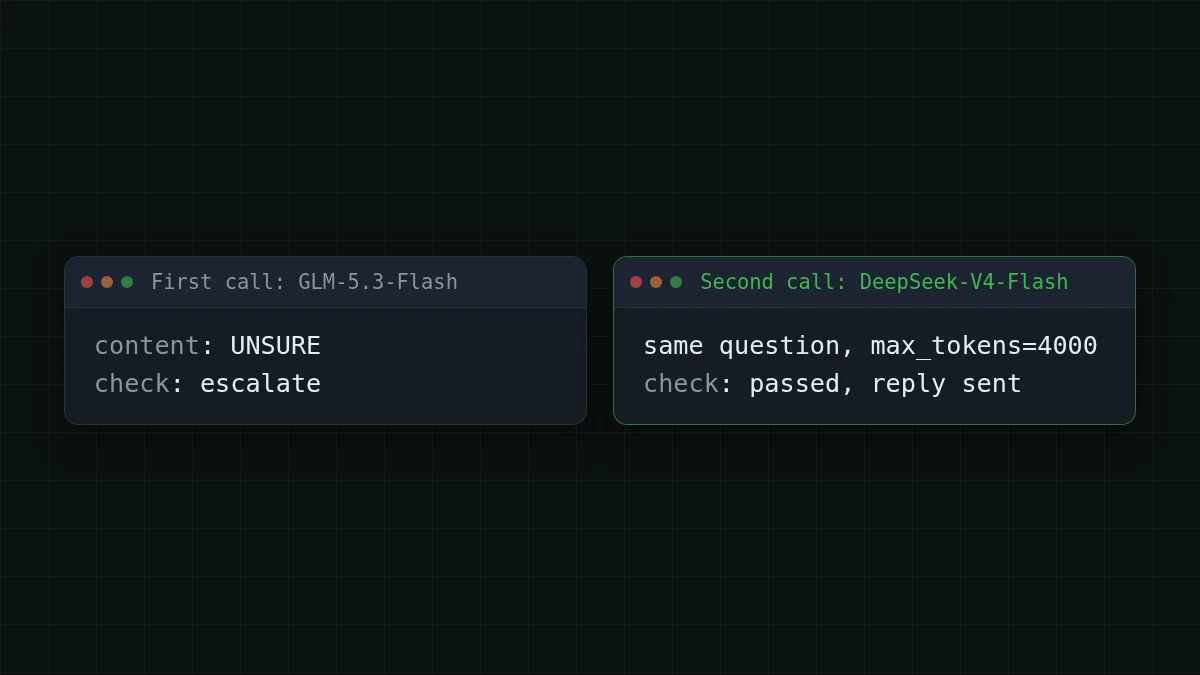
    text, why = ask(CHEAP, question, 600)
    if needs_escalation(text, why):
        text, why = ask(SECOND, question, 4000)
        if 'UNSURE' in text:
            text = 'Sorry, I could not answer this one.'
    return text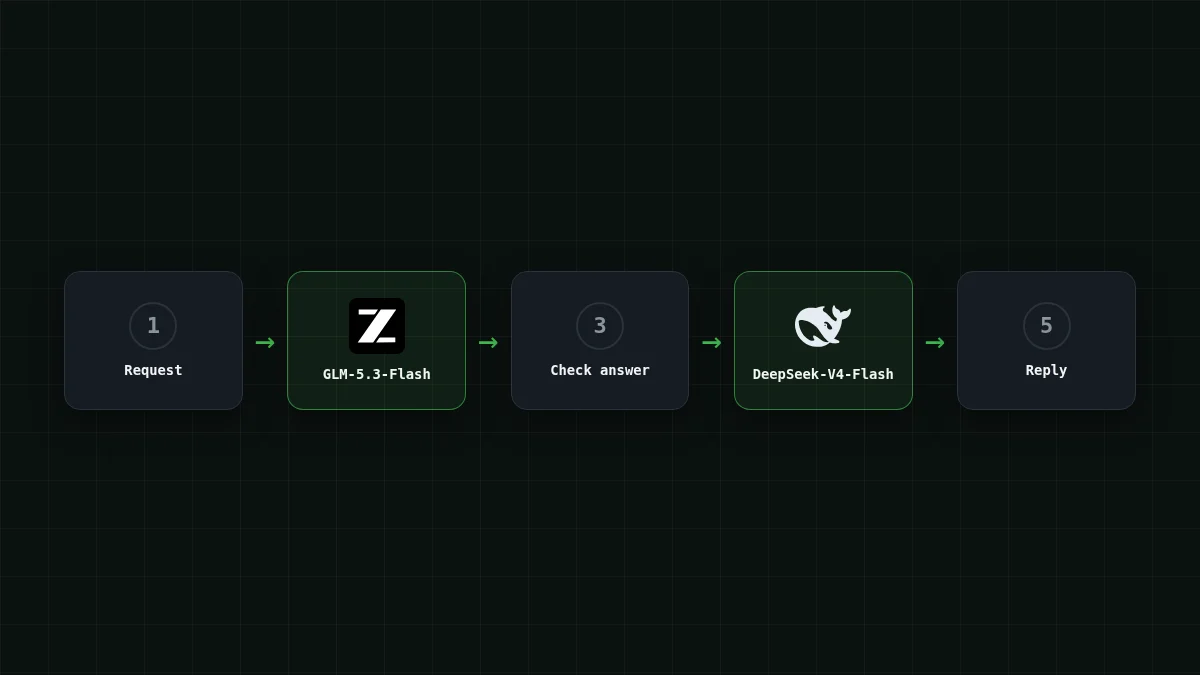
これを単に安いだけでなく誠実にする3つの習慣:
- エスカレーションを数える。
needs_escalationが発火する頻度をログに記録します。それがあなたのpであり、カスケードが割に合うかどうかを決める数値です。 - 自分のテストセットで2番目のモデルを選ぶ。 ログから50の難しいリクエストを取り、両方のモデルで実行し、最初のモデルが見逃したものを修正する場合にのみ2番目のモデルを採用します。その文書化された利点は32,768トークンの回答制限であり、自分のセットがそれがあなたに必要な利点かどうかを示します。
- 同じリクエストを送る、より長いものではない。 失敗した回答を2番目の呼び出しに貼り付けると、入力として支払います。最初の回答が本当に有用なコンテキストでない限り、2番目のパスをクリーンに開始してください。
セルフチェック#
クイックチェック
カスケードで、リクエストの30%が最初のモデルでチェックに失敗します。それらのリクエストのコストは?
答えを表示
答え: 最初のモデルの価格と2番目のモデルの価格
最初の呼び出しは、その回答を捨てるときにすでに請求されています。エスカレーションされたリクエストは2回支払うため、割合pがすべてを決めます。
次に進むべき場所#
どのモデルが最初のパスを担当すべきかわからない場合は、MiniMax-M2.7 vs DeepSeek-V4-Flashがタスク別に比較しています。トークン単位ではなくタスク単位の視点については、100万トークンあたりの価格 vs タスクあたりのコストを、多くのステップを含むループについては、AIエージェントのコストを見積もる方法をご覧ください。すべてのモデルのライブ価格は価格ページにあり、モデルページはDeepSeekとGLMです。


