成本优化指南
通过模型路由降低 API 成本:先使用廉价模型,再升级
将简单请求发送给廉价模型,仅升级困难的请求。查看 10,000 个请求在 10%、30% 和 50% 升级率下的混合成本,以及一个简短的 Python 路由器。
当廉价模型的首次处理比第二个模型便宜得多,且升级的请求很少时,路由可以削减账单:先将每个请求发送给廉价模型,仅将困难的请求重新发送给第二个模型。是否真正节省取决于你升级的请求比例。以下是 10,000 个请求在 10%、30% 和 50% 升级率下的算术,以及一个可以粘贴到项目中的 Python 函数。
这种模式并不新鲜。Anthropic 的工程文章 "Building effective agents"(2024 年 12 月 19 日)称之为路由工作流:常见、简单的问题交给更小、成本更低的模型,不寻常、困难的问题交给能力更强的模型。该文章没有给出价格,因此这里的数字是我们自己的,基于 CheapTokens 的实时价格。
你的哪些请求是简单的?#
只有当你能用规则说明“困难”的含义时,路由才有效。不是凭感觉,而是代码可以检查的规则。选择最接近你情况的情形:
选择你的情况
选择你的情形
选择一个选项以查看答案
支持聊天机器人
大多数工单是简短的常见问题:我的订单在哪里,如何重置密码。少数需要冗长、仔细的回答。简单:第一个模型回答并且不回复 UNSURE。困难:它说 UNSURE,或者回答被截断(finish_reason 为 length)。
文档流水线
每个文档首先经过提取。简单:结果解析为包含所有必填字段的有效 JSON。困难:解析失败或字段为空。只有这些文档会在第二个模型上重新运行。
编码代理
简单编辑交给廉价模型。当同一步骤连续失败两次,或回答被截断(finish_reason 为 length)时,升级该步骤。
除非你告诉模型如何表达,否则不要因为“模型听起来不确定”而升级。一行指令(“如果无法回答,请准确回复 UNSURE”)将感觉转化为 if 可以读取的内容。
10,000 个请求的成本:级联 vs 路由器#
假设你运行一个支持机器人,每月 10,000 个请求。平均请求输入 800 个 token,输出 300 个 token。这些是假设;请从 usage 替换为你自己的数据(我们的 token 计数文章 显示了从哪里读取它们)。
有两种方式连接路由,它们的计费方式不同:
- 级联。 每个请求都发送给廉价模型。比例为 p 的请求未通过检查,并再次发送给第二个模型。这些请求被支付两次:成本 = N × [廉价 + p × 第二个]。
- 路由器。 一个小型分类器调用预先决定。简单的请求交给廉价模型,困难的直接交给第二个模型:成本 = N × [(1 − p) × 廉价 + p × 第二个],加上每个请求的分类器。
我们将使用级联,因为它不需要分类器,并且更容易上手。第一遍是 GLM-5.3-Flash(zai-,390K 上下文,最多 8,192 输出 token)。第二遍是 DeepSeek-V4-Flash 版本 0731(deepseek-,380K 上下文,最多 32,768 输出 token),因此无法在 8,192 token 内完成的回答有空间完成。两者在总成本上都比 OpenRouter 便宜,输入和输出一起计算;下面的实时表格显示了 OpenRouter 列在我们旁边。
第一遍始终覆盖所有 10,000 个请求:8,000,000 输入和 3,000,000 输出 token。第二遍仅覆盖升级的比例。最后一列是替代方案:所有 10,000 个请求直接使用第二个模型。
向右滚动表格 →
| 升级比例 | 第二遍 token(输入 / 输出) | 第一遍,所有 10,000 | 第二遍,仅升级 | 全部在第二个模型上,所有 10,000 |
|---|---|---|---|---|
| 10% | 800,000 / 300,000 | $0.28 | $0.042 | $0.42 |
| 30% | 2,400,000 / 900,000 | $0.28 | $0.126 | $0.42 |
| 50% | 4,000,000 / 1,500,000 | $0.28 | $0.21 | $0.42 |
将每行中的第一遍和第二遍列相加,得到级联的月度成本,然后将该总和与最后一列比较。第一遍是固定成本,只有第二遍随 p 增长。这就是级联的全部故事:你升级得越多,就越接近为工作支付两次费用。
以下是所有模型同时处理相同负载的情况,以便你看到单模型选项的位置:
| 模型 | 输入 $/1M | 输出 $/1M | 每次请求 | 10,000 次请求 | OpenRouter,10,000 次请求 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.28 | $0.517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.42 | $0.98 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.85 | $10.20 |
每次请求 800 个输入 token 和 300 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
什么时候级联不值得?当第一遍加上升级比例的成本高于将所有请求发送给第二个模型时。用符号表示:廉价 + p × 第二个 < 第二个,这意味着 p < 1 − 廉价/第二个。对于这对模型,在此负载下第一遍的成本占第二个模型价格的显著部分,因此级联的收益缩小,在高升级比例下消失。在 50% 时,级联可能输给简单地将所有 10,000 个请求发送给第二个模型,因此在承诺之前,请检查两遍的总和与最后一列的对比。比率取决于你的输入/输出组合,因为两个模型对两侧的定价不同,所以请从你自己的行中读取。
路由器变体增加了一件事:分类器。假设它在廉价模型上每个请求读取 300 个输入 token 并以 5 个 token 回答。对于 10,000 个请求,即 3,000,000 输入和 50,000 输出 token,每月额外 $0.062。将此行与第一遍列的份额 p(10%、30% 或 50%)比较:这就是级联在随后升级的请求上运行第一遍所浪费的。如果分类器行更大,级联是更便宜的起点;如果更小,路由器节省更多。
在构建任何东西之前,先试试你自己的数字:
成本计算器
支持机器人的一个月,全部在一个模型上
每次请求的输入 token 数: 800 · 每次请求的输出 token 数: 300 · 每日请求数: 10,000
| 模型 | 每天 | 每月 |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.28 | $8.40 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.42 | $12.60 |
| MiniMax-M2.7$0.05$0.15 | $0.85 | $25.50 |
将 runs 改为你的量,并读取每个模型的总计。然后使用上表查看第二遍会增加多少。
Python 中的路由器:两次调用和一次检查#
两个模型位于一个 OpenAI 兼容的基础 URL 和一个余额之后,因此路由不需要第二个账户或密钥。下面的代码是一个示例:其中的数字(max_tokens,UNSURE 规则)由你调整。第二次调用获得更高的 max_tokens,因此被截断在 600 token 的回答可以完成。基础 URL、模型 ID 等都在 CheapTokens 文档 中。
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CHEAP = 'zai-org/GLM-5.3-Flash'
SECOND = 'deepseek-ai/DeepSeek-V4-Flash-0731'
SYSTEM = 'Answer briefly. If you cannot answer well, reply exactly UNSURE.'


def ask(model, question, max_tokens):
    r = client.chat.completions.create(
        model=model,
        max_tokens=max_tokens,
        messages=[
            {'role': 'system', 'content': SYSTEM},
            {'role': 'user', 'content': question},
        ],
    )
    choice = r.choices[0]
    return choice.message.content or '', choice.finish_reason


def needs_escalation(text, finish_reason):
    return finish_reason == 'length' or not text.strip() or 'UNSURE' in text


def answer(question):
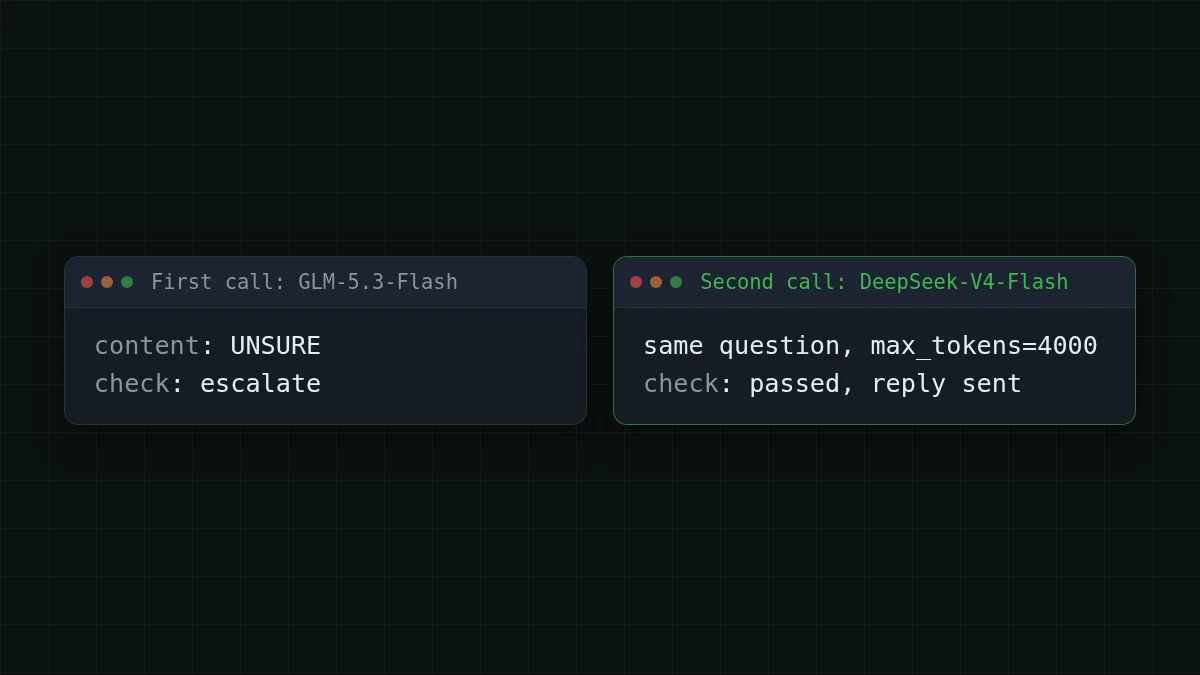
    text, why = ask(CHEAP, question, 600)
    if needs_escalation(text, why):
        text, why = ask(SECOND, question, 4000)
        if 'UNSURE' in text:
            text = 'Sorry, I could not answer this one.'
    return text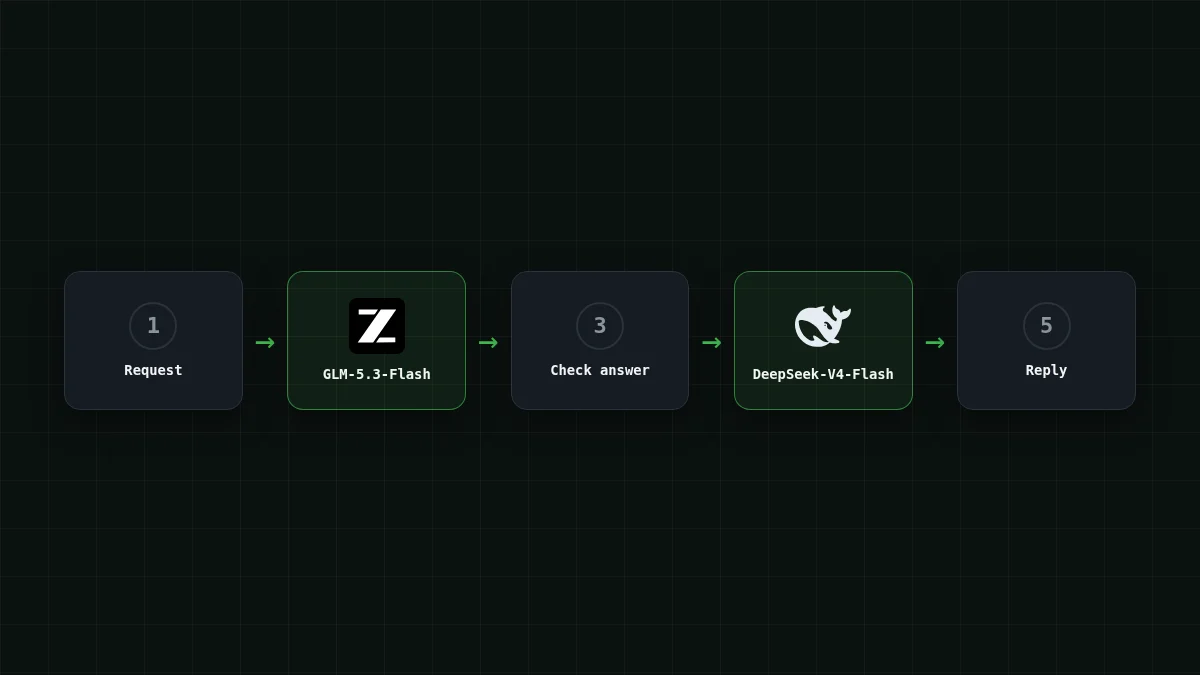
三个习惯使这诚实而不仅仅是便宜:
- 计算升级次数。 记录
needs_escalation触发的频率。那就是你的 p,它是决定级联是否划算的数字。 - 在你自己的测试集上选择第二个模型。 从日志中取 50 个困难请求,通过两个模型运行,仅当第二个模型修复了第一个模型遗漏的请求时才保留它。其文档优势是 32,768 token 的回答限制,你自己的集合显示这是否是你需要的优势。
- 发送相同的请求,而不是更长的请求。 如果你将失败的回答粘贴到第二次调用中,你会将其作为输入付费。除非第一个回答是真正有用的上下文,否则请干净地开始第二遍。
自我检查#
快速检查
在级联中,30% 的请求在第一个模型上未通过检查。这些请求的成本是什么?
显示答案
答案: 第一个模型的价格加上第二个模型的价格
当你丢弃第一个回答时,第一次调用已经计费。升级的请求支付两次,这就是为什么份额 p 决定一切。
下一步去哪里#
如果你不确定哪个模型应该承担第一遍,MiniMax-M2.7 vs DeepSeek-V4-Flash 按任务比较它们。对于按任务而非按 token 的视图,请参阅 每 1M token 的价格 vs 每任务成本,对于多步骤循环,请参阅 如何估算 AI 代理的成本。每个模型的实时价格在 定价页面 上,模型页面是 DeepSeek 和 GLM。


