KostenoptimierungAnleitung
Modell-Routing zur Senkung der API-Kosten: günstiges Modell zuerst, eskalieren
Sende einfache Anfragen an ein günstiges Modell und eskaliere nur die schwierigen. Sieh die gemischten Kosten von 10.000 Anfragen bei 10 %, 30 % und 50 % Eskalation, plus einen kurzen Python-Router.
Auf dieser Seite
Routing kann die Rechnung senken, wenn der erste Durchlauf des günstigen Modells deutlich billiger ist als das zweite Modell und nur wenige Anfragen eskaliert werden: Schicke jede Anfrage zuerst an das günstige Modell und sende nur die schwierigen erneut an ein zweites Modell. Ob du tatsächlich sparst, hängt vom Anteil der eskalierten Anfragen ab. Unten findest du die Arithmetik für 10.000 Anfragen bei 10 %, 30 % und 50 % sowie eine Python-Funktion, die du in dein Projekt einfügen kannst.
Das Muster ist nicht neu. Anthropics Engineering-Post "Building effective agents" (19. Dezember 2024) nennt es einen Routing-Workflow: Häufige, einfache Fragen gehen an ein kleineres, kosteneffizientes Modell, ungewöhnliche, schwierige an ein leistungsfähigeres. Der Post nennt keine Preise, daher sind die Zahlen hier unsere eigenen, auf Basis der Live-Preise von CheapTokens.
Welche deiner Anfragen sind einfach?#
Routing funktioniert nur, wenn du in einer Regel sagen kannst, was "schwierig" bedeutet. Nicht in einem Gefühl, sondern in einer Regel, die der Code prüfen kann. Wähle den Fall, der deinem am nächsten kommt:
Wähle deinen Fall
Wähle deinen Fall
Wähle eine Option, um die Antwort zu sehen
Support-Chatbot
Die meisten Tickets sind kurze FAQs: Wo ist meine Bestellung, wie setze ich ein Passwort zurück. Einige brauchen eine lange, sorgfältige Antwort. Einfach: Das erste Modell antwortet und gibt nicht UNSURE zurück. Schwierig: Es sagt UNSURE, oder die Antwort ist abgeschnitten (finish_reason ist length).
Dokumenten-Pipeline
Jedes Dokument durchläuft zuerst die Extraktion. Einfach: Das Ergebnis parst als gültiges JSON mit allen erforderlichen Feldern. Schwierig: Der Parse schlägt fehl oder ein Feld ist leer. Nur diese Dokumente werden erneut auf dem zweiten Modell ausgeführt.
Coding-Agent
Einfache Änderungen gehen an das günstige Modell. Eskaliere einen Schritt, wenn derselbe Schritt zweimal hintereinander fehlgeschlagen ist oder wenn die Antwort abgeschnitten wurde (finish_reason ist length).
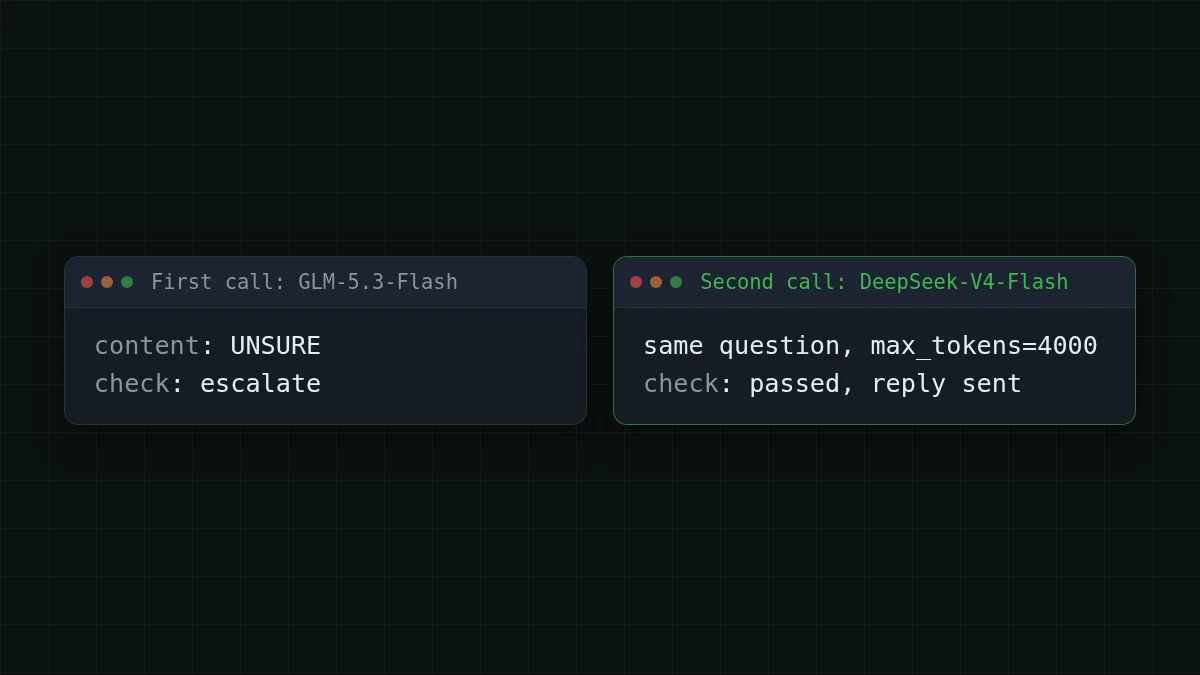
Eskaliere nicht bei "das Modell klingt unsicher", es sei denn, du hast ihm gesagt, wie es das ausdrücken soll. Eine einzeilige Anweisung ("antworte genau UNSURE, wenn du nicht antworten kannst") macht aus einem Gefühl etwas, das if lesen kann.
Was 10.000 Anfragen kosten: Kaskade vs. Router#
Angenommen, du betreibst einen Support-Bot mit 10.000 Anfragen pro Monat. Eine durchschnittliche Anfrage hat 800 Token Eingabe und 300 Token Ausgabe. Das sind Annahmen; ersetze sie durch deine eigenen aus usage (unser Token-Zählungsartikel zeigt, wo du sie abliest).
Es gibt zwei Arten, Routing zu verdrahten, und sie rechnen unterschiedlich ab:
- Kaskade. Jede Anfrage geht an das günstige Modell. Ein Anteil p besteht die Prüfung nicht und wird erneut an das zweite Modell gesendet. Diese Anfragen werden doppelt bezahlt: Kosten = N × [günstig + p × zweites].
- Router. Ein kleiner Klassifikator-Aufruf entscheidet vorab. Einfache gehen an das günstige Modell, schwierige direkt an das zweite: Kosten = N × [(1 − p) × günstig + p × zweites], plus der Klassifikator bei jeder Anfrage.
Wir verwenden die Kaskade, weil sie keinen Klassifikator benötigt und der einfachere Einstieg ist. Der erste Durchlauf ist GLM-5.3-Flash (zai-, 390K Kontext, bis zu 8.192 Ausgabe-Token). Der zweite Durchlauf ist DeepSeek-V4-Flash Release 0731 (deepseek-, 380K Kontext, bis zu 32.768 Ausgabe-Token), sodass eine Antwort, die nicht in 8.192 Token passte, Platz zum Fertigwerden hat. Beide sind insgesamt günstiger als OpenRouter, wenn Eingabe und Ausgabe zusammen gezählt werden; die Live-Tabelle unten zeigt die OpenRouter-Spalte neben unserer.
Der erste Durchlauf deckt immer alle 10.000 Anfragen ab: 8.000.000 Eingabe- und 3.000.000 Ausgabe-Token. Der zweite Durchlauf deckt nur den eskalierten Anteil ab. Die letzte Spalte ist die Alternative: alle 10.000 Anfragen direkt auf dem zweiten Modell.
Tabelle nach rechts scrollen →
| Eskalierter Anteil | Token des zweiten Durchlaufs (ein / aus) | Erster Durchlauf, alle 10.000 | Zweiter Durchlauf, nur eskalierte | Alles auf dem zweiten Modell, alle 10.000 |
|---|---|---|---|---|
| 10 % | 800.000 / 300.000 | $0.28 | $0.042 | $0.42 |
| 30 % | 2.400.000 / 900.000 | $0.28 | $0.126 | $0.42 |
| 50 % | 4.000.000 / 1.500.000 | $0.28 | $0.21 | $0.42 |
Addiere in jeder Zeile die Spalten für den ersten und zweiten Durchlauf, um die Monatskosten der Kaskade zu erhalten, und vergleiche diese Summe mit der letzten Spalte. Der erste Durchlauf ist eine feste Kostenposition, und nur der zweite Durchlauf wächst mit p. Das ist die ganze Geschichte einer Kaskade: Je mehr du eskalierst, desto näher kommst du daran, die Arbeit doppelt zu bezahlen.
Hier ist dieselbe Last für alle Modelle auf einmal, damit du siehst, wo die Einzelmodell-Optionen landen:
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 10.000 Anfragen | OpenRouter, 10.000 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.28 | $0.517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.42 | $0.98 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.85 | $10.20 |
800 Input- und 300 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Wann lohnt sich eine Kaskade nicht? Wenn der erste Durchlauf plus der eskalierte Anteil mehr kostet, als alles an das zweite Modell zu senden. In Symbolen: günstig + p × zweites < zweites, was p < 1 − günstig/zweites bedeutet. Für dieses Paar kostet der erste Durchlauf bei dieser Last einen merklichen Anteil des Preises des zweiten Modells, sodass der Gewinn einer Kaskade schrumpft und bei einem hohen Eskalationsanteil verschwindet. Bei 50 % kann die Kaskade gegen das einfache Senden aller 10.000 Anfragen an das zweite Modell verlieren, also prüfe die Summe der beiden Durchläufe gegen die letzte Spalte, bevor du dich festlegst. Das Verhältnis hängt von deinem Eingabe-/Ausgabe-Mix ab, weil die beiden Modelle die beiden Seiten unterschiedlich bepreisen, also lies es aus deiner eigenen Zeile ab.
Die Router-Variante fügt eines hinzu: den Klassifikator. Angenommen, er liest 300 Eingabe-Token und antwortet in 5 Token auf dem günstigen Modell, pro Anfrage. Für 10.000 Anfragen sind das 3.000.000 Eingabe- und 50.000 Ausgabe-Token, also $0.062 pro Monat zusätzlich. Vergleiche diese Zeile mit dem Anteil p der Spalte des ersten Durchlaufs (10 %, 30 % oder 50 % davon): Das ist, was die Kaskade verschwendet, indem sie den ersten Durchlauf auf Anfragen ausführt, die dann eskalieren. Ist die Klassifikator-Zeile größer, ist die Kaskade der günstigere Start; ist sie kleiner, spart ein Router mehr.
Probiere deine eigenen Zahlen aus, bevor du etwas baust:
Kostenrechner
Ein Monat eines Support-Bots, alles auf einem Modell
Eingabe-Tokens pro Anfrage: 800 · Ausgabe-Tokens pro Anfrage: 300 · Anfragen pro Tag: 10.000
| Modell | Pro Tag | Pro Monat |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.28 | $8.40 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.42 | $12.60 |
| MiniMax-M2.7$0.05$0.15 | $0.85 | $25.50 |
Ändere runs auf dein Volumen und lies die Summe für jedes Modell ab. Nutze dann die Tabelle oben, um zu sehen, wie viel ein zweiter Durchlauf hinzufügen würde.
Ein Router in Python: zwei Aufrufe und eine Prüfung#
Beide Modelle liegen hinter einer OpenAI-kompatiblen Basis-URL und einem Guthaben, sodass Routing kein zweites Konto oder einen zweiten Schlüssel benötigt. Der Code unten ist ein Beispiel: Die Zahlen darin (max_tokens, die UNSURE-Regel) sind zum Anpassen. Der zweite Aufruf bekommt ein höheres max_tokens, sodass eine bei 600 Token abgeschnittene Antwort fertig werden kann. Basis-URL, Modell-IDs und der Rest stehen in der CheapTokens-Dokumentation.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CHEAP = 'zai-org/GLM-5.3-Flash'
SECOND = 'deepseek-ai/DeepSeek-V4-Flash-0731'
SYSTEM = 'Answer briefly. If you cannot answer well, reply exactly UNSURE.'


def ask(model, question, max_tokens):
    r = client.chat.completions.create(
        model=model,
        max_tokens=max_tokens,
        messages=[
            {'role': 'system', 'content': SYSTEM},
            {'role': 'user', 'content': question},
        ],
    )
    choice = r.choices[0]
    return choice.message.content or '', choice.finish_reason


def needs_escalation(text, finish_reason):
    return finish_reason == 'length' or not text.strip() or 'UNSURE' in text


def answer(question):
    text, why = ask(CHEAP, question, 600)
    if needs_escalation(text, why):
        text, why = ask(SECOND, question, 4000)
        if 'UNSURE' in text:
            text = 'Sorry, I could not answer this one.'
    return text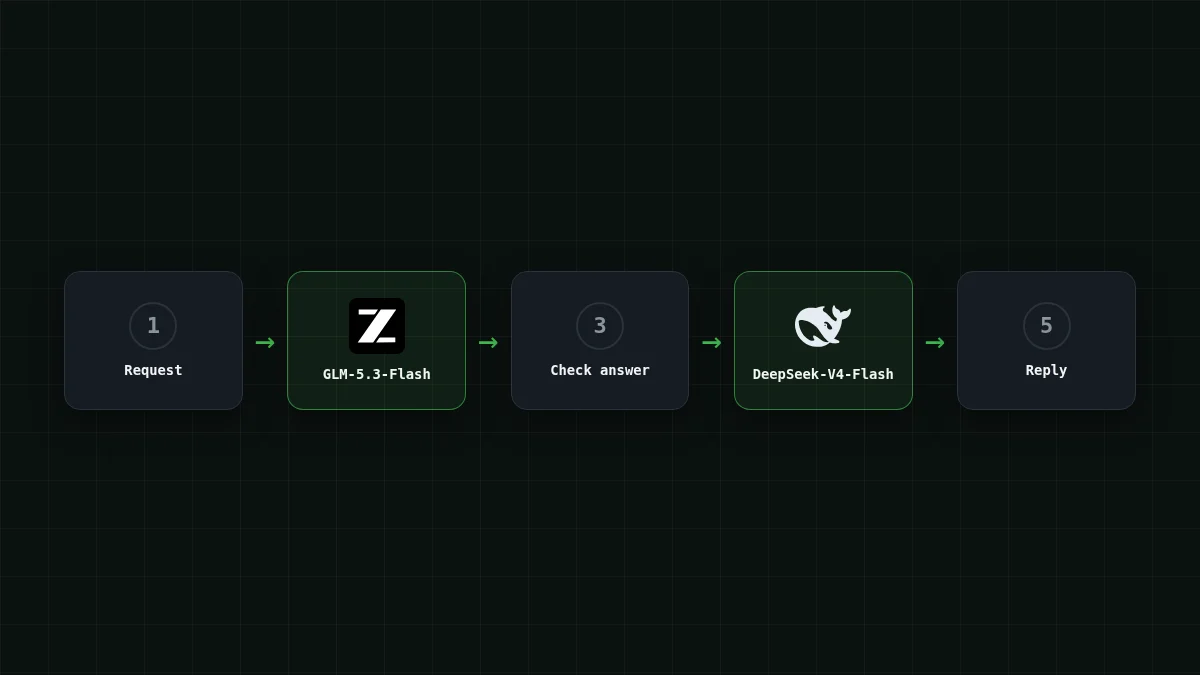
Drei Gewohnheiten machen das ehrlich statt nur billig:
- Zähle die Eskalationen. Protokolliere, wie oft
needs_escalationausgelöst wird. Das ist dein p, und es ist die Zahl, die entscheidet, ob sich die Kaskade lohnt. - Wähle das zweite Modell anhand deines eigenen Testsets. Nimm 50 schwierige Anfragen aus deinen Logs, führe sie durch beide Modelle und behalte das zweite Modell nur, wenn es die korrigiert, die das erste verpasst hat. Sein dokumentierter Vorteil ist das 32.768-Token-Antwortlimit, und dein eigenes Set zeigt, ob das der Vorteil ist, den du brauchst.
- Sende dieselbe Anfrage, keine längere. Wenn du die fehlgeschlagene Antwort in den zweiten Aufruf einfügst, bezahlst du sie als Eingabe. Starte den zweiten Durchlauf sauber, es sei denn, die erste Antwort ist wirklich nützlicher Kontext.
Prüfe dich selbst#
Kurzer Check
In einer Kaskade scheitern 30 % der Anfragen an der Prüfung beim ersten Modell. Was kosten diese Anfragen?
Antwort anzeigen
Antwort: Den Preis des ersten Modells plus den Preis des zweiten Modells
Der erste Aufruf wird bereits abgerechnet, wenn du seine Antwort wegwirfst. Eskalierte Anfragen zahlen doppelt, weshalb der Anteil p alles entscheidet.
Wie es weitergeht#
Wenn du nicht sicher bist, welches Modell den ersten Durchlauf übernehmen sollte, vergleicht MiniMax-M2.7 vs DeepSeek-V4-Flash sie nach Aufgabe. Für eine Ansicht pro Aufgabe statt pro Token siehe Preis pro 1M Token vs. Kosten pro Aufgabe, und für Schleifen mit vielen Schritten wie man die Kosten eines KI-Agenten schätzt. Live-Preise für jedes Modell findest du auf der Preisseite, und die Modellseiten sind DeepSeek und GLM.


