Roteamento de modelos para cortar custo de API: modelo barato primeiro, escale
Envie requisições fáceis para um modelo barato e escale apenas as difíceis. Veja o custo combinado de 10.000 requisições com 10%, 30% e 50% de escalonamento, além de um roteador Python curto.
Nesta página
O roteamento pode reduzir a conta quando a primeira passada do modelo barato é muito mais barata que o segundo modelo e poucas requisições escalam: envie toda requisição primeiro ao modelo barato e reenvie apenas as difíceis para um segundo modelo. Se você realmente economiza depende da proporção de requisições que você escala. Abaixo está a aritmética para 10.000 requisições a 10%, 30% e 50%, e uma função Python que você pode colar no seu projeto.
O padrão não é novo. O post de engenharia da Anthropic "Building effective agents" (19 de dezembro de 2024) chama isso de fluxo de trabalho de roteamento: perguntas comuns e fáceis vão para um modelo menor e econômico, e as incomuns e difíceis vão para um mais capaz. O post não dá preços, então os números aqui são nossos, com preços ao vivo da CheapTokens.
Quais das suas requisições são fáceis?#
O roteamento só funciona se você conseguir dizer, em uma regra, o que significa "difícil". Não em um sentimento, em uma regra que o código possa verificar. Escolha o caso mais próximo do seu:
Escolha o seu caso
Escolha seu caso
Escolha uma opção para ver a resposta
Chatbot de suporte
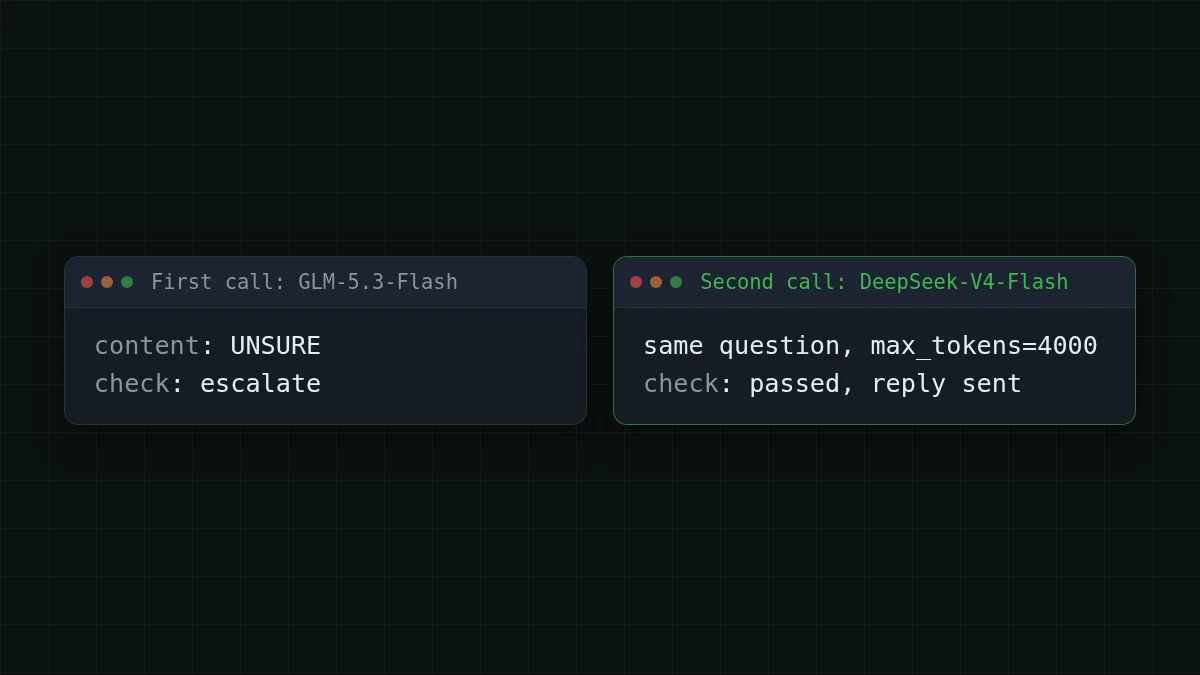
A maioria dos tickets são FAQs curtas: onde está meu pedido, como redefinir uma senha. Alguns precisam de uma resposta longa e cuidadosa. Fácil: o primeiro modelo responde e não replica UNSURE. Difícil: ele diz UNSURE, ou a resposta é cortada (finish_reason é length).
Pipeline de documentos
Todo documento passa primeiro pela extração. Fácil: o resultado é parseado como JSON válido com todos os campos obrigatórios. Difícil: o parse falha ou um campo está vazio. Apenas esses documentos são reexecutados no segundo modelo.
Agente de código
Edições simples vão para o modelo barato. Escale um passo quando o mesmo passo falhou duas vezes seguidas, ou quando a resposta foi cortada (finish_reason é length).
Não escale com base em "o modelo parece inseguro" a menos que você tenha dito a ele como sinalizar isso. Uma instrução de uma linha ("responda exatamente UNSURE se não conseguir responder") transforma uma impressão em algo que if consegue ler.
Quanto custam 10.000 requisições: cascata vs roteador#
Digamos que você opere um bot de suporte com 10.000 requisições por mês. Uma requisição média tem 800 tokens de entrada e 300 tokens de saída. Essas são suposições; substitua pelas suas a partir de usage (nosso artigo sobre contagem de tokens mostra onde lê-las).
Há duas formas de montar o roteamento, e elas cobram de maneira diferente:
- Cascata. Toda requisição vai para o modelo barato. Uma proporção p falha na verificação e é reenviada ao segundo modelo. Essas requisições são pagas duas vezes: custo = N × [barato + p × segundo].
- Roteador. Uma pequena chamada de classificador decide antecipadamente. As fáceis vão para o modelo barato, as difíceis direto para o segundo: custo = N × [(1 − p) × barato + p × segundo], mais o classificador em toda requisição.
Usaremos a cascata, porque ela não precisa de classificador e é a mais fácil de começar. A primeira passada é o GLM-5.3-Flash (zai-, contexto de 390K, até 8.192 tokens de saída). A segunda passada é o DeepSeek-V4-Flash release 0731 (deepseek-, contexto de 380K, até 32.768 tokens de saída), então uma resposta que não coube em 8.192 tokens tem espaço para terminar. Ambos são mais baratos que o OpenRouter no total, com entrada e saída contadas juntas; a tabela ao vivo abaixo mostra a coluna do OpenRouter ao lado da nossa.
A primeira passada sempre cobre todas as 10.000 requisições: 8.000.000 de entrada e 3.000.000 de saída em tokens. A segunda passada cobre apenas a proporção escalada. A última coluna é a alternativa: todas as 10.000 requisições direto no segundo modelo.
Role a tabela para a direita →
| Proporção escalada | Tokens da segunda passada (entrada / saída) | Primeira passada, todas as 10.000 | Segunda passada, apenas escaladas | Tudo no segundo modelo, todas as 10.000 |
|---|---|---|---|---|
| 10% | 800.000 / 300.000 | $0.28 | $0.042 | $0.42 |
| 30% | 2.400.000 / 900.000 | $0.28 | $0.126 | $0.42 |
| 50% | 4.000.000 / 1.500.000 | $0.28 | $0.21 | $0.42 |
Some as colunas da primeira e da segunda passada em cada linha para obter o mês da cascata, depois compare essa soma com a última coluna. A primeira passada é um custo fixo, e apenas a segunda passada cresce com p. Essa é toda a história de uma cascata: quanto mais você escala, mais perto fica de pagar pelo trabalho duas vezes.
Aqui está a mesma carga para todos os modelos de uma vez, para você ver onde as opções de modelo único se encaixam:
| Modelo | Entrada $/1M | Saída $/1M | Por solicitação | 10.000 solicitações | OpenRouter, 10.000 solicitações |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.28 | $0.517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.42 | $0.98 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.85 | $10.20 |
800 tokens de entrada e 300 tokens de saída por solicitação. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
Quando uma cascata não vale a pena? Quando a primeira passada mais a proporção escalada custa mais do que enviar tudo para o segundo modelo. Em símbolos: barato + p × segundo < segundo, o que significa p < 1 − barato/segundo. Para este par, a primeira passada custa uma parcela perceptível do preço do segundo modelo nesta carga, então o ganho de uma cascata encolhe, e com uma alta proporção de escalonamento ele desaparece. A 50% a cascata pode perder para simplesmente enviar todas as 10.000 requisições ao segundo modelo, então verifique a soma das duas passadas contra a última coluna antes de se comprometer. A razão depende da sua mistura de entrada/saída, porque os dois modelos precificam os dois lados de forma diferente, então leia-a da sua própria linha.
A variante de roteador adiciona uma coisa: o classificador. Suponha que ele leia 300 tokens de entrada e responda em 5 tokens no modelo barato, por requisição. Para 10.000 requisições isso é 3.000.000 de entrada e 50.000 de saída em tokens, ou $0.062 por mês a mais. Compare essa linha com a proporção p da coluna da primeira passada (10%, 30% ou 50% dela): é o que a cascata desperdiça ao executar a primeira passada em requisições que depois escalam. Se a linha do classificador for maior, a cascata é o começo mais barato; se for menor, um roteador economiza mais.
Teste seus próprios números antes de construir qualquer coisa:
Calculadora de custos
Um mês de um bot de suporte, tudo em um modelo
Tokens de entrada por solicitação: 800 · Tokens de saída por solicitação: 300 · Solicitações por dia: 10.000
| Modelo | Por dia | Por mês |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.28 | $8.40 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.42 | $12.60 |
| MiniMax-M2.7$0.05$0.15 | $0.85 | $25.50 |
Altere runs para o seu volume e leia o total de cada modelo. Depois use a tabela acima para ver quanto uma segunda passada acrescentaria.
Um roteador em Python: duas chamadas e uma verificação#
Ambos os modelos ficam atrás de uma única base URL compatível com OpenAI e um único saldo, então o roteamento não precisa de uma segunda conta ou chave. O código abaixo é um exemplo: os números nele (max_tokens, a regra UNSURE) são seus para ajustar. A segunda chamada recebe um max_tokens maior, então uma resposta cortada em 600 tokens pode terminar. Base URL, ids de modelo e o resto estão na documentação da CheapTokens.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CHEAP = 'zai-org/GLM-5.3-Flash'
SECOND = 'deepseek-ai/DeepSeek-V4-Flash-0731'
SYSTEM = 'Answer briefly. If you cannot answer well, reply exactly UNSURE.'


def ask(model, question, max_tokens):
    r = client.chat.completions.create(
        model=model,
        max_tokens=max_tokens,
        messages=[
            {'role': 'system', 'content': SYSTEM},
            {'role': 'user', 'content': question},
        ],
    )
    choice = r.choices[0]
    return choice.message.content or '', choice.finish_reason


def needs_escalation(text, finish_reason):
    return finish_reason == 'length' or not text.strip() or 'UNSURE' in text


def answer(question):
    text, why = ask(CHEAP, question, 600)
    if needs_escalation(text, why):
        text, why = ask(SECOND, question, 4000)
        if 'UNSURE' in text:
            text = 'Sorry, I could not answer this one.'
    return text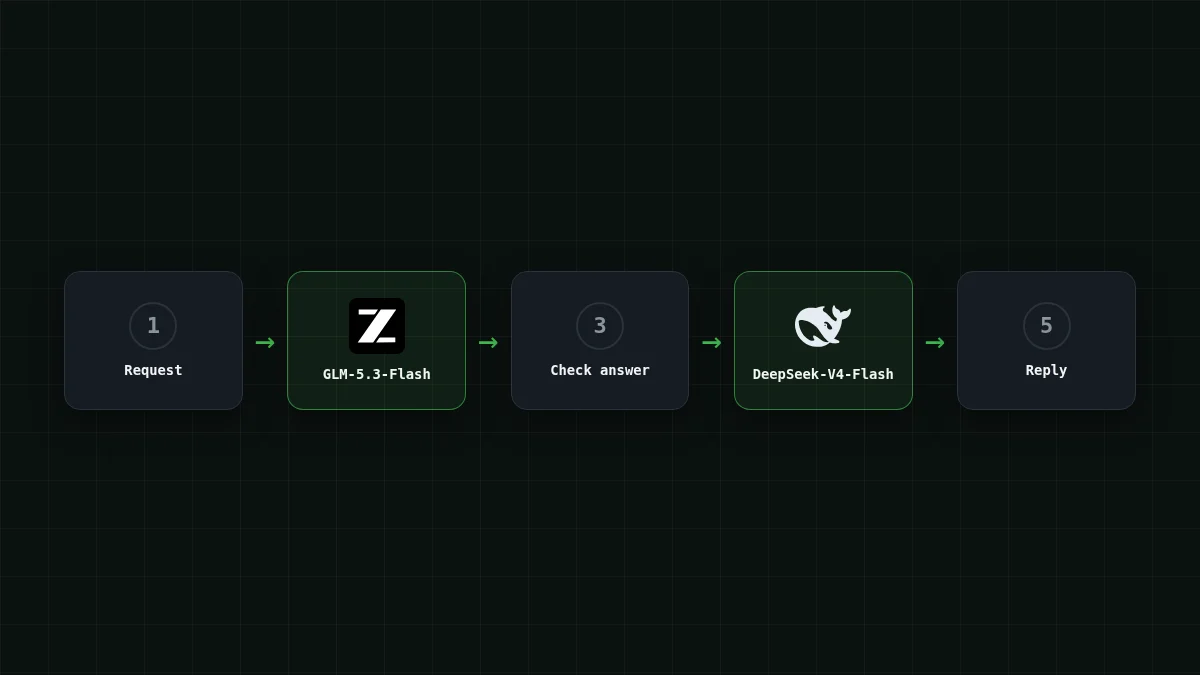
Três hábitos tornam isso honesto em vez de apenas barato:
- Conte os escalonamentos. Registre com que frequência
needs_escalationdispara. Essa é a sua p, e é o número que decide se a cascata compensa. - Escolha o segundo modelo no seu próprio conjunto de testes. Pegue 50 requisições difíceis dos seus logs, execute-as pelos dois modelos e mantenha o segundo modelo apenas se ele corrigir as que o primeiro perdeu. Sua vantagem documentada é o limite de resposta de 32.768 tokens, e seu próprio conjunto mostra se essa é a vantagem que você precisa.
- Envie a mesma requisição, não uma mais longa. Se você colar a resposta que falhou na segunda chamada, você paga por ela como entrada. Comece a segunda passada limpa, a menos que a primeira resposta seja um contexto genuinamente útil.
Teste você mesmo#
Verificação rápida
Em uma cascata, 30% das requisições falham na verificação no primeiro modelo. Quanto custam essas requisições?
Mostrar resposta
Resposta: O preço do primeiro modelo mais o preço do segundo modelo
A primeira chamada já é cobrada quando você descarta a resposta. Requisições escaladas pagam duas vezes, e é por isso que a proporção p decide tudo.
Para onde ir a seguir#
Se você não tem certeza de qual modelo deve fazer a primeira passada, MiniMax-M2.7 vs DeepSeek-V4-Flash os compara por tarefa. Para uma visão por tarefa em vez de por token, veja preço por 1M de tokens vs custo por tarefa, e para loops com muitos passos, como estimar o custo de um agente de IA. Preços ao vivo de todos os modelos estão na página de preços, e as páginas dos modelos são DeepSeek e GLM.


