비용 최적화가이드
API 비용을 줄이는 모델 라우팅: 저렴한 모델 먼저, 에스컬레이션
쉬운 요청은 저렴한 모델로 보내고 어려운 요청만 에스컬레이션하세요. 10%, 30%, 50% 에스컬레이션에서 10,000건 요청의 혼합 비용과 짧은 Python 라우터를 확인하세요.
라우팅은 저렴한 모델의 첫 번째 패스가 두 번째 모델보다 훨씬 저렴하고 에스컬레이션되는 요청이 적을 때 비용을 줄일 수 있습니다. 모든 요청을 먼저 저렴한 모델로 보내고, 어려운 요청만 두 번째 모델로 다시 보내세요. 실제로 절약되는지는 에스컬레이션하는 요청의 비율에 달려 있습니다. 아래는 10,000건의 요청을 10%, 30%, 50%로 처리할 때의 계산과 프로젝트에 붙여넣을 수 있는 Python 함수입니다.
이 패턴은 새로운 것이 아닙니다. Anthropic의 엔지니어링 글 "Building effective agents"(2024년 12월 19일)는 이를 라우팅 워크플로라고 부릅니다. 흔하고 쉬운 질문은 더 작고 비용 효율적인 모델로, 드물고 어려운 질문은 더 성능이 좋은 모델로 보내는 것입니다. 이 글에는 가격이 없으므로 여기 수치는 실제 CheapTokens 가격을 기준으로 한 자체 계산입니다.
어떤 요청이 쉬운가요?#
라우팅은 "어려움"이 무엇인지 규칙으로 말할 수 있을 때만 작동합니다. 느낌이 아니라 코드가 확인할 수 있는 규칙이어야 합니다. 가장 비슷한 사례를 고르세요:
사례 선택하기
사례 선택
답을 보려면 옵션을 선택하세요
지원 챗봇
대부분의 티켓은 짧은 FAQ입니다. 주문이 어디 있는지, 비밀번호를 어떻게 재설정하는지 등입니다. 일부는 길고 신중한 답변이 필요합니다. 쉬움: 첫 모델이 답변하고 UNSURE를 반환하지 않음. 어려움: UNSURE를 반환하거나 답변이 잘림(finish_reason가 length).
문서 파이프라인
모든 문서는 먼저 추출을 거칩니다. 쉬움: 결과가 필수 필드를 모두 갖춘 유효한 JSON으로 파싱됨. 어려움: 파싱이 실패하거나 필드가 비어 있음. 해당 문서만 두 번째 모델에서 다시 실행합니다.
코딩 에이전트
간단한 편집은 저렴한 모델로 보냅니다. 같은 단계가 연속 두 번 실패하거나 답변이 잘린 경우(finish_reason가 length) 해당 단계를 에스컬레이션합니다.
"모델이 확신이 없어 보인다"는 이유로 에스컬레이션하지 마세요. 모델에게 그렇게 말하는 방법을 알려주지 않았다면 말입니다. 한 줄 지시("답할 수 없으면 정확히 UNSURE라고 답하세요")가 막연한 느낌을 if가 읽을 수 있는 것으로 바꿔줍니다.
10,000건의 요청 비용: 캐스케이드 vs 라우터#
월 10,000건의 요청을 처리하는 지원 봇을 운영한다고 가정합니다. 평균 요청은 입력 800토큰, 출력 300토큰입니다. 이는 가정이며, usage에서 직접 가져온 값으로 바꾸세요(어디서 읽는지는 토큰 수 글에서 확인할 수 있습니다).
라우팅을 구성하는 방법은 두 가지이며 청구 방식이 다릅니다:
- 캐스케이드. 모든 요청이 저렴한 모델로 갑니다. 비율 p가 검사를 통과하지 못하고 두 번째 모델로 다시 전송됩니다. 해당 요청은 두 번 청구됩니다: 비용 = N × [저렴한 모델 + p × 두 번째 모델].
- 라우터. 작은 분류기 호출이 미리 결정합니다. 쉬운 요청은 저렴한 모델로, 어려운 요청은 바로 두 번째 모델로 갑니다: 비용 = N × [(1 − p) × 저렴한 모델 + p × 두 번째 모델]에 모든 요청의 분류기 비용을 더합니다.
분류기가 필요 없고 시작하기 더 쉬운 캐스케이드를 사용하겠습니다. 첫 번째 패스는 GLM-5.3-Flash(zai-, 390K 컨텍스트, 최대 8,192 출력 토큰)입니다. 두 번째 패스는 DeepSeek-V4-Flash 릴리스 0731(deepseek-, 380K 컨텍스트, 최대 32,768 출력 토큰)이므로 8,192토큰에 들어가지 못한 답변도 끝까지 완성할 여유가 있습니다. 둘 다 입력과 출력을 합산한 총액에서 OpenRouter보다 저렴합니다. 아래 실시간 표는 OpenRouter 열을 우리 열 옆에 보여줍니다.
첫 번째 패스는 항상 10,000건 전체를 처리합니다: 입력 8,000,000, 출력 3,000,000토큰. 두 번째 패스는 에스컬레이션된 비율만 처리합니다. 마지막 열은 대안입니다: 10,000건 전체를 두 번째 모델로 바로 보내는 경우입니다.
표를 오른쪽으로 스크롤하세요 →
| 에스컬레이션 비율 | 두 번째 패스 토큰 (입력 / 출력) | 첫 번째 패스, 10,000건 전체 | 두 번째 패스, 에스컬레이션만 | 두 번째 모델로 전체 10,000건 |
|---|---|---|---|---|
| 10% | 800,000 / 300,000 | $0.28 | $0.042 | $0.42 |
| 30% | 2,400,000 / 900,000 | $0.28 | $0.126 | $0.42 |
| 50% | 4,000,000 / 1,500,000 | $0.28 | $0.21 | $0.42 |
각 행에서 첫 번째 패스와 두 번째 패스 열을 더하면 캐스케이드의 월 비용이 나옵니다. 그 합계를 마지막 열과 비교하세요. 첫 번째 패스는 고정 비용이고, 두 번째 패스만 p에 따라 증가합니다. 이것이 캐스케이드의 전부입니다. 에스컬레이션할수록 작업 비용을 두 번 지불하는 쪽에 가까워집니다.
다음은 모든 모델에 대해 동일한 부하를 한 번에 보여주는 표입니다. 단일 모델 옵션이 어디에 위치하는지 확인할 수 있습니다:
| 모델 | 입력 $/1M | 출력 $/1M | 요청당 | 10,000회 요청 | OpenRouter, 10,000회 요청 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.28 | $0.517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.42 | $0.98 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.85 | $10.20 |
요청당 입력 800개 및 출력 300개 토큰입니다. 100만 토큰당 가격은 현재 기준이며 당사 요금제에 따라 함께 변경됩니다. OpenRouter 열은 동일한 작업량에 대한 참고 가격을 보여줍니다.
캐스케이드가 언제 이득이 없을까요? 첫 번째 패스와 에스컬레이션된 비율의 비용 합이 모든 요청을 두 번째 모델로 보내는 비용보다 클 때입니다. 기호로 쓰면: 저렴한 모델 + p × 두 번째 모델 < 두 번째 모델, 즉 p < 1 − 저렴한 모델/두 번째 모델입니다. 이 조합에서는 이 부하에서 첫 번째 패스가 두 번째 모델 가격의 상당 부분을 차지하므로 캐스케이드의 이득이 줄어들고, 에스컬레이션 비율이 높으면 사라집니다. 50%에서는 캐스케이드가 10,000건 전체를 두 번째 모델로 보내는 것보다 손해일 수 있으므로, 결정하기 전에 두 패스의 합계를 마지막 열과 비교하세요. 비율은 두 모델이 입력과 출력의 가격을 다르게 책정하므로 입력/출력 구성에 따라 달라집니다. 따라서 자신의 행에서 읽으세요.
라우터 변형은 한 가지를 더합니다: 분류기입니다. 요청당 저렴한 모델에서 입력 300토큰을 읽고 5토큰으로 답한다고 가정합니다. 10,000건이면 입력 3,000,000, 출력 50,000토큰으로 월 $0.062가 추가됩니다. 이 줄을 첫 번째 패스 열의 비율 p(10%, 30%, 50%)와 비교하세요. 그것이 캐스케이드가 에스컬레이션될 요청에 첫 번째 패스를 실행함으로써 낭비하는 비용입니다. 분류기 줄이 더 크면 캐스케이드가 더 저렴한 시작이고, 더 작으면 라우터가 더 절약됩니다.
무엇이든 만들기 전에 자신의 수치로 시도해 보세요:
비용 계산기
지원 봇 한 달, 모든 요청을 하나의 모델로
요청당 입력 토큰: 800 · 요청당 출력 토큰: 300 · 일일 요청 수: 10,000
| 모델 | 일일 | 월간 |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.28 | $8.40 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.42 | $12.60 |
| MiniMax-M2.7$0.05$0.15 | $0.85 | $25.50 |
runs를 자신의 볼륨으로 바꾸고 각 모델의 총액을 읽으세요. 그런 다음 위 표를 사용해 두 번째 패스가 얼마나 추가될지 확인하세요.
Python 라우터: 두 번의 호출과 한 번의 검사#
두 모델 모두 하나의 OpenAI 호환 base URL과 하나의 잔액 뒤에 있으므로 라우팅에 두 번째 계정이나 키가 필요하지 않습니다. 아래 코드는 예시입니다. 코드 안의 숫자(max_tokens, UNSURE 규칙)는 직접 조정하세요. 두 번째 호출은 더 높은 max_tokens를 받으므로 600토큰에서 잘린 답변도 완성할 수 있습니다. Base URL, 모델 id 등은 CheapTokens 문서에 있습니다.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CHEAP = 'zai-org/GLM-5.3-Flash'
SECOND = 'deepseek-ai/DeepSeek-V4-Flash-0731'
SYSTEM = 'Answer briefly. If you cannot answer well, reply exactly UNSURE.'


def ask(model, question, max_tokens):
    r = client.chat.completions.create(
        model=model,
        max_tokens=max_tokens,
        messages=[
            {'role': 'system', 'content': SYSTEM},
            {'role': 'user', 'content': question},
        ],
    )
    choice = r.choices[0]
    return choice.message.content or '', choice.finish_reason


def needs_escalation(text, finish_reason):
    return finish_reason == 'length' or not text.strip() or 'UNSURE' in text


def answer(question):
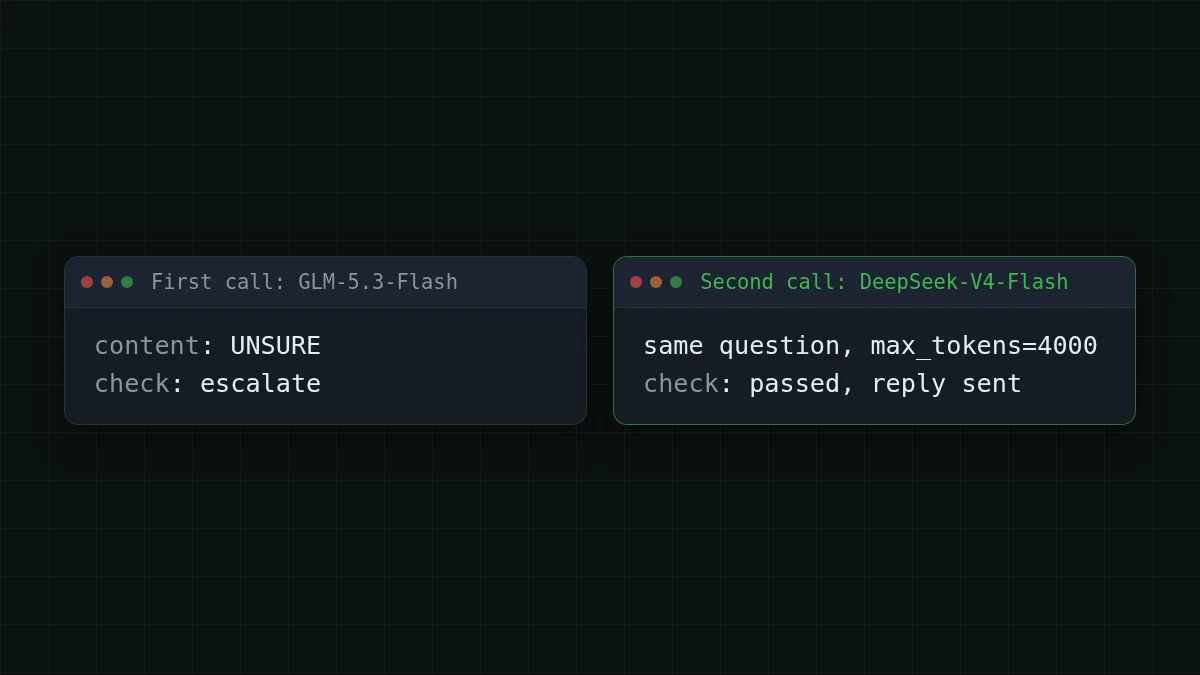
    text, why = ask(CHEAP, question, 600)
    if needs_escalation(text, why):
        text, why = ask(SECOND, question, 4000)
        if 'UNSURE' in text:
            text = 'Sorry, I could not answer this one.'
    return text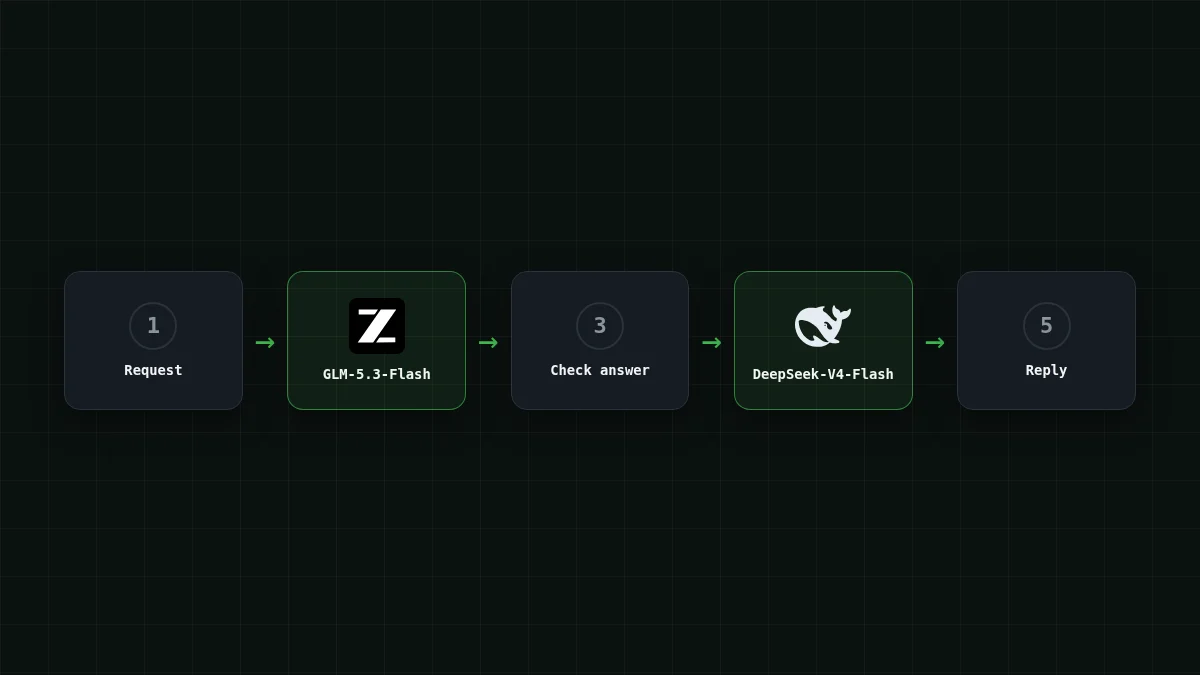
세 가지 습관이 이를 단순히 저렴한 것이 아니라 정직하게 만듭니다:
- 에스컬레이션 횟수를 세세요.
needs_escalation가 얼마나 자주 발생하는지 기록하세요. 그것이 p이며, 캐스케이드가 이득인지 결정하는 숫자입니다. - 자신의 테스트 세트로 두 번째 모델을 선택하세요. 로그에서 어려운 요청 50건을 가져와 두 모델 모두로 실행하고, 첫 번째 모델이 놓친 것을 두 번째 모델이 고칠 때만 두 번째 모델을 유지하세요. 문서화된 장점은 32,768토큰 답변 한도이며, 자신의 세트가 그것이 필요한 장점인지 보여줍니다.
- 더 긴 요청이 아니라 같은 요청을 보내세요. 실패한 답변을 두 번째 호출에 붙여넣으면 입력으로 비용을 지불합니다. 첫 번째 답변이 정말로 유용한 컨텍스트가 아니라면 두 번째 패스를 깨끗하게 시작하세요.
스스로 확인하기#
빠른 확인
캐스케이드에서 요청의 30%가 첫 모델에서 검사를 통과하지 못합니다. 해당 요청의 비용은 얼마인가요?
정답 보기
정답: 첫 모델의 가격에 두 번째 모델의 가격을 더한 값
첫 호출은 답변을 버릴 때 이미 청구됩니다. 에스컬레이션된 요청은 두 번 지불하므로 비율 p가 모든 것을 결정합니다.
다음 단계#
어떤 모델이 첫 번째 패스를 맡아야 할지 모르겠다면 MiniMax-M2.7 vs DeepSeek-V4-Flash가 작업별로 비교합니다. 토큰당이 아닌 작업당 관점은 1M 토큰당 가격 vs 작업당 비용을, 단계가 많은 루프는 AI 에이전트 비용 추정 방법을 참고하세요. 모든 모델의 실시간 가격은 가격 페이지에 있으며, 모델 페이지는 DeepSeek과 GLM입니다.


