लागत अनुकूलनगाइड
API लागत कम करने के लिए मॉडल रूटिंग: पहले सस्ता मॉडल, एस्केलेट करें
आसान अनुरोध सस्ते मॉडल को भेजें और केवल कठिन वाले एस्केलेट करें। 10%, 30% और 50% एस्केलेशन पर 10,000 अनुरोधों की मिश्रित लागत देखें, साथ ही एक छोटा Python राउटर।
इस पृष्ठ पर
रूटिंग बिल को कम कर सकती है जब सस्ते मॉडल का पहला पास दूसरे मॉडल की तुलना में बहुत सस्ता हो और कम अनुरोध एस्केलेट हों: हर अनुरोध पहले सस्ते मॉडल को भेजें और केवल कठिन वाले दूसरे मॉडल को फिर से भेजें। आप वास्तव में बचत करते हैं या नहीं, यह इस बात पर निर्भर करता है कि आप कितने अनुरोध एस्केलेट करते हैं। नीचे 10,000 अनुरोधों के लिए 10%, 30% और 50% पर गणना दी गई है, और एक Python फ़ंक्शन जिसे आप अपने प्रोजेक्ट में पेस्ट कर सकते हैं।
यह पैटर्न नया नहीं है। Anthropic की इंजीनियरिंग पोस्ट "Building effective agents" (19 दिसंबर 2024) इसे रूटिंग वर्कफ़्लो कहती है: सामान्य, आसान प्रश्न छोटे, लागत-कुशल मॉडल को जाते हैं, और असामान्य, कठिन प्रश्न अधिक सक्षम मॉडल को जाते हैं। पोस्ट में कोई कीमत नहीं दी गई है, इसलिए यहाँ की संख्याएँ हमारी अपनी हैं, लाइव CheapTokens कीमतों पर।
आपके कौन से अनुरोध आसान हैं?#
रूटिंग तभी काम करती है जब आप किसी नियम में बता सकें कि "कठिन" का क्या अर्थ है। किसी भावना में नहीं, बल्कि एक नियम में जिसे कोड जाँच सके। अपने मामले के सबसे निकट का चयन करें:
अपना मामला चुनें
अपना मामला चुनें
उत्तर देखने के लिए एक विकल्प चुनें
सपोर्ट चैटबॉट
अधिकांश टिकट छोटे FAQ होते हैं: मेरा ऑर्डर कहाँ है, पासवर्ड कैसे रीसेट करूँ। कुछ को लंबा, सावधानीपूर्वक उत्तर चाहिए। आसान: पहला मॉडल उत्तर देता है और UNSURE नहीं कहता। कठिन: यह UNSURE कहता है, या उत्तर कट जाता है (finish_reason length है)।
दस्तावेज़ पाइपलाइन
प्रत्येक दस्तावेज़ पहले निष्कर्षण से गुजरता है। आसान: परिणाम सभी आवश्यक फ़ील्ड के साथ वैध JSON के रूप में पार्स होता है। कठिन: पार्स विफल हो जाता है या कोई फ़ील्ड खाली है। केवल वे दस्तावेज़ दूसरे मॉडल पर फिर से चलाए जाते हैं।
कोडिंग एजेंट
सरल संपादन सस्ते मॉडल को जाते हैं। किसी चरण को एस्केलेट करें जब वही चरण लगातार दो बार विफल हो, या जब उत्तर कट गया हो (finish_reason length है)।
"मॉडल अनिश्चित लगता है" पर एस्केलेट न करें जब तक आपने उसे ऐसा कहने का तरीका न बताया हो। एक पंक्ति का निर्देश ("यदि आप उत्तर नहीं दे सकते तो ठीक UNSURE उत्तर दें") एक भावना को ऐसी चीज़ में बदल देता है जिसे if पढ़ सके।
10,000 अनुरोधों की लागत: कैस्केड बनाम राउटर#
मान लें कि आप प्रति माह 10,000 अनुरोधों वाला सपोर्ट बॉट चलाते हैं। औसत अनुरोध 800 टोकन इन और 300 टोकन आउट है। ये अनुमान हैं; अपने स्वयं के usage से बदलें (हमारा टोकन गणना लेख दिखाता है कि उन्हें कहाँ पढ़ना है)।
रूटिंग को वायर करने के दो तरीके हैं, और वे अलग-अलग बिल करते हैं:
- कैस्केड। प्रत्येक अनुरोध सस्ते मॉडल को जाता है। एक हिस्सा p जाँच में विफल होता है और दूसरे मॉडल को फिर से भेजा जाता है। उन अनुरोधों का दो बार भुगतान होता है: लागत = N × [सस्ता + p × दूसरा]।
- राउटर। एक छोटा क्लासिफायर कॉल पहले से निर्णय लेता है। आसान वाले सस्ते मॉडल को जाते हैं, कठिन वाले सीधे दूसरे को: लागत = N × [(1 − p) × सस्ता + p × दूसरा], साथ में प्रत्येक अनुरोध पर क्लासिफायर।
हम कैस्केड का उपयोग करेंगे, क्योंकि इसे किसी क्लासिफायर की आवश्यकता नहीं होती और यह शुरू करने में आसान है। पहला पास GLM-5.3-Flash (zai-, 390K संदर्भ, अधिकतम 8,192 आउटपुट टोकन) है। दूसरा पास DeepSeek-V4-Flash रिलीज़ 0731 (deepseek-, 380K संदर्भ, अधिकतम 32,768 आउटपुट टोकन) है, ताकि 8,192 टोकन में न फिट होने वाला उत्तर पूरा हो सके। दोनों कुल मिलाकर OpenRouter से सस्ते हैं, इनपुट और आउटपुट को एक साथ गिना गया है; नीचे दी गई लाइव तालिका हमारे कॉलम के बगल में OpenRouter कॉलम दिखाती है।
पहला पास हमेशा सभी 10,000 अनुरोधों को कवर करता है: 8,000,000 इनपुट और 3,000,000 आउटपुट टोकन। दूसरा पास केवल एस्केलेट किए गए हिस्से को कवर करता है। अंतिम कॉलम विकल्प है: सभी 10,000 अनुरोध सीधे दूसरे मॉडल पर।
तालिका को दाईं ओर स्क्रॉल करें →
| एस्केलेट किया गया हिस्सा | दूसरे पास के टोकन (इन / आउट) | पहला पास, सभी 10,000 | दूसरा पास, केवल एस्केलेट | सब कुछ दूसरे मॉडल पर, सभी 10,000 |
|---|---|---|---|---|
| 10% | 800,000 / 300,000 | $0.28 | $0.042 | $0.42 |
| 30% | 2,400,000 / 900,000 | $0.28 | $0.126 | $0.42 |
| 50% | 4,000,000 / 1,500,000 | $0.28 | $0.21 | $0.42 |
कैस्केड का माह प्राप्त करने के लिए प्रत्येक पंक्ति में पहले-पास और दूसरे-पास कॉलम जोड़ें, फिर उस योग की तुलना अंतिम कॉलम से करें। पहला पास एक निश्चित लागत है, और केवल दूसरा पास p के साथ बढ़ता है। यही कैस्केड की पूरी कहानी है: जितना अधिक आप एस्केलेट करते हैं, उतना ही आप काम के लिए दो बार भुगतान करने के करीब पहुँचते हैं।
यहाँ एक साथ हर मॉडल के लिए समान लोड दिया गया है, ताकि आप देख सकें कि एकल-मॉडल विकल्प कहाँ आते हैं:
| मॉडल | इनपुट $/1M | आउटपुट $/1M | प्रति अनुरोध | 10,000 अनुरोध | OpenRouter, 10,000 अनुरोध |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.28 | $0.517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.42 | $0.98 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.85 | $10.20 |
प्रति अनुरोध 800 इनपुट और 300 आउटपुट टोकन। प्रति 1M टोकन की कीमतें वर्तमान हैं और हमारे टैरिफ के साथ बदलती रहती हैं; OpenRouter कॉलम समान कार्यभार के लिए संदर्भ कीमतें दिखाता है।
कैस्केड कब लाभदायक नहीं होता? जब पहला पास और एस्केलेट किया गया हिस्सा मिलाकर सब कुछ दूसरे मॉडल को भेजने से अधिक महंगा हो जाता है। प्रतीकों में: सस्ता + p × दूसरा < दूसरा, जिसका अर्थ है p < 1 − सस्ता/दूसरा। इस जोड़ी के लिए, इस लोड पर पहला पास दूसरे मॉडल की कीमत का एक उल्लेखनीय हिस्सा है, इसलिए कैस्केड से लाभ घटता है, और उच्च एस्केलेशन हिस्से पर यह गायब हो जाता है। 50% पर कैस्केड सभी 10,000 अनुरोधों को सीधे दूसरे मॉडल को भेजने से हार सकता है, इसलिए प्रतिबद्ध होने से पहले दोनों पासों के योग की तुलना अंतिम कॉलम से करें। अनुपात आपके इनपुट/आउटपुट मिश्रण पर निर्भर करता है, क्योंकि दोनों मॉडल दोनों पक्षों की कीमत अलग-अलग तय करते हैं, इसलिए इसे अपनी पंक्ति से पढ़ें।
राउटर संस्करण एक चीज़ जोड़ता है: क्लासिफायर। मान लें कि यह प्रति अनुरोध सस्ते मॉडल पर 300 इनपुट टोकन पढ़ता है और 5 टोकन में उत्तर देता है। 10,000 अनुरोधों के लिए यह 3,000,000 इनपुट और 50,000 आउटपुट टोकन है, या ऊपर से $0.062 प्रति माह। इस पंक्ति की तुलना पहले-पास कॉलम के हिस्से p (उसका 10%, 30% या 50%) से करें: यही वह है जो कैस्केड उन अनुरोधों पर पहला पास चलाकर बर्बाद करता है जो फिर एस्केलेट होते हैं। यदि क्लासिफायर पंक्ति बड़ी है, तो कैस्केड सस्ता शुरुआत है; यदि यह छोटी है, तो राउटर अधिक बचाता है।
कुछ भी बनाने से पहले अपनी संख्याएँ आज़माएँ:
लागत कैलकुलेटर
सपोर्ट बॉट का एक महीना, सब कुछ एक मॉडल पर
प्रति अनुरोध इनपुट टोकन: 800 · प्रति अनुरोध आउटपुट टोकन: 300 · प्रति दिन अनुरोध: 10,000
| मॉडल | प्रति दिन | प्रति माह |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.28 | $8.40 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.42 | $12.60 |
| MiniMax-M2.7$0.05$0.15 | $0.85 | $25.50 |
runs को अपनी मात्रा में बदलें और प्रत्येक मॉडल के लिए कुल पढ़ें। फिर ऊपर दी गई तालिका का उपयोग यह देखने के लिए करें कि दूसरा पास इसमें कितना जोड़ेगा।
Python में एक राउटर: दो कॉल और एक जाँच#
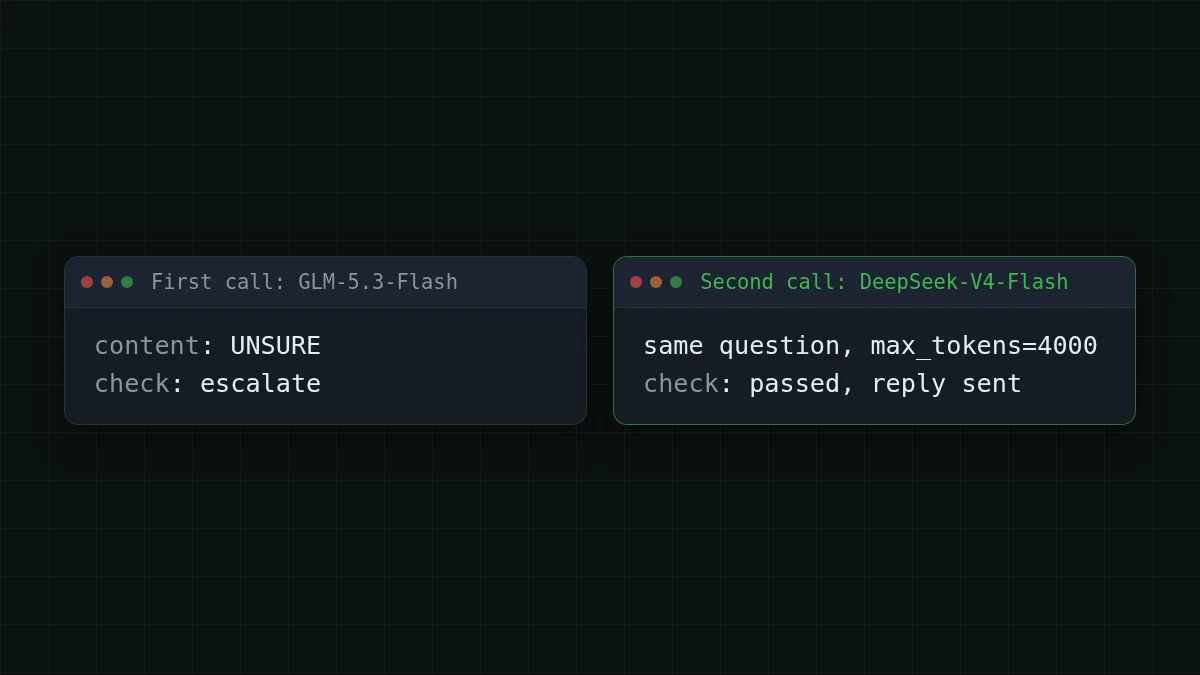
दोनों मॉडल एक OpenAI-संगत बेस URL और एक बैलेंस के पीछे हैं, इसलिए रूटिंग के लिए दूसरे खाते या कुंजी की आवश्यकता नहीं है। नीचे दिया गया कोड एक उदाहरण है: इसमें दी गई संख्याएँ (max_tokens, UNSURE नियम) आपके ट्यून करने के लिए हैं। दूसरे कॉल को उच्च max_tokens मिलता है, ताकि 600 टोकन पर कटा हुआ उत्तर पूरा हो सके। बेस URL, मॉडल आईडी और बाकी CheapTokens दस्तावेज़ में हैं।
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CHEAP = 'zai-org/GLM-5.3-Flash'
SECOND = 'deepseek-ai/DeepSeek-V4-Flash-0731'
SYSTEM = 'Answer briefly. If you cannot answer well, reply exactly UNSURE.'


def ask(model, question, max_tokens):
    r = client.chat.completions.create(
        model=model,
        max_tokens=max_tokens,
        messages=[
            {'role': 'system', 'content': SYSTEM},
            {'role': 'user', 'content': question},
        ],
    )
    choice = r.choices[0]
    return choice.message.content or '', choice.finish_reason


def needs_escalation(text, finish_reason):
    return finish_reason == 'length' or not text.strip() or 'UNSURE' in text


def answer(question):
    text, why = ask(CHEAP, question, 600)
    if needs_escalation(text, why):
        text, why = ask(SECOND, question, 4000)
        if 'UNSURE' in text:
            text = 'Sorry, I could not answer this one.'
    return text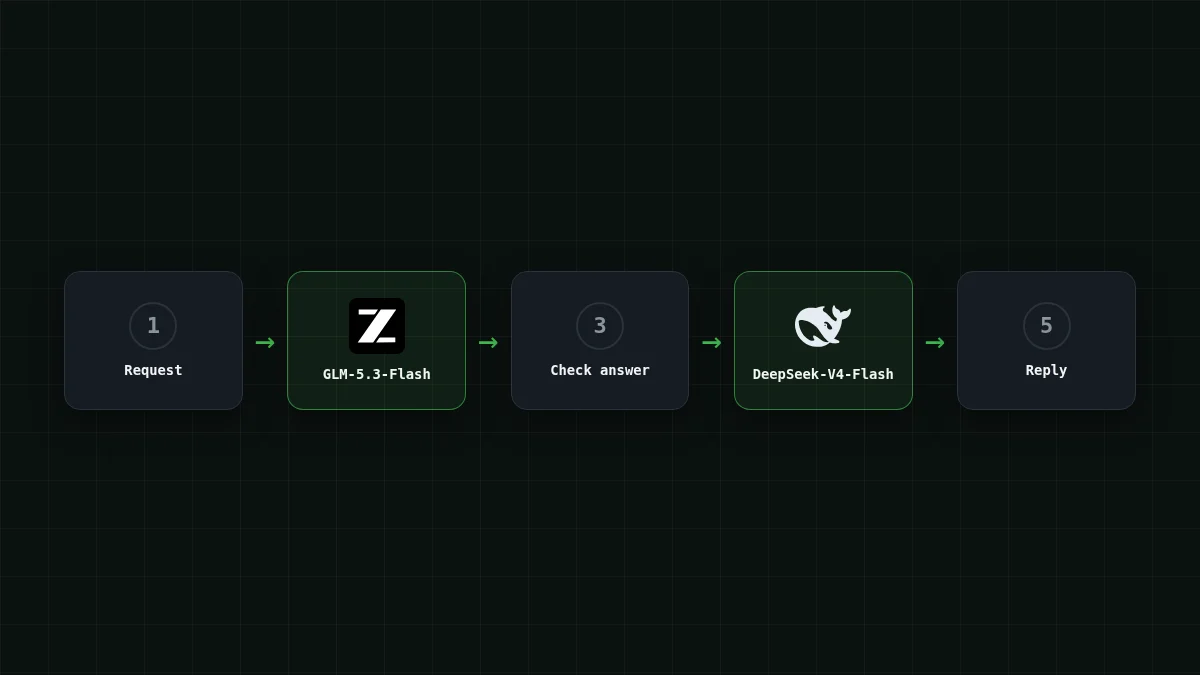
तीन आदतें इसे केवल सस्ता नहीं बल्कि ईमानदार बनाती हैं:
- एस्केलेशन गिनें। लॉग करें कि
needs_escalationकितनी बार सक्रिय होता है। वही आपका p है, और यही वह संख्या है जो तय करती है कि कैस्केड का भुगतान होता है या नहीं। - दूसरा मॉडल अपने स्वयं के परीक्षण सेट पर चुनें। अपने लॉग से 50 कठिन अनुरोध लें, उन्हें दोनों मॉडलों से चलाएँ और दूसरे मॉडल को केवल तभी रखें जब वह उन लोगों को ठीक करता है जिन्हें पहले ने छोड़ दिया। इसका प्रलेखित लाभ 32,768-टोकन उत्तर सीमा है, और आपका अपना सेट दिखाता है कि क्या वही लाभ आपको चाहिए।
- वही अनुरोध भेजें, लंबा नहीं। यदि आप विफल उत्तर को दूसरे कॉल में पेस्ट करते हैं, तो आप उसके लिए इनपुट के रूप में भुगतान करते हैं। दूसरा पास साफ़ शुरू करें जब तक कि पहला उत्तर वास्तव में उपयोगी संदर्भ न हो।
स्वयं जाँचें#
त्वरित जाँच
एक कैस्केड में, 30% अनुरोध पहले मॉडल पर जाँच में विफल होते हैं। उन अनुरोधों की लागत क्या है?
उत्तर दिखाएँ
उत्तर: पहले मॉडल की कीमत प्लस दूसरे मॉडल की कीमत
पहला कॉल पहले से ही बिल हो चुका है जब आप उसका उत्तर फेंक देते हैं। एस्केलेट किए गए अनुरोध दो बार भुगतान करते हैं, यही कारण है कि हिस्सा p सब कुछ तय करता है।
आगे कहाँ जाएँ#
यदि आप निश्चित नहीं हैं कि पहला पास किस मॉडल को लेना चाहिए, तो MiniMax-M2.7 बनाम DeepSeek-V4-Flash उनकी कार्य के अनुसार तुलना करता है। प्रति-टोकन के बजाय प्रति-कार्य दृश्य के लिए, प्रति 1M टोकन कीमत बनाम प्रति कार्य लागत देखें, और कई चरणों वाले लूप के लिए, AI एजेंट की लागत का अनुमान कैसे लगाएँ। हर मॉडल के लाइव मूल्य मूल्य निर्धारण पृष्ठ पर हैं, और मॉडल पृष्ठ हैं DeepSeek और GLM।


