খরচ অপ্টিমাইজেশনগাইড
API খরচ কমাতে মডেল রাউটিং: প্রথমে সস্তা মডেল, এসকেলেট করুন
সহজ অনুরোধগুলি একটি সস্তা মডেলে পাঠান এবং শুধুমাত্র কঠিনগুলি এসকেলেট করুন। ১০%, ৩০% এবং ৫০% এসকেলেশনে ১০,০০০ অনুরোধের মিশ্র খরচ দেখুন, সাথে একটি সংক্ষিপ্ত Python রাউটার।
এই পৃষ্ঠায়
রাউটিং বিল কমাতে পারে যখন সস্তা মডেলের প্রথম পাস দ্বিতীয় মডেলের চেয়ে অনেক সস্তা হয় এবং খুব কম অনুরোধ এসকেলেট হয়: প্রতিটি অনুরোধ প্রথমে সস্তা মডেলে পাঠান এবং শুধুমাত্র কঠিনগুলো দ্বিতীয় মডেলে পুনরায় পাঠান। আপনি আসলে সাশ্রয় করবেন কিনা তা নির্ভর করে আপনি কত শতাংশ অনুরোধ এসকেলেট করেন তার উপর। নিচে ১০,০০০ অনুরোধের জন্য ১০%, ৩০% এবং ৫০% হারে হিসাব এবং একটি Python ফাংশন দেওয়া আছে যা আপনি আপনার প্রজেক্টে পেস্ট করতে পারেন।
প্যাটার্নটি নতুন নয়। Anthropic-এর ইঞ্জিনিয়ারিং পোস্ট "Building effective agents" (১৯ ডিসেম্বর ২০২৪) এটিকে রাউটিং ওয়ার্কফ্লো বলে: সাধারণ, সহজ প্রশ্নগুলি ছোট, সাশ্রয়ী মডেলে যায়, এবং অস্বাভাবিক, কঠিন প্রশ্নগুলি আরও সক্ষম মডেলে যায়। পোস্টে কোনো দাম দেওয়া নেই, তাই এখানে সংখ্যাগুলি আমাদের নিজস্ব, লাইভ CheapTokens দামের উপর ভিত্তি করে।
আপনার কোন অনুরোধগুলি সহজ?#
রাউটিং শুধুমাত্র তখনই কাজ করে যদি আপনি একটি নিয়মে বলতে পারেন "কঠিন" মানে কী। কোনো অনুভূতিতে নয়, একটি নিয়মে যা কোড যাচাই করতে পারে। আপনার ক্ষেত্রের সবচেয়ে কাছাকাছি কেসটি বেছে নিন:
আপনার কেস বেছে নিন
আপনার কেস বেছে নিন
উত্তর দেখতে একটি বিকল্প বেছে নিন
সাপোর্ট চ্যাটবট
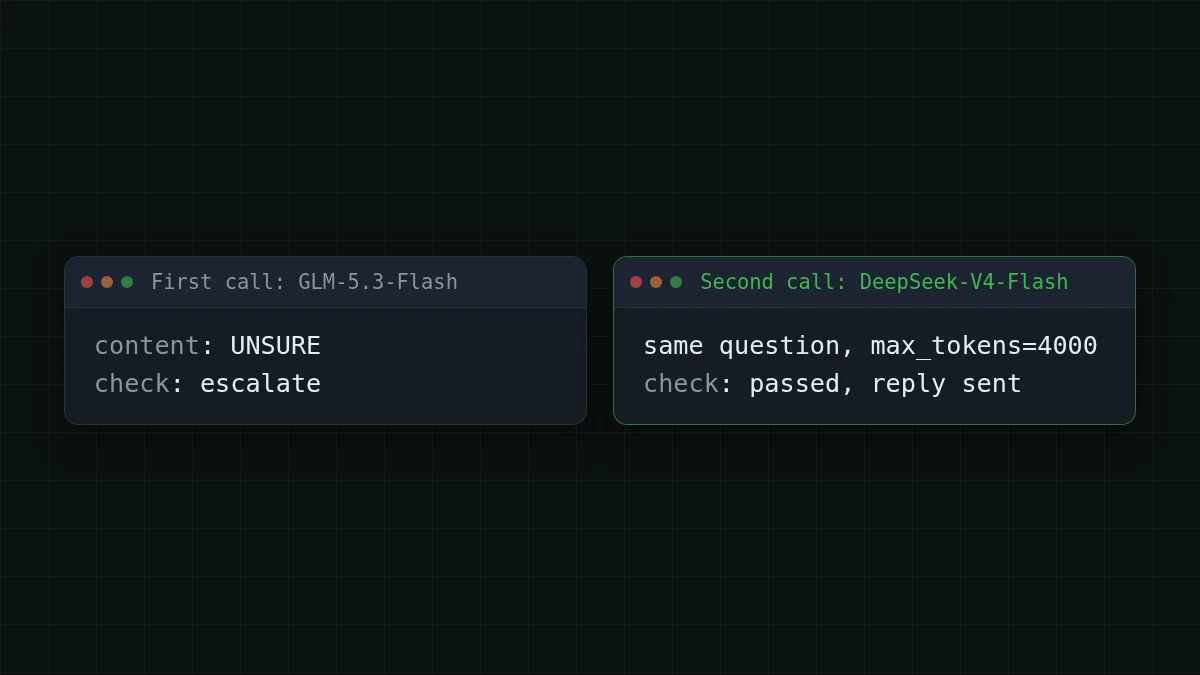
বেশিরভাগ টিকিট ছোট FAQ: আমার অর্ডার কোথায়, পাসওয়ার্ড কীভাবে রিসেট করব। কয়েকটির জন্য দীর্ঘ, সতর্ক উত্তর প্রয়োজন। সহজ: প্রথম মডেল উত্তর দেয় এবং UNSURE বলে না। কঠিন: এটি UNSURE বলে, অথবা উত্তরটি কেটে যায় (finish_reason হল length)।
ডকুমেন্ট পাইপলাইন
প্রতিটি ডকুমেন্ট প্রথমে এক্সট্র্যাকশনের মধ্য দিয়ে যায়। সহজ: ফলাফলটি সমস্ত প্রয়োজনীয় ফিল্ড সহ বৈধ JSON হিসাবে পার্স হয়। কঠিন: পার্স ব্যর্থ হয় বা একটি ফিল্ড খালি। শুধুমাত্র সেই ডকুমেন্টগুলি দ্বিতীয় মডেলে পুনরায় চালানো হয়।
কোডিং এজেন্ট
সহজ সম্পাদনা সস্তা মডেলে যায়। একটি ধাপ এসকেলেট করুন যখন একই ধাপ পরপর দুবার ব্যর্থ হয়, অথবা যখন উত্তরটি কেটে যায় (finish_reason হল length)।
"মডেলটি অনিশ্চিত শোনাচ্ছে" বলে এসকেলেট করবেন না যদি না আপনি এটিকে তা বলার উপায় না দেন। একটি এক-লাইন নির্দেশ ("যদি আপনি উত্তর দিতে না পারেন তবে ঠিক UNSURE উত্তর দিন") একটি ভাবনাকে এমন কিছুতে পরিণত করে যা if পড়তে পারে।
১০,০০০ অনুরোধের খরচ: ক্যাসকেড বনাম রাউটার#
ধরুন আপনি মাসে ১০,০০০ অনুরোধ সহ একটি সাপোর্ট বট চালান। একটি গড় অনুরোধে ৮০০ টোকেন ইন এবং ৩০০ টোকেন আউট। এগুলি অনুমান; usage থেকে আপনার নিজেরটি বসান (আমাদের টোকেন গণনা নিবন্ধ দেখায় কোথায় পড়তে হবে)।
রাউটিং সংযোগ করার দুটি উপায় আছে, এবং তারা ভিন্নভাবে বিল করে:
- ক্যাসকেড। প্রতিটি অনুরোধ সস্তা মডেলে যায়। একটি অংশ p চেক ব্যর্থ হয় এবং দ্বিতীয় মডেলে আবার পাঠানো হয়। সেই অনুরোধগুলির জন্য দুবার অর্থ প্রদান করা হয়: খরচ = N × [সস্তা + p × দ্বিতীয়]।
- রাউটার। একটি ছোট ক্লাসিফায়ার কল আগে থেকেই সিদ্ধান্ত নেয়। সহজগুলি সস্তা মডেলে যায়, কঠিনগুলি সরাসরি দ্বিতীয়টিতে: খরচ = N × [(1 − p) × সস্তা + p × দ্বিতীয়], প্লাস প্রতিটি অনুরোধে ক্লাসিফায়ার।
আমরা ক্যাসকেড ব্যবহার করব, কারণ এতে কোনো ক্লাসিফায়ার প্রয়োজন হয় না এবং এটি শুরু করা সহজ। প্রথম পাস হল GLM-5.3-Flash (zai-, 390K কনটেক্সট, সর্বোচ্চ 8,192 আউটপুট টোকেন)। দ্বিতীয় পাস হল DeepSeek-V4-Flash রিলিজ 0731 (deepseek-, 380K কনটেক্সট, সর্বোচ্চ 32,768 আউটপুট টোকেন), তাই যে উত্তরটি 8,192 টোকেনে ফিট হয়নি তা শেষ করার জায়গা আছে। উভয়ই OpenRouter-এর চেয়ে মোটে সস্তা, ইনপুট এবং আউটপুট একসাথে গণনা করা হয়; নিচের লাইভ টেবিলটি আমাদের পাশে OpenRouter কলাম দেখায়।
প্রথম পাস সর্বদা সমস্ত ১০,০০০ অনুরোধ কভার করে: 8,000,000 ইনপুট এবং 3,000,000 আউটপুট টোকেন। দ্বিতীয় পাস শুধুমাত্র এসকেলেটেড অংশ কভার করে। শেষ কলামটি হল বিকল্প: সমস্ত ১০,০০০ অনুরোধ সরাসরি দ্বিতীয় মডেলে।
টেবিলটি ডানদিকে স্ক্রোল করুন →
| এসকেলেটেড অংশ | দ্বিতীয় পাসের টোকেন (ইন / আউট) | প্রথম পাস, সমস্ত ১০,০০০ | দ্বিতীয় পাস, শুধুমাত্র এসকেলেটেড | দ্বিতীয় মডেলে সবকিছু, সমস্ত ১০,০০০ |
|---|---|---|---|---|
| ১০% | 800,000 / 300,000 | $0.28 | $0.042 | $0.42 |
| ৩০% | 2,400,000 / 900,000 | $0.28 | $0.126 | $0.42 |
| ৫০% | 4,000,000 / 1,500,000 | $0.28 | $0.21 | $0.42 |
প্রতিটি সারিতে প্রথম-পাস এবং দ্বিতীয়-পাস কলাম যোগ করে ক্যাসকেডের মাসিক খরচ পান, তারপর সেই যোগফলকে শেষ কলামের সাথে তুলনা করুন। প্রথম পাস একটি নির্দিষ্ট খরচ, এবং শুধুমাত্র দ্বিতীয় পাস p এর সাথে বাড়ে। এটাই ক্যাসকেডের পুরো গল্প: আপনি যত বেশি এসকেলেট করবেন, তত বেশি কাজের জন্য দুবার অর্থ প্রদানের কাছাকাছি পৌঁছাবেন।
এখানে একসাথে প্রতিটি মডেলের জন্য একই লোড দেওয়া হল, যাতে আপনি দেখতে পারেন একক-মডেল বিকল্পগুলি কোথায় পড়ে:
| মডেল | ইনপুট $/১ মিলিয়ন | আউটপুট $/১ মিলিয়ন | প্রতি অনুরোধে | ১০,০০০টি অনুরোধ | OpenRouter, ১০,০০০টি অনুরোধ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.28 | $0.517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.42 | $0.98 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.85 | $10.20 |
প্রতি অনুরোধে ৮০০ ইনপুট এবং ৩০০ আউটপুট টোকেন। প্রতি 1M টোকেনের দাম বর্তমান এবং আমাদের ট্যারিফের সাথে পরিবর্তিত হয়; OpenRouter কলামটি একই ওয়ার্কলোডের জন্য রেফারেন্স মূল্য দেখায়।
কখন ক্যাসকেড মূল্যবান নয়? যখন প্রথম পাস প্লাস এসকেলেটেড অংশ দ্বিতীয় মডেলে সবকিছু পাঠানোর চেয়ে বেশি খরচ করে। প্রতীকে: সস্তা + p × দ্বিতীয় < দ্বিতীয়, যার মানে p < 1 − সস্তা/দ্বিতীয়। এই জোড়ার জন্য, প্রথম পাস এই লোডে দ্বিতীয় মডেলের দামের একটি লক্ষণীয় অংশ খরচ করে, তাই ক্যাসকেড থেকে লাভ কমে যায়, এবং উচ্চ এসকেলেশন অংশে এটি অদৃশ্য হয়ে যায়। ৫০% এ ক্যাসকেড সমস্ত ১০,০০০ অনুরোধ সরাসরি দ্বিতীয় মডেলে পাঠানোর কাছে হেরে যেতে পারে, তাই প্রতিশ্রুতিবদ্ধ হওয়ার আগে দুটি পাসের যোগফল শেষ কলামের সাথে পরীক্ষা করুন। অনুপাতটি আপনার ইনপুট/আউটপুট মিশ্রণের উপর নির্ভর করে, কারণ দুটি মডেল দুটি দিককে ভিন্নভাবে মূল্য দেয়, তাই এটি আপনার নিজের সারি থেকে পড়ুন।
রাউটার ভ্যারিয়েন্ট একটি জিনিস যোগ করে: ক্লাসিফায়ার। ধরুন এটি প্রতি অনুরোধে সস্তা মডেলে ৩০০ ইনপুট টোকেন পড়ে এবং ৫ টোকেনে উত্তর দেয়। ১০,০০০ অনুরোধের জন্য এটি 3,000,000 ইনপুট এবং 50,000 আউটপুট টোকেন, বা মাসে অতিরিক্ত $0.062। এই লাইনটি প্রথম-পাস কলামের p অংশের (এর ১০%, ৩০% বা ৫০%) সাথে তুলনা করুন: ক্যাসকেড সেই অনুরোধগুলিতে প্রথম পাস চালিয়ে যা নষ্ট করে যা পরে এসকেলেট হয়। যদি ক্লাসিফায়ার লাইনটি বড় হয়, ক্যাসকেড সস্তা শুরু; যদি এটি ছোট হয়, একটি রাউটার আরও সাশ্রয় করে।
কিছু তৈরি করার আগে আপনার নিজের সংখ্যা চেষ্টা করুন:
খরচ ক্যালকুলেটর
একটি সাপোর্ট বটের এক মাস, একটি মডেলে সবকিছু
প্রতি অনুরোধে ইনপুট টোকেন: ৮০০ · প্রতি অনুরোধে আউটপুট টোকেন: ৩০০ · প্রতিদিন অনুরোধ: ১০,০০০
| মডেল | প্রতিদিন | প্রতি মাসে |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.28 | $8.40 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.42 | $12.60 |
| MiniMax-M2.7$0.05$0.15 | $0.85 | $25.50 |
runs আপনার ভলিউমে পরিবর্তন করুন এবং প্রতিটি মডেলের মোট পড়ুন। তারপর উপরের টেবিলটি ব্যবহার করে দেখুন একটি দ্বিতীয় পাস কতটা যোগ করবে।
Python-এ একটি রাউটার: দুটি কল এবং একটি চেক#
উভয় মডেল একটি OpenAI-সামঞ্জস্যপূর্ণ বেস URL এবং একটি ব্যালেন্সের পিছনে থাকে, তাই রাউটিংয়ের জন্য দ্বিতীয় অ্যাকাউন্ট বা কী প্রয়োজন হয় না। নিচের কোডটি একটি উদাহরণ: এতে থাকা সংখ্যাগুলি (max_tokens, UNSURE নিয়ম) আপনার টিউন করার জন্য। দ্বিতীয় কলে একটি উচ্চতর max_tokens পায়, তাই ৬০০ টোকেনে কেটে যাওয়া একটি উত্তর শেষ করতে পারে। বেস URL, মডেল আইডি এবং বাকিগুলি CheapTokens ডক্স এ আছে।
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CHEAP = 'zai-org/GLM-5.3-Flash'
SECOND = 'deepseek-ai/DeepSeek-V4-Flash-0731'
SYSTEM = 'Answer briefly. If you cannot answer well, reply exactly UNSURE.'


def ask(model, question, max_tokens):
    r = client.chat.completions.create(
        model=model,
        max_tokens=max_tokens,
        messages=[
            {'role': 'system', 'content': SYSTEM},
            {'role': 'user', 'content': question},
        ],
    )
    choice = r.choices[0]
    return choice.message.content or '', choice.finish_reason


def needs_escalation(text, finish_reason):
    return finish_reason == 'length' or not text.strip() or 'UNSURE' in text


def answer(question):
    text, why = ask(CHEAP, question, 600)
    if needs_escalation(text, why):
        text, why = ask(SECOND, question, 4000)
        if 'UNSURE' in text:
            text = 'Sorry, I could not answer this one.'
    return text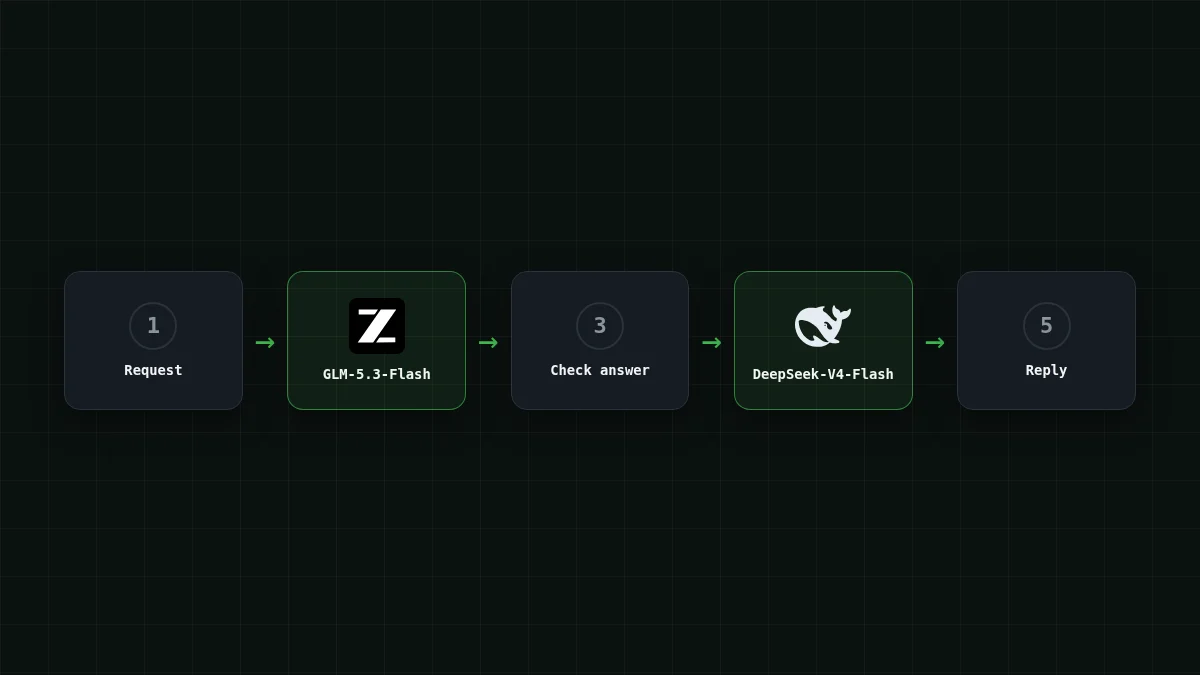
তিনটি অভ্যাস এটিকে শুধু সস্তা নয় বরং সৎ করে তোলে:
- এসকেলেশন গণনা করুন। লগ করুন
needs_escalationকতবার আগুন দেয়। সেটাই আপনার p, এবং এটাই সেই সংখ্যা যা নির্ধারণ করে ক্যাসকেড লাভজনক কিনা। - আপনার নিজের টেস্ট সেটে দ্বিতীয় মডেল বেছে নিন। আপনার লগ থেকে ৫০টি কঠিন অনুরোধ নিন, সেগুলি উভয় মডেলের মাধ্যমে চালান এবং দ্বিতীয় মডেলটি শুধুমাত্র তখনই রাখুন যদি এটি প্রথমটির মিস করা গুলি ঠিক করে। এর নথিভুক্ত সুবিধা হল 32,768-টোকেন উত্তর সীমা, এবং আপনার নিজের সেট দেখায় যে এটি আপনার প্রয়োজনীয় সুবিধা কিনা।
- একই অনুরোধ পাঠান, দীর্ঘতর নয়। যদি আপনি ব্যর্থ উত্তরটি দ্বিতীয় কলে পেস্ট করেন, আপনি এটির জন্য ইনপুট হিসাবে অর্থ প্রদান করেন। দ্বিতীয় পাস পরিষ্কারভাবে শুরু করুন যদি না প্রথম উত্তরটি সত্যিই উপযোগী প্রসঙ্গ হয়।
নিজেকে পরীক্ষা করুন#
দ্রুত যাচাই
একটি ক্যাসকেডে, ৩০% অনুরোধ প্রথম মডেলে চেকে ব্যর্থ হয়। সেই অনুরোধগুলির খরচ কত?
উত্তর দেখান
উত্তর: প্রথম মডেলের দাম প্লাস দ্বিতীয় মডেলের দাম
প্রথম কল ইতিমধ্যে বিল করা হয় যখন আপনি এর উত্তর ফেলে দেন। এসকেলেটেড অনুরোধ দুবার অর্থ প্রদান করে, যার কারণে p অংশ সবকিছু নির্ধারণ করে।
এরপর কোথায় যাবেন#
যদি আপনি নিশ্চিত না হন কোন মডেল প্রথম পাস নেবে, MiniMax-M2.7 vs DeepSeek-V4-Flash কাজ অনুসারে তাদের তুলনা করে। প্রতি-টোকেনের পরিবর্তে প্রতি-কাজের দৃশ্যের জন্য, দেখুন প্রতি 1M টোকেনের দাম বনাম প্রতি কাজের খরচ, এবং অনেক ধাপের লুপের জন্য, কীভাবে একটি AI এজেন্টের খরচ অনুমান করবেন। প্রতিটি মডেলের লাইভ দাম প্রাইসিং পেজে আছে, এবং মডেল পেজগুলি হল DeepSeek এবং GLM।


