Model routing para bawasan ang API cost: murang modelo muna, i-escalate
Ipadala ang madaling request sa murang modelo at i-escalate lamang ang mahihirap. Tingnan ang blended cost ng 10,000 request sa 10%, 30% at 50% escalation, kasama ang maikling Python router.
Sa pahinang ito
Maaaring bawasan ng routing ang bill kapag ang unang pass ng murang modelo ay mas mura kaysa sa pangalawang modelo at kakaunti lang ang nag-e-escalate: ipadala muna ang bawat request sa murang modelo at ipadala muli lamang ang mahihirap sa pangalawang modelo. Kung talagang makakatipid ka ay depende sa bahagi ng mga request na ini-escalate mo. Nasa ibaba ang aritmetika para sa 10,000 request sa 10%, 30% at 50%, at isang Python function na maaari mong i-paste sa iyong proyekto.
Hindi bago ang pattern. Tinatawag ito ng engineering post ng Anthropic na "Building effective agents" (19 Disyembre 2024) na routing workflow: ang karaniwan at madaling tanong ay napupunta sa mas maliit at cost-efficient na modelo, at ang hindi karaniwan at mahirap ay napupunta sa mas may kakayahang modelo. Walang presyo ang post, kaya ang mga numero dito ay sa amin, batay sa live na presyo ng CheapTokens.
Alin sa iyong mga request ang madali?#
Gumagana lang ang routing kung masasabi mo, sa isang panuntunan, kung ano ang ibig sabihin ng "mahirap." Hindi sa pakiramdam, kundi sa panuntunang masusuri ng code. Piliin ang kaso na pinakamalapit sa iyo:
Piliin ang iyong kaso
Piliin ang iyong kaso
Pumili ng opsyon upang makita ang sagot
Support chatbot
Karamihan sa mga ticket ay maiikling FAQ: nasaan ang order ko, paano i-reset ang password. Ilan ang nangangailangan ng mahaba at maingat na sagot. Madali: sumagot ang unang modelo at hindi nag-reply ng UNSURE. Mahirap: sinabi nito ang UNSURE, o naputol ang sagot (ang finish_reason ay length).
Document pipeline
Bawat dokumento ay dumadaan muna sa extraction. Madali: ang resulta ay nagpa-parse bilang valid na JSON na may lahat ng kinakailangang field. Mahirap: nabigo ang parse o may field na walang laman. Ang mga dokumentong iyon lang ang muling pinapatakbo sa pangalawang modelo.
Coding agent
Ang simpleng edit ay napupunta sa murang modelo. I-escalate ang isang hakbang kapag nabigo ito nang dalawang beses nang sunod-sunod, o kapag naputol ang sagot (ang finish_reason ay length).
Huwag mag-escalate batay sa "parang hindi sigurado ang modelo" maliban kung sinabi mo rito kung paano sabihin iyon. Ang isang linyang instruksyon ("sumagot nang eksaktong UNSURE kung hindi mo masagot") ay ginagawang bagay na mababasa ng if ang isang pakiramdam.
Magkano ang 10,000 request: cascade vs router#
Sabihin nating may support bot ka na may 10,000 request kada buwan. Ang karaniwang request ay 800 token in at 300 token out. Mga assumption ito; palitan ng sarili mo mula sa usage (ipinapakita ng aming artikulo tungkol sa token count kung saan ito babasahin).
May dalawang paraan para i-wire ang routing, at magkaiba ang singil nila:
- Cascade. Bawat request ay napupunta sa murang modelo. Isang bahagi p ang nabibigo sa check at ipinapadala muli sa pangalawang modelo. Dalawang beses binabayaran ang mga request na iyon: cost = N × [cheap + p × second].
- Router. Isang maliit na classifier call ang nagpapasya nang maaga. Ang madali ay napupunta sa murang modelo, ang mahirap ay diretso sa pangalawa: cost = N × [(1 − p) × cheap + p × second], kasama ang classifier sa bawat request.
Gagamitin namin ang cascade, dahil hindi ito nangangailangan ng classifier at ito ang mas madaling simulan. Ang unang pass ay GLM-5.3-Flash (zai-, 390K context, hanggang 8,192 output token). Ang pangalawang pass ay DeepSeek-V4-Flash release 0731 (deepseek-, 380K context, hanggang 32,768 output token), kaya may espasyo pang matapos ang sagot na hindi kasya sa 8,192 token. Pareho silang mas mura kaysa OpenRouter sa kabuuan, kung pagsasamahin ang input at output; ipinapakita ng live na table sa ibaba ang OpenRouter column sa tabi ng sa amin.
Ang unang pass ay laging sumasaklaw sa lahat ng 10,000 request: 8,000,000 input at 3,000,000 output token. Ang pangalawang pass ay sumasaklaw lamang sa na-escalate na bahagi. Ang huling column ay ang alternatibo: lahat ng 10,000 request diretso sa pangalawang modelo.
I-scroll ang table pakanan →
| Na-escalate na bahagi | Pangalawang-pass na token (in / out) | Unang pass, lahat ng 10,000 | Pangalawang pass, na-escalate lamang | Lahat sa pangalawang modelo, lahat ng 10,000 |
|---|---|---|---|---|
| 10% | 800,000 / 300,000 | $0.28 | $0.042 | $0.42 |
| 30% | 2,400,000 / 900,000 | $0.28 | $0.126 | $0.42 |
| 50% | 4,000,000 / 1,500,000 | $0.28 | $0.21 | $0.42 |
Pagsamahin ang unang-pass at pangalawang-pass na column sa bawat row para makuha ang buwan ng cascade, pagkatapos ihambing ang kabuuan sa huling column. Ang unang pass ay fixed cost, at ang pangalawang pass lang ang lumalaki kasama ng p. Iyon ang buong kuwento ng cascade: habang mas marami kang ini-escalate, mas lumalapit ka sa pagbabayad nang dalawang beses para sa trabaho.
Narito ang parehong load para sa lahat ng modelo nang sabay, para makita mo kung saan napupunta ang mga single-model na opsyon:
| Modelo | Input $/1M | Output $/1M | Bawat kahilingan | 10,000 mga kahilingan | OpenRouter, 10,000 mga kahilingan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.28 | $0.517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.42 | $0.98 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.85 | $10.20 |
800 input at 300 output na token bawat kahilingan. Ang mga presyo kada 1M token ay kasalukuyan at nagbabago kasabay ng aming mga taripa; ang column ng OpenRouter ay nagpapakita ng reference na presyo para sa parehong workload.
Kailan hindi sulit ang cascade? Kapag ang unang pass kasama ang na-escalate na bahagi ay mas mahal kaysa sa ipadala lahat sa pangalawang modelo. Sa simbolo: cheap + p × second < second, na nangangahulugang p < 1 − cheap/second. Para sa pares na ito, ang unang pass ay nagkakahalaga ng kapansin-pansing bahagi ng presyo ng pangalawang modelo sa load na ito, kaya lumiliit ang pakinabang mula sa cascade, at sa mataas na escalation share ay nawawala ito. Sa 50% maaaring matalo ang cascade sa simpleng pagpapadala ng lahat ng 10,000 request sa pangalawang modelo, kaya suriin ang kabuuan ng dalawang pass laban sa huling column bago ka mag-commit. Ang ratio ay depende sa iyong input/output mix, dahil magkaiba ang presyo ng dalawang modelo sa dalawang panig, kaya basahin ito mula sa sarili mong row.
Ang router variant ay nagdadagdag ng isang bagay: ang classifier. Ipagpalagay na nagbabasa ito ng 300 input token at sumasagot ng 5 token sa murang modelo, kada request. Para sa 10,000 request, iyon ay 3,000,000 input at 50,000 output token, o $0.062 kada buwan sa ibabaw. Ihambing ang linyang ito sa bahagi p ng unang-pass column (10%, 30% o 50% nito): iyon ang sinasayang ng cascade sa pagpapatakbo ng unang pass sa mga request na nag-e-escalate. Kung mas malaki ang classifier line, ang cascade ang mas murang simula; kung mas maliit, mas nakakatipid ang router.
Subukan ang sarili mong numero bago ka magtayo ng kahit ano:
Calculator ng gastos
Isang buwan ng support bot, lahat sa isang modelo
Mga input token bawat kahilingan: 800 · Mga output token bawat kahilingan: 300 · Mga kahilingan bawat araw: 10,000
| Modelo | Bawat araw | Bawat buwan |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.28 | $8.40 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.42 | $12.60 |
| MiniMax-M2.7$0.05$0.15 | $0.85 | $25.50 |
Palitan ang runs ng iyong volume at basahin ang total para sa bawat modelo. Pagkatapos gamitin ang table sa itaas para makita kung magkano ang idadagdag ng pangalawang pass.
Isang router sa Python: dalawang call at isang check#
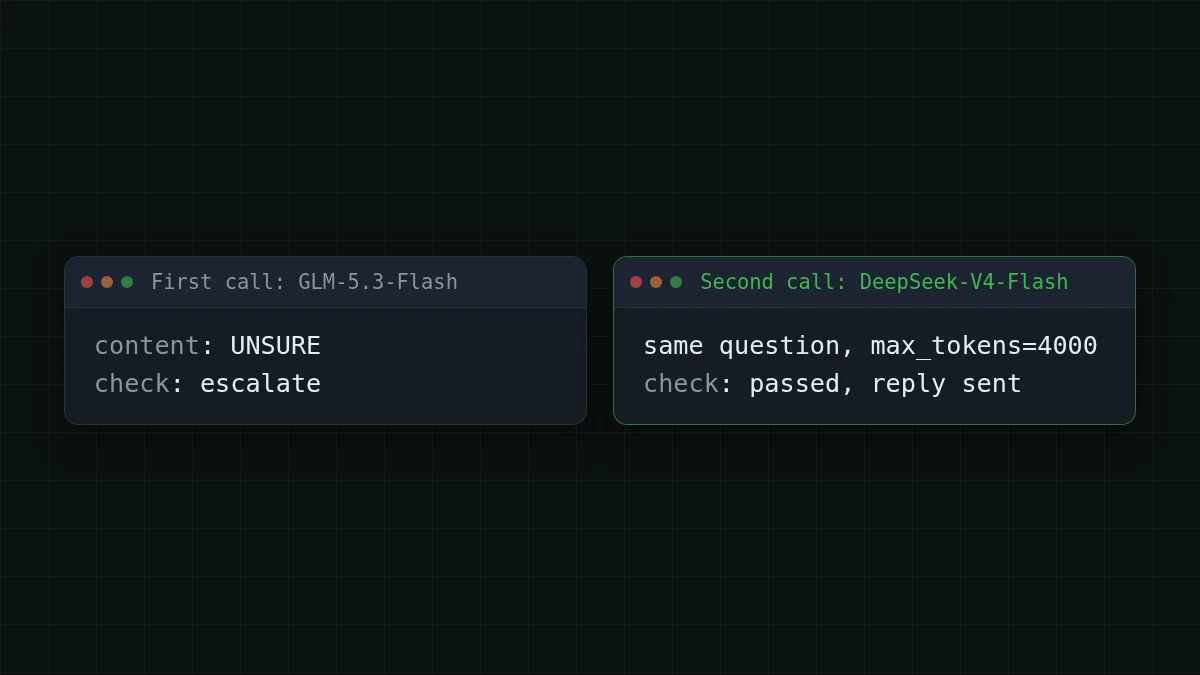
Parehong modelo ay nasa likod ng isang OpenAI-compatible na base URL at isang balance, kaya hindi kailangan ng routing ng pangalawang account o key. Ang code sa ibaba ay halimbawa: ang mga numero sa loob nito (max_tokens, ang UNSURE rule) ay sa iyo para i-tune. Ang pangalawang call ay may mas mataas na max_tokens, kaya ang sagot na naputol sa 600 token ay makakatapos. Ang base URL, model ids at iba pa ay nasa CheapTokens docs.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CHEAP = 'zai-org/GLM-5.3-Flash'
SECOND = 'deepseek-ai/DeepSeek-V4-Flash-0731'
SYSTEM = 'Answer briefly. If you cannot answer well, reply exactly UNSURE.'


def ask(model, question, max_tokens):
    r = client.chat.completions.create(
        model=model,
        max_tokens=max_tokens,
        messages=[
            {'role': 'system', 'content': SYSTEM},
            {'role': 'user', 'content': question},
        ],
    )
    choice = r.choices[0]
    return choice.message.content or '', choice.finish_reason


def needs_escalation(text, finish_reason):
    return finish_reason == 'length' or not text.strip() or 'UNSURE' in text


def answer(question):
    text, why = ask(CHEAP, question, 600)
    if needs_escalation(text, why):
        text, why = ask(SECOND, question, 4000)
        if 'UNSURE' in text:
            text = 'Sorry, I could not answer this one.'
    return text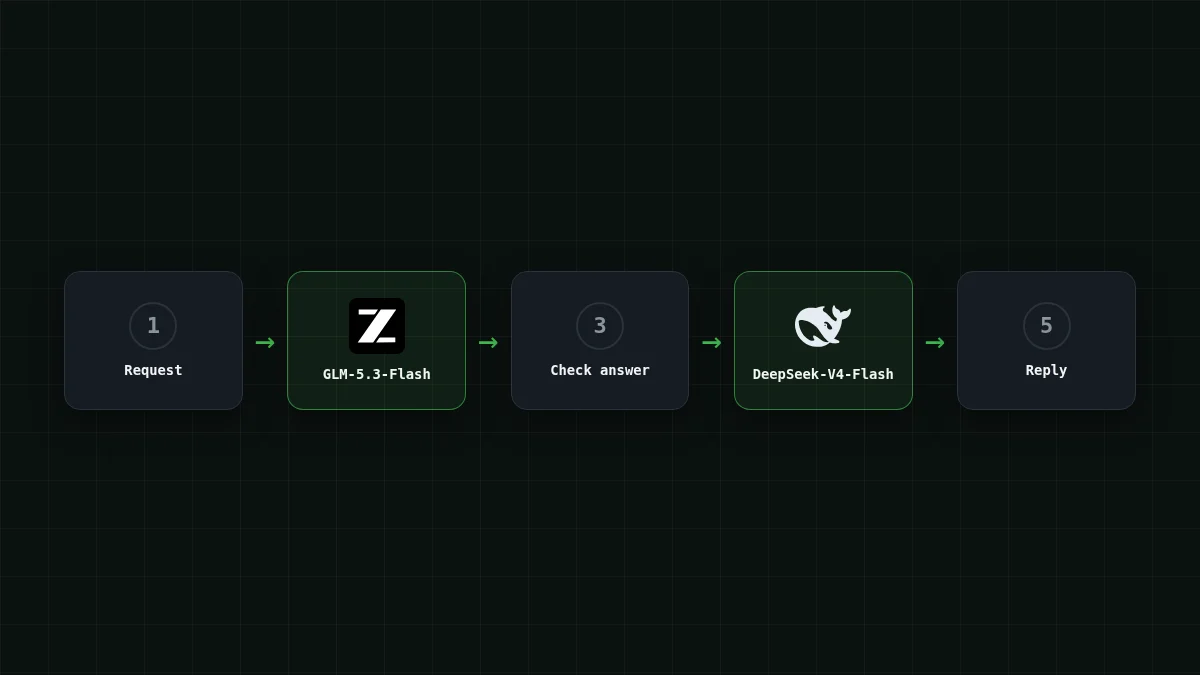
Tatlong ugali ang gumagawa nitong tapat sa halip na mura lang:
- Bilangin ang mga escalation. I-log kung gaano kadalas pumutok ang
needs_escalation. Iyon ang iyong p, at iyon ang numerong nagpapasya kung sulit ang cascade. - Piliin ang pangalawang modelo batay sa sarili mong test set. Kumuha ng 50 mahirap na request mula sa iyong logs, patakbuhin ang mga ito sa parehong modelo at panatilihin ang pangalawang modelo lamang kung naaayos nito ang mga napalampas ng una. Ang dokumentadong edge nito ay ang 32,768-token na limitasyon sa sagot, at ipinapakita ng sarili mong set kung iyon ang edge na kailangan mo.
- Ipadala ang parehong request, hindi mas mahaba. Kung i-paste mo ang nabigong sagot sa pangalawang call, binabayaran mo ito bilang input. Simulan ang pangalawang pass nang malinis maliban kung tunay na kapaki-pakinabang na konteksto ang unang sagot.
Suriin ang sarili mo#
Mabilisang pagsusuri
Sa isang cascade, 30% ng mga request ay nabibigo sa check sa unang modelo. Magkano ang mga request na iyon?
Ipakita ang sagot
Sagot: Presyo ng unang modelo kasama ang presyo ng pangalawang modelo
Na-bill na ang unang call noong itinatapon mo ang sagot nito. Dalawang beses nagbabayad ang mga na-escalate na request, kaya ang bahagi p ang nagpapasya sa lahat.
Saan pupunta susunod#
Kung hindi ka sigurado kung aling modelo ang dapat kumuha ng unang pass, inihahambing ng MiniMax-M2.7 vs DeepSeek-V4-Flash ang mga ito ayon sa gawain. Para sa per-task na pananaw sa halip na per-token, tingnan ang presyo kada 1M token vs gastos kada gawain, at para sa mga loop na may maraming hakbang, paano tantiyahin ang gastos ng isang AI agent. Ang live na presyo para sa bawat modelo ay nasa pricing page, at ang mga pahina ng modelo ay DeepSeek at GLM.


