Maliyet optimizasyonuKılavuz
API maliyetini düşürmek için model yönlendirme: önce ucuz model, yükselt
Kolay istekleri ucuz bir modele gönderin ve yalnızca zor olanları yükseltin. %10, %30 ve %50 yükseltmede 10.000 isteğin harmanlanmış maliyetini ve kısa bir Python yönlendiricisini görün.
Bu sayfada
Yönlendirme, ucuz modelin ilk geçişi ikinci modelden çok daha ucuz olduğunda ve az sayıda istek yükseltildiğinde faturayı düşürebilir: her isteği önce ucuz modele gönderin ve yalnızca zor olanları ikinci bir modele yeniden gönderin. Gerçekten tasarruf edip etmeyeceğiniz, yükselttiğiniz isteklerin payına bağlıdır. Aşağıda 10.000 istek için %10, %30 ve %50 oranlarında hesaplama ve projenize yapıştırabileceğiniz bir Python fonksiyonu var.
Bu desen yeni değil. Anthropic'in mühendislik yazısı "Etkili ajanlar oluşturmak" (19 Aralık 2024) buna yönlendirme iş akışı diyor: yaygın, kolay sorular daha küçük, maliyet açısından verimli bir modele gider ve sıra dışı, zor olanlar daha yetenekli bir modele gider. Yazı fiyat vermiyor, bu yüzden buradaki sayılar bizim kendi sayılarımız, canlı CheapTokens fiyatları üzerinden.
İsteklerinizden hangileri kolay?#
Yönlendirme yalnızca "zor"un ne anlama geldiğini bir kuralda söyleyebiliyorsanız işe yarar. Bir hisle değil, kodun kontrol edebileceği bir kuralla. Size en yakın durumu seçin:
Durumunu seç
Durumunuzu seçin
Cevabı görmek için bir seçenek seçin
Destek sohbet botu
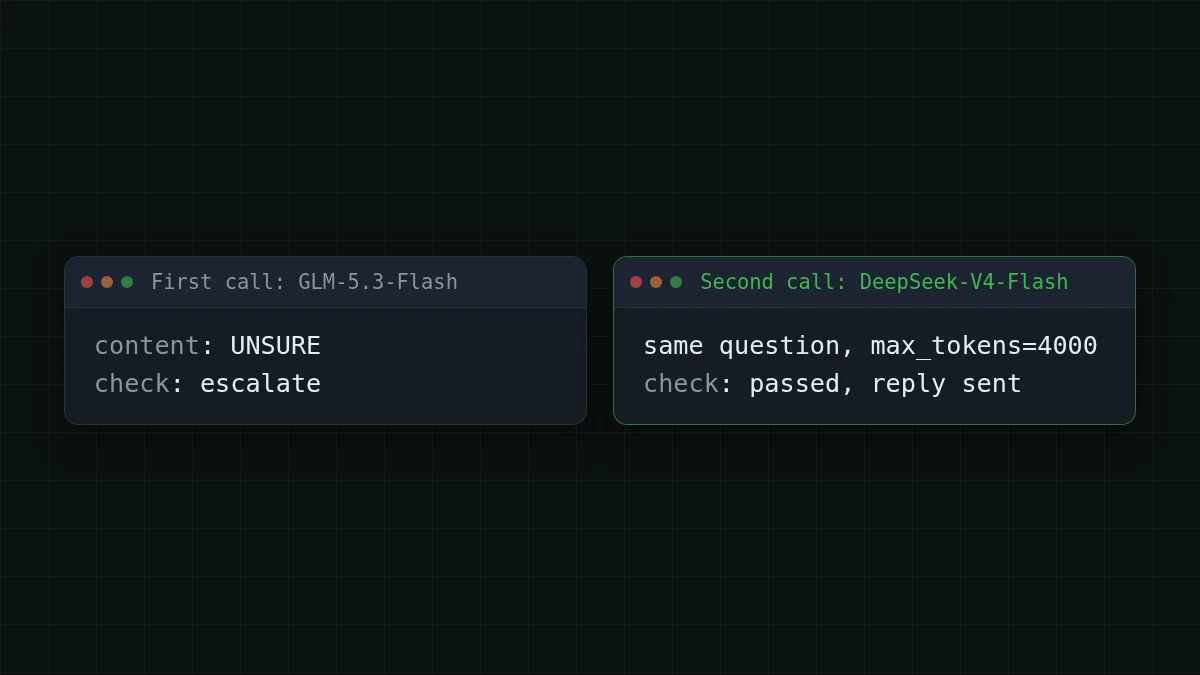
Çoğu bilet kısa SSS'lerdir: siparişim nerede, parolamı nasıl sıfırlarım. Birkaçı uzun, dikkatli bir yanıt gerektirir. Kolay: ilk model yanıtlar ve UNSURE demez. Zor: UNSURE der veya yanıt kesilir (finish_reason, length).
Belge işlem hattı
Her belge önce çıkarımdan geçer. Kolay: sonuç, tüm gerekli alanlarla geçerli JSON olarak ayrıştırılır. Zor: ayrıştırma başarısız olur veya bir alan boştur. Yalnızca bu belgeler ikinci modelde yeniden çalıştırılır.
Kodlama ajanı
Basit düzenlemeler ucuz modele gider. Aynı adım art arda iki kez başarısız olduğunda veya yanıt kesildiğinde (finish_reason, length) bir adımı yükseltin.
Modele nasıl söyleyeceğini söylemediyseniz "model emin görünmüyor" diye yükseltme yapmayın. Tek satırlık bir talimat ("yanıtlayamıyorsan tam olarak UNSURE yanıtla") bir hissi if'in okuyabileceği bir şeye dönüştürür.
10.000 isteğin maliyeti: kademeli vs yönlendirici#
Ayda 10.000 istek çalıştıran bir destek botunuz olduğunu varsayalım. Ortalama bir istek 800 giriş ve 300 çıkış token'ıdır. Bunlar varsayımlardır; kendi değerlerinizi usage'den alın (token sayımı makalemiz nereden okunacağını gösterir).
Yönlendirmeyi bağlamanın iki yolu vardır ve faturaları farklıdır:
- Kademeli. Her istek ucuz modele gider. p payı kontrolü geçemez ve ikinci modele yeniden gönderilir. Bu istekler iki kez ödenir: maliyet = N × [ucuz + p × ikinci].
- Yönlendirici. Küçük bir sınıflandırıcı çağrısı önceden karar verir. Kolay olanlar ucuz modele, zor olanlar doğrudan ikinciye gider: maliyet = N × [(1 − p) × ucuz + p × ikinci], artı her istekte sınıflandırıcı.
Kademeliyi kullanacağız, çünkü sınıflandırıcı gerektirmez ve başlaması daha kolaydır. İlk geçiş GLM-5.3-Flash'tir (zai-, 390K bağlam, 8.192'ye kadar çıkış token'ı). İkinci geçiş DeepSeek-V4-Flash sürüm 0731'dir (deepseek-, 380K bağlam, 32.768'e kadar çıkış token'ı), böylece 8.192 token'a sığmayan bir yanıtın tamamlanma alanı olur. Her ikisi de giriş ve çıkış birlikte sayıldığında toplamda OpenRouter'dan daha ucuzdur; aşağıdaki canlı tablo OpenRouter sütununu bizimkinin yanında gösterir.
İlk geçiş her zaman 10.000 isteğin tamamını kapsar: 8.000.000 giriş ve 3.000.000 çıkış token'ı. İkinci geçiş yalnızca yükseltilen payı kapsar. Son sütun alternatiftir: 10.000 isteğin tamamı doğrudan ikinci modelde.
Tabloyu sağa kaydırın →
| Yükseltilen pay | İkinci geçiş token'ları (giriş / çıkış) | İlk geçiş, 10.000'in tamamı | İkinci geçiş, yalnızca yükseltilenler | İkinci modelde her şey, 10.000'in tamamı |
|---|---|---|---|---|
| %10 | 800.000 / 300.000 | $0.28 | $0.042 | $0.42 |
| %30 | 2.400.000 / 900.000 | $0.28 | $0.126 | $0.42 |
| %50 | 4.000.000 / 1.500.000 | $0.28 | $0.21 | $0.42 |
Her satırdaki birinci geçiş ve ikinci geçiş sütunlarını toplayarak kademelinin aylık maliyetini elde edin, sonra bu toplamı son sütunla karşılaştırın. İlk geçiş sabit bir maliyettir ve yalnızca ikinci geçiş p ile büyür. Kademelinin tüm hikâyesi budur: ne kadar çok yükseltirseniz, iş için iki kez ödemeye o kadar yaklaşırsınız.
Aynı yükün tüm modeller için tek seferde karşılaştırması, böylece tek model seçeneklerinin nereye düştüğünü görebilirsiniz:
| Model | Giriş $/1M | Çıkış $/1M | İstek başına | 10.000 istek | OpenRouter, 10.000 istek |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.28 | $0.517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.42 | $0.98 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.85 | $10.20 |
İstek başına 800 giriş ve 300 çıkış token'ı. 1M token başına fiyatlar günceldir ve tarifelerimizle birlikte değişir; OpenRouter sütunu aynı iş yükü için referans fiyatları gösterir.
Kademeli ne zaman değmez? İlk geçiş artı yükseltilen pay, her şeyi ikinci modele göndermekten daha pahalı olduğunda. Sembollerle: ucuz + p × ikinci < ikinci, yani p < 1 − ucuz/ikinci. Bu çift için, ilk geçiş bu yükte ikinci modelin fiyatının kayda değer bir payına mal olur, bu yüzden kademeliden elde edilen kazanç küçülür ve yüksek yükseltme payında kaybolur. %50'de kademeli, 10.000 isteğin tamamını ikinci modele göndermeye karşı kaybedebilir, bu yüzden taahhütte bulunmadan önce iki geçişin toplamını son sütunla karşılaştırın. Oran, giriş/çıkış karışımınıza bağlıdır, çünkü iki model iki tarafı farklı fiyatlandırır, bu yüzden kendi satırınızdan okuyun.
Yönlendirici varyantı bir şey ekler: sınıflandırıcı. İstek başına ucuz modelde 300 giriş token'ı okuyup 5 token'da yanıt verdiğini varsayalım. 10.000 istek için bu 3.000.000 giriş ve 50.000 çıkış token'ı, yani ayda ek $0.062. Bu satırı birinci geçiş sütununun p payıyla (%10, %30 veya %50'si) karşılaştırın: kademelinin, ardından yükseltilen isteklerde ilk geçişi çalıştırarak boşa harcadığı şey budur. Sınıflandırıcı satırı daha büyükse, kademeli daha ucuz başlangıçtır; daha küçükse, bir yönlendirici daha fazla tasarruf sağlar.
Bir şey inşa etmeden önce kendi sayılarınızı deneyin:
Maliyet hesaplayıcı
Bir destek botunun bir ayı, her şey tek modelde
İstek başına giriş token'ı: 800 · İstek başına çıkış token'ı: 300 · Günlük istek sayısı: 10.000
| Model | Günlük | Aylık |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.28 | $8.40 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.42 | $12.60 |
| MiniMax-M2.7$0.05$0.15 | $0.85 | $25.50 |
runs'u hacminize göre değiştirin ve her model için toplamı okuyun. Ardından yukarıdaki tabloyu kullanarak ikinci bir geçişin ne kadar ekleyeceğini görün.
Python'da bir yönlendirici: iki çağrı ve bir kontrol#
Her iki model de tek bir OpenAI uyumlu temel URL ve tek bir bakiye arkasında durur, bu yüzden yönlendirme ikinci bir hesap veya anahtar gerektirmez. Aşağıdaki kod bir örnektir: içindeki sayılar (max_tokens, UNSURE kuralı) sizin ayarlamanız içindir. İkinci çağrı daha yüksek bir max_tokens alır, böylece 600 token'da kesilen bir yanıt tamamlanabilir. Temel URL, model kimlikleri ve geri kalanı CheapTokens belgelerinde.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CHEAP = 'zai-org/GLM-5.3-Flash'
SECOND = 'deepseek-ai/DeepSeek-V4-Flash-0731'
SYSTEM = 'Answer briefly. If you cannot answer well, reply exactly UNSURE.'


def ask(model, question, max_tokens):
    r = client.chat.completions.create(
        model=model,
        max_tokens=max_tokens,
        messages=[
            {'role': 'system', 'content': SYSTEM},
            {'role': 'user', 'content': question},
        ],
    )
    choice = r.choices[0]
    return choice.message.content or '', choice.finish_reason


def needs_escalation(text, finish_reason):
    return finish_reason == 'length' or not text.strip() or 'UNSURE' in text


def answer(question):
    text, why = ask(CHEAP, question, 600)
    if needs_escalation(text, why):
        text, why = ask(SECOND, question, 4000)
        if 'UNSURE' in text:
            text = 'Sorry, I could not answer this one.'
    return text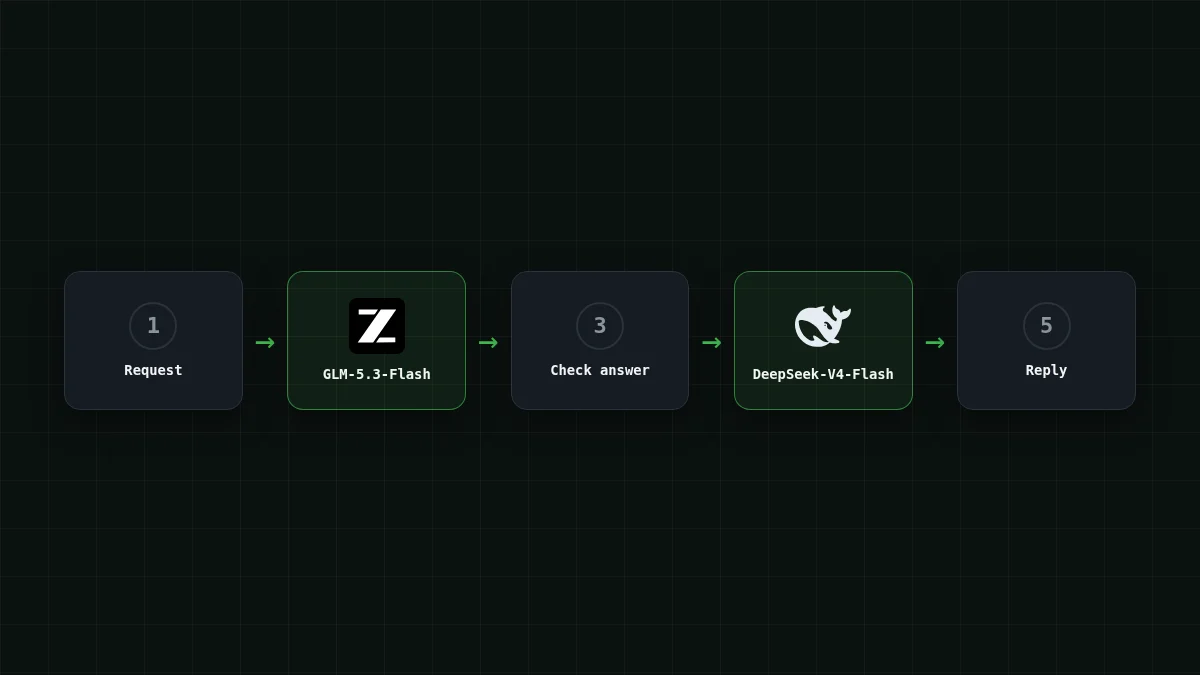
Bunu sadece ucuz değil dürüst kılan üç alışkanlık:
- Yükseltmeleri sayın.
needs_escalation'in kaç kez tetiklendiğini günlüğe kaydedin. Bu sizin p'nizdir ve kademelinin ödeyip ödemeyeceğine karar veren sayıdır. - İkinci modeli kendi test setinizde seçin. Günlüklerinizden 50 zor istek alın, her iki modelden geçirin ve ikinci modeli yalnızca birincinin kaçırdıklarını düzeltiyorsa tutun. Belgelenmiş avantajı 32.768 token'lık yanıt sınırıdır ve kendi setiniz ihtiyacınız olan avantajın bu olup olmadığını gösterir.
- Aynı isteği gönderin, daha uzununu değil. Başarısız yanıtı ikinci çağrıya yapıştırırsanız, bunun için giriş olarak ödersiniz. İlk yanıt gerçekten yararlı bağlam değilse ikinci geçişe temiz başlayın.
Kendinizi test edin#
Hızlı kontrol
Kademeli bir yapıda isteklerin %30'u ilk modeldeki kontrolü geçemez. Bu istekler ne kadara mal olur?
Cevabı göster
Cevap: İlk modelin fiyatı artı ikinci modelin fiyatı
Yanıtını attığınızda ilk çağrı zaten faturalandırılmıştır. Yükseltilen istekler iki kez öder, bu yüzden p payı her şeye karar verir.
Sırada ne var#
İlk geçişi hangi modelin alması gerektiğinden emin değilseniz, MiniMax-M2.7 vs DeepSeek-V4-Flash bunları göreve göre karşılaştırır. Token başına değil görev başına bir görünüm için 1M token başına fiyat vs görev başına maliyet ve çok adımlı döngüler için bir AI ajanının maliyeti nasıl tahmin edilir yazılarına bakın. Her model için canlı fiyatlar fiyatlandırma sayfasında ve model sayfaları DeepSeek ve GLM.


