Enrutamiento de modelos para recortar el coste de API: modelo barato primero, escalar
Envía las solicitudes fáciles a un modelo barato y escala solo las difíciles. Mira el coste combinado de 10.000 solicitudes con 10%, 30% y 50% de escalado, más un breve enrutador en Python.
En esta página
El enrutamiento puede recortar la factura cuando la primera pasada del modelo barato es mucho más económica que el segundo modelo y pocas solicitudes escalan: envía cada solicitud primero al modelo barato y reenvía solo las difíciles a un segundo modelo. Que ahorres de verdad depende de la proporción de solicitudes que escales. Abajo está la aritmética para 10.000 solicitudes al 10%, 30% y 50%, y una función de Python que puedes pegar en tu proyecto.
El patrón no es nuevo. El post de ingeniería de Anthropic "Building effective agents" (19 de diciembre de 2024) lo llama flujo de trabajo de enrutamiento: las preguntas comunes y fáciles van a un modelo más pequeño y rentable, y las inusuales y difíciles van a uno más capaz. El post no da precios, así que los números aquí son nuestros, sobre precios en vivo de CheapTokens.
¿Cuáles de tus solicitudes son fáciles?#
El enrutamiento solo funciona si puedes decir, en una regla, qué significa "difícil". No en una sensación, en una regla que el código pueda comprobar. Elige el caso más cercano al tuyo:
Elige tu caso
Elige tu caso
Elige una opción para ver la respuesta
Chatbot de soporte
La mayoría de los tickets son preguntas frecuentes cortas: dónde está mi pedido, cómo restablezco una contraseña. Unos pocos necesitan una respuesta larga y cuidadosa. Fácil: el primer modelo responde y no contesta UNSURE. Difícil: dice UNSURE, o la respuesta se corta (finish_reason es length).
Pipeline de documentos
Cada documento pasa primero por extracción. Fácil: el resultado se parsea como JSON válido con todos los campos requeridos. Difícil: el parseo falla o un campo está vacío. Solo esos documentos se vuelven a ejecutar en el segundo modelo.
Agente de programación
Las ediciones simples van al modelo barato. Escala un paso cuando el mismo paso falló dos veces seguidas, o cuando la respuesta se cortó (finish_reason es length).
No escales por "el modelo suena inseguro" a menos que le hayas dicho cómo decirlo. Una instrucción de una línea ("responde exactamente UNSURE si no puedes contestar") convierte una intuición en algo que if puede leer.
Cuánto cuestan 10.000 solicitudes: cascada vs enrutador#
Digamos que ejecutas un bot de soporte con 10.000 solicitudes al mes. Una solicitud promedio es de 800 tokens de entrada y 300 tokens de salida. Estas son suposiciones; sustituye las tuyas desde usage (nuestro artículo sobre conteo de tokens muestra dónde leerlos).
Hay dos formas de cablear el enrutamiento, y facturan de manera distinta:
- Cascada. Cada solicitud va al modelo barato. Una proporción p falla la comprobación y se reenvía al segundo modelo. Esas solicitudes se pagan dos veces: coste = N × [barato + p × segundo].
- Enrutador. Una pequeña llamada de clasificador decide de antemano. Las fáciles van al modelo barato, las difíciles directamente al segundo: coste = N × [(1 − p) × barato + p × segundo], más el clasificador en cada solicitud.
Usaremos la cascada, porque no necesita clasificador y es la más fácil para empezar. La primera pasada es GLM-5.3-Flash (zai-, contexto de 390K, hasta 8.192 tokens de salida). La segunda pasada es DeepSeek-V4-Flash release 0731 (deepseek-, contexto de 380K, hasta 32.768 tokens de salida), así que una respuesta que no cabía en 8.192 tokens tiene espacio para terminar. Ambos son más baratos que OpenRouter en total, contando entrada y salida juntas; la tabla en vivo de abajo muestra la columna de OpenRouter junto a la nuestra.
La primera pasada siempre cubre las 10.000 solicitudes: 8.000.000 de entrada y 3.000.000 de salida en tokens. La segunda pasada cubre solo la proporción escalada. La última columna es la alternativa: las 10.000 solicitudes directamente en el segundo modelo.
Desplaza la tabla hacia la derecha →
| Proporción escalada | Tokens de segunda pasada (entrada / salida) | Primera pasada, las 10.000 | Segunda pasada, solo las escaladas | Todo en el segundo modelo, las 10.000 |
|---|---|---|---|---|
| 10% | 800.000 / 300.000 | $0.28 | $0.042 | $0.42 |
| 30% | 2.400.000 / 900.000 | $0.28 | $0.126 | $0.42 |
| 50% | 4.000.000 / 1.500.000 | $0.28 | $0.21 | $0.42 |
Suma las columnas de primera y segunda pasada en cada fila para obtener el mes de la cascada, luego compara esa suma con la última columna. La primera pasada es un coste fijo, y solo la segunda pasada crece con p. Esa es toda la historia de una cascada: cuanto más escalas, más cerca estás de pagar el trabajo dos veces.
Aquí está la misma carga para todos los modelos a la vez, para que veas dónde caen las opciones de un solo modelo:
| Modelo | Entrada $/1M | Salida $/1M | Por solicitud | 10.000 solicitudes | OpenRouter, 10.000 solicitudes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.28 | $0.517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.42 | $0.98 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.85 | $10.20 |
800 tokens de entrada y 300 tokens de salida por solicitud. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
¿Cuándo no vale la pena una cascada? Cuando la primera pasada más la proporción escalada cuesta más que enviar todo al segundo modelo. En símbolos: barato + p × segundo < segundo, lo que significa p < 1 − barato/segundo. Para este par, la primera pasada cuesta una proporción notable del precio del segundo modelo con esta carga, así que la ganancia de una cascada se encoge, y con una proporción de escalado alta desaparece. Al 50% la cascada puede perder frente a simplemente enviar las 10.000 solicitudes al segundo modelo, así que comprueba la suma de las dos pasadas contra la última columna antes de comprometerte. La ratio depende de tu mezcla de entrada/salida, porque los dos modelos ponen precios distintos a cada lado, así que léela de tu propia fila.
La variante de enrutador añade una cosa: el clasificador. Supón que lee 300 tokens de entrada y responde en 5 tokens en el modelo barato, por solicitud. Para 10.000 solicitudes eso son 3.000.000 de entrada y 50.000 de salida en tokens, o $0.062 al mes adicionales. Compara esta línea con la proporción p de la columna de primera pasada (10%, 30% o 50% de ella): eso es lo que la cascada desperdicia al ejecutar la primera pasada en solicitudes que luego escalan. Si la línea del clasificador es mayor, la cascada es el inicio más barato; si es menor, un enrutador ahorra más.
Prueba tus propios números antes de construir nada:
Calculadora de costos
Un mes de un bot de soporte, todo en un solo modelo
Tokens de entrada por solicitud: 800 · Tokens de salida por solicitud: 300 · Solicitudes por día: 10.000
| Modelo | Por día | Por mes |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.28 | $8.40 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.42 | $12.60 |
| MiniMax-M2.7$0.05$0.15 | $0.85 | $25.50 |
Cambia runs por tu volumen y lee el total de cada modelo. Luego usa la tabla de arriba para ver cuánto añadiría una segunda pasada.
Un enrutador en Python: dos llamadas y una comprobación#
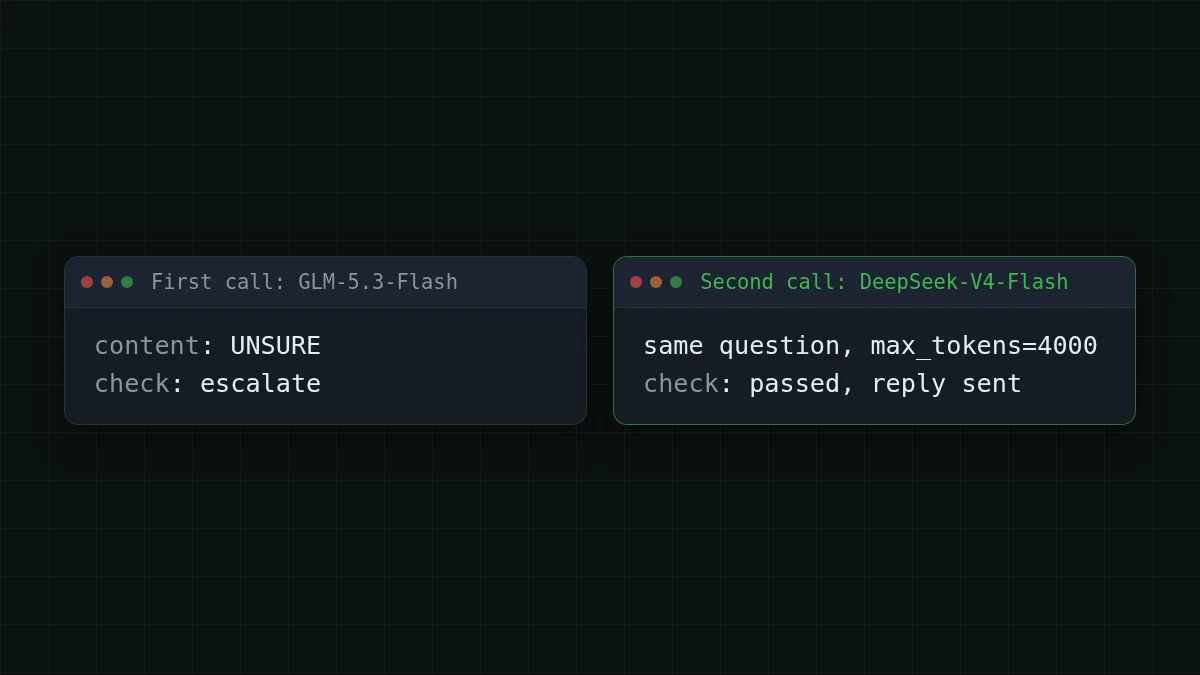
Ambos modelos están detrás de una única URL base compatible con OpenAI y un único saldo, así que el enrutamiento no necesita una segunda cuenta ni clave. El código de abajo es un ejemplo: los números en él (max_tokens, la regla UNSURE) son tuyos para ajustar. La segunda llamada recibe un max_tokens más alto, así que una respuesta cortada a 600 tokens puede terminar. La URL base, los ids de modelo y el resto están en la documentación de CheapTokens.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CHEAP = 'zai-org/GLM-5.3-Flash'
SECOND = 'deepseek-ai/DeepSeek-V4-Flash-0731'
SYSTEM = 'Answer briefly. If you cannot answer well, reply exactly UNSURE.'


def ask(model, question, max_tokens):
    r = client.chat.completions.create(
        model=model,
        max_tokens=max_tokens,
        messages=[
            {'role': 'system', 'content': SYSTEM},
            {'role': 'user', 'content': question},
        ],
    )
    choice = r.choices[0]
    return choice.message.content or '', choice.finish_reason


def needs_escalation(text, finish_reason):
    return finish_reason == 'length' or not text.strip() or 'UNSURE' in text


def answer(question):
    text, why = ask(CHEAP, question, 600)
    if needs_escalation(text, why):
        text, why = ask(SECOND, question, 4000)
        if 'UNSURE' in text:
            text = 'Sorry, I could not answer this one.'
    return text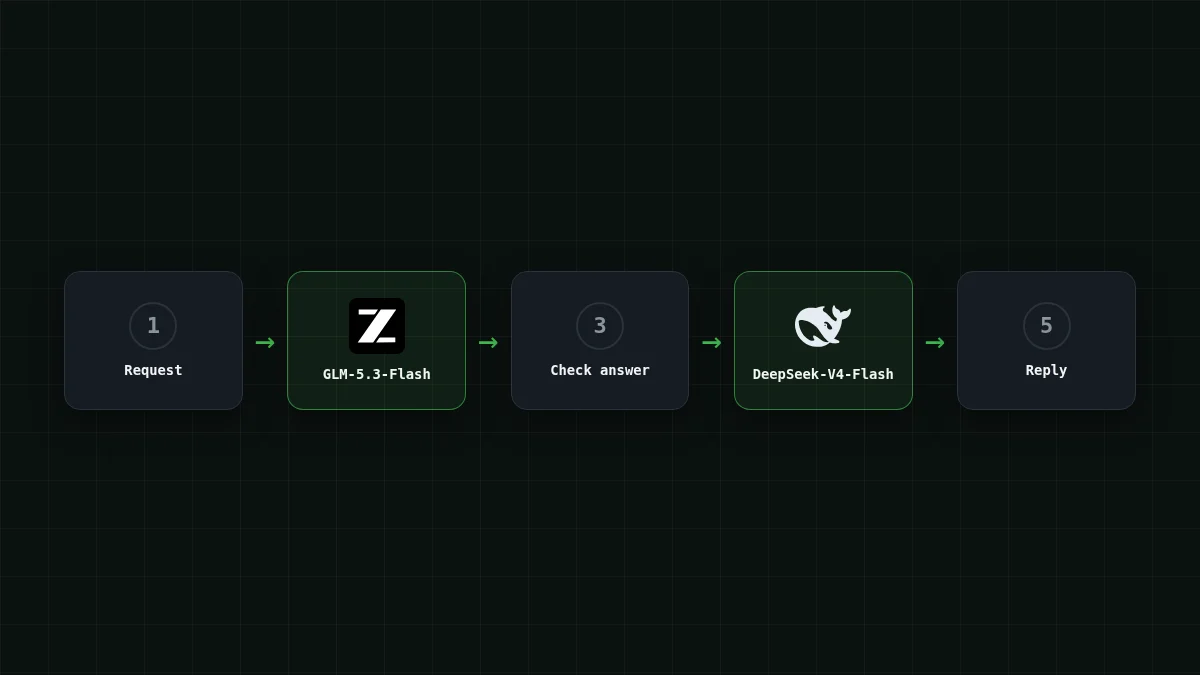
Tres hábitos hacen esto honesto en lugar de solo barato:
- Cuenta las escaladas. Registra con qué frecuencia se dispara
needs_escalation. Esa es tu p, y es el número que decide si la cascada compensa. - Elige el segundo modelo con tu propio conjunto de pruebas. Toma 50 solicitudes difíciles de tus registros, ejecútalas por ambos modelos y quédate con el segundo solo si corrige las que el primero falló. Su ventaja documentada es el límite de respuesta de 32.768 tokens, y tu propio conjunto muestra si esa es la ventaja que necesitas.
- Envía la misma solicitud, no una más larga. Si pegas la respuesta fallida en la segunda llamada, la pagas como entrada. Empieza la segunda pasada limpia a menos que la primera respuesta sea contexto genuinamente útil.
Compruébalo tú mismo#
Verificación rápida
En una cascada, el 30% de las solicitudes fallan la comprobación en el primer modelo. ¿Cuánto cuestan esas solicitudes?
Mostrar respuesta
Respuesta: El precio del primer modelo más el precio del segundo modelo
La primera llamada ya está facturada cuando tiras su respuesta. Las solicitudes escaladas pagan dos veces, por eso la proporción p lo decide todo.
A dónde ir después#
Si no estás seguro de qué modelo debería tomar la primera pasada, MiniMax-M2.7 vs DeepSeek-V4-Flash los compara por tarea. Para una vista por tarea en lugar de por token, consulta precio por 1M de tokens vs coste por tarea, y para bucles con muchos pasos, cómo estimar el coste de un agente de IA. Los precios en vivo de cada modelo están en la página de precios, y las páginas de los modelos son DeepSeek y GLM.


