Routing dei modelli per ridurre il costo API: prima il modello economico, poi escalation
Invia le richieste facili a un modello economico ed escala solo quelle difficili. Scopri il costo misto di 10.000 richieste al 10%, 30% e 50% di escalation, più un breve router Python.
In questa pagina
Il routing può ridurre la bolletta quando il primo passaggio del modello economico costa molto meno del secondo modello e poche richieste vengono escalate: invia ogni richiesta prima al modello economico e reinvia solo quelle difficili a un secondo modello. Se risparmi davvero dipende dalla percentuale di richieste che escalation. Di seguito l'aritmetica per 10.000 richieste al 10%, 30% e 50%, e una funzione Python che puoi incollare nel tuo progetto.
Il pattern non è nuovo. Il post di ingegneria di Anthropic "Building effective agents" (19 dicembre 2024) lo chiama workflow di routing: le domande comuni e facili vanno a un modello più piccolo ed economico, quelle insolite e difficili a uno più capace. Il post non riporta prezzi, quindi i numeri qui sono nostri, sui prezzi live di CheapTokens.
Quali delle tue richieste sono facili?#
Il routing funziona solo se sai dire, in una regola, cosa significa "difficile". Non a sensazione, ma in una regola che il codice può verificare. Scegli il caso più vicino al tuo:
Scegli il tuo caso
Scegli il tuo caso
Scegli un'opzione per vedere la risposta
Chatbot di supporto
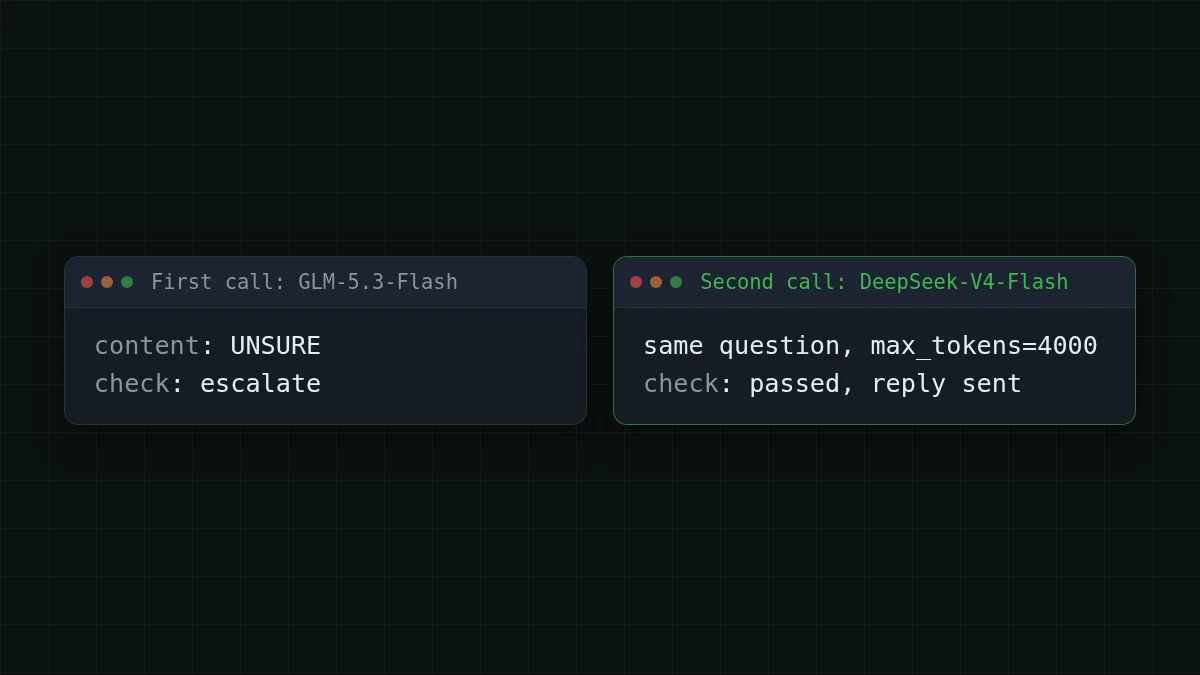
La maggior parte dei ticket sono FAQ brevi: dov'è il mio ordine, come reimposto una password. Alcuni richiedono una risposta lunga e accurata. Facile: il primo modello risponde e non replica UNSURE. Difficile: dice UNSURE, o la risposta è troncata (finish_reason è length).
Pipeline di documenti
Ogni documento passa prima per l'estrazione. Facile: il risultato si analizza come JSON valido con tutti i campi richiesti. Difficile: l'analisi fallisce o un campo è vuoto. Solo quei documenti vengono rieseguiti sul secondo modello.
Agente di coding
Le modifiche semplici vanno al modello economico. Escala un passo quando lo stesso passo è fallito due volte di fila, o quando la risposta è stata troncata (finish_reason è length).
Non escalare su "il modello sembra incerto" a meno che tu non gli abbia detto come dirlo. Un'istruzione di una riga ("rispondi esattamente UNSURE se non puoi rispondere") trasforma una sensazione in qualcosa che if può leggere.
Quanto costano 10.000 richieste: cascata vs router#
Supponiamo che tu gestisca un bot di supporto con 10.000 richieste al mese. Una richiesta media è di 800 token in input e 300 token in output. Queste sono ipotesi; sostituiscile con le tue da usage (il nostro articolo sul conteggio dei token mostra dove leggerle).
Ci sono due modi per cablare il routing, e fatturano diversamente:
- Cascata. Ogni richiesta va al modello economico. Una quota p fallisce il controllo e viene inviata di nuovo al secondo modello. Quelle richieste vengono pagate due volte: costo = N × [economico + p × secondo].
- Router. Una piccola chiamata di classificazione decide in anticipo. Le facili vanno al modello economico, le difficili direttamente al secondo: costo = N × [(1 − p) × economico + p × secondo], più il classificatore su ogni richiesta.
Useremo la cascata, perché non richiede un classificatore ed è la più facile da iniziare. Il primo passaggio è GLM-5.3-Flash (zai-, contesto 390K, fino a 8.192 token di output). Il secondo passaggio è DeepSeek-V4-Flash release 0731 (deepseek-, contesto 380K, fino a 32.768 token di output), così una risposta che non stava in 8.192 token ha spazio per finire. Entrambi costano meno di OpenRouter in totale, con input e output contati insieme; la tabella live qui sotto mostra la colonna OpenRouter accanto alla nostra.
Il primo passaggio copre sempre tutte le 10.000 richieste: 8.000.000 di input e 3.000.000 di output. Il secondo passaggio copre solo la quota escalata. L'ultima colonna è l'alternativa: tutte le 10.000 richieste direttamente sul secondo modello.
Scorri la tabella verso destra →
| Quota escalata | Token del secondo passaggio (in / out) | Primo passaggio, tutte le 10.000 | Secondo passaggio, solo escalate | Tutto sul secondo modello, tutte le 10.000 |
|---|---|---|---|---|
| 10% | 800.000 / 300.000 | $0.28 | $0.042 | $0.42 |
| 30% | 2.400.000 / 900.000 | $0.28 | $0.126 | $0.42 |
| 50% | 4.000.000 / 1.500.000 | $0.28 | $0.21 | $0.42 |
Somma le colonne del primo e del secondo passaggio in ogni riga per ottenere il mese della cascata, poi confronta quella somma con l'ultima colonna. Il primo passaggio è un costo fisso, e solo il secondo passaggio cresce con p. È tutta qui la storia di una cascata: più escalation, più ti avvicini a pagare il lavoro due volte.
Ecco lo stesso carico per ogni modello contemporaneamente, così puoi vedere dove si collocano le opzioni a modello singolo:
| Modello | Input $/1M | Output $/1M | Per richiesta | 10.000 richieste | OpenRouter, 10.000 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.28 | $0.517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.42 | $0.98 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.85 | $10.20 |
800 token di input e 300 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
Quando una cascata non conviene? Quando il primo passaggio più la quota escalata costa più che inviare tutto al secondo modello. In simboli: economico + p × secondo < secondo, il che significa p < 1 − economico/secondo. Per questa coppia, il primo passaggio costa una quota notevole del prezzo del secondo modello su questo carico, quindi il guadagno di una cascata si riduce, e con un'alta quota di escalation scompare. Al 50% la cascata può perdere contro l'invio di tutte le 10.000 richieste al secondo modello, quindi controlla la somma dei due passaggi rispetto all'ultima colonna prima di impegnarti. Il rapporto dipende dal tuo mix di input/output, perché i due modelli prezzano i due lati diversamente, quindi leggilo dalla tua riga.
La variante router aggiunge una cosa: il classificatore. Supponiamo che legga 300 token di input e risponda in 5 token sul modello economico, per richiesta. Per 10.000 richieste sono 3.000.000 di input e 50.000 di output, ovvero $0.062 al mese in più. Confronta questa riga con la quota p della colonna del primo passaggio (10%, 30% o 50% di essa): è ciò che la cascata spreca eseguendo il primo passaggio su richieste che poi escalano. Se la riga del classificatore è maggiore, la cascata è l'inizio più economico; se è minore, un router risparmia di più.
Prova i tuoi numeri prima di costruire qualsiasi cosa:
Calcolatore di costi
Un mese di un bot di supporto, tutto su un modello
Token di input per richiesta: 800 · Token di output per richiesta: 300 · Richieste al giorno: 10.000
| Modello | Al giorno | Al mese |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.28 | $8.40 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.42 | $12.60 |
| MiniMax-M2.7$0.05$0.15 | $0.85 | $25.50 |
Cambia runs con il tuo volume e leggi il totale per ogni modello. Poi usa la tabella sopra per vedere quanto aggiungerebbe un secondo passaggio.
Un router in Python: due chiamate e un controllo#
Entrambi i modelli stanno dietro un unico base URL compatibile OpenAI e un unico saldo, quindi il routing non richiede un secondo account o chiave. Il codice sotto è un esempio: i numeri al suo interno (max_tokens, la regola UNSURE) sono da tarare. La seconda chiamata riceve un max_tokens più alto, così una risposta troncata a 600 token può finire. Base URL, id dei modelli e il resto sono nella documentazione di CheapTokens.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CHEAP = 'zai-org/GLM-5.3-Flash'
SECOND = 'deepseek-ai/DeepSeek-V4-Flash-0731'
SYSTEM = 'Answer briefly. If you cannot answer well, reply exactly UNSURE.'


def ask(model, question, max_tokens):
    r = client.chat.completions.create(
        model=model,
        max_tokens=max_tokens,
        messages=[
            {'role': 'system', 'content': SYSTEM},
            {'role': 'user', 'content': question},
        ],
    )
    choice = r.choices[0]
    return choice.message.content or '', choice.finish_reason


def needs_escalation(text, finish_reason):
    return finish_reason == 'length' or not text.strip() or 'UNSURE' in text


def answer(question):
    text, why = ask(CHEAP, question, 600)
    if needs_escalation(text, why):
        text, why = ask(SECOND, question, 4000)
        if 'UNSURE' in text:
            text = 'Sorry, I could not answer this one.'
    return text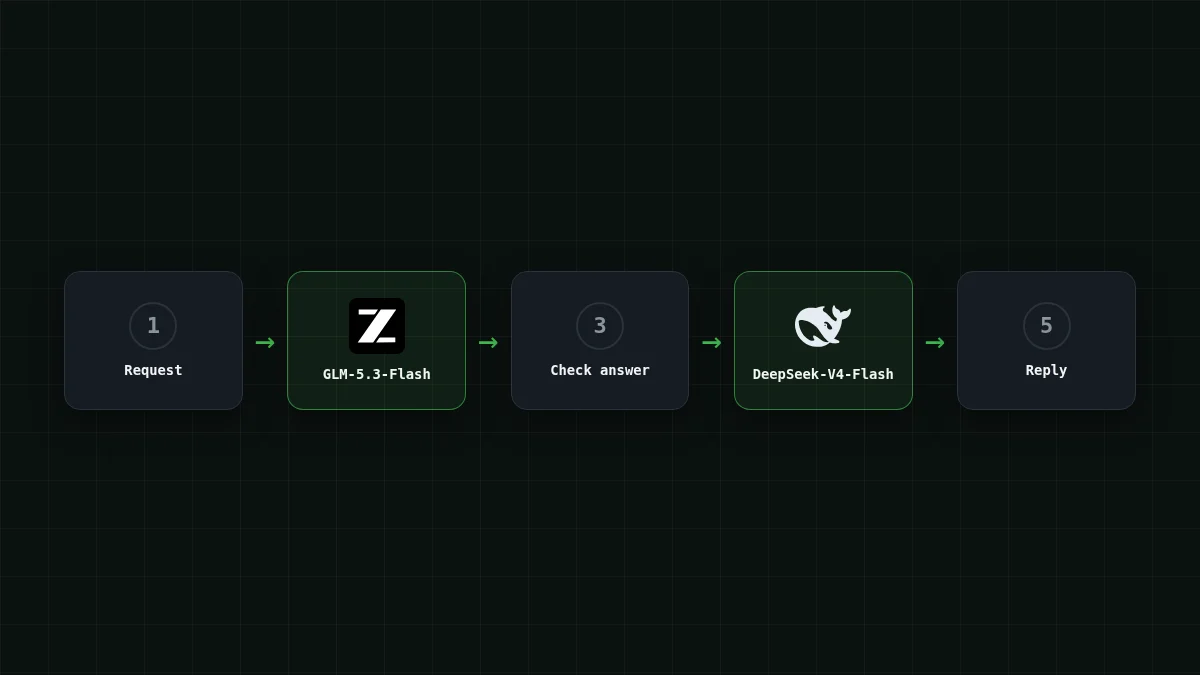
Tre abitudini rendono questo onesto e non solo economico:
- Conta le escalation. Registra quanto spesso scatta
needs_escalation. Quella è la tua p, ed è il numero che decide se la cascata conviene. - Scegli il secondo modello sul tuo set di test. Prendi 50 richieste difficili dai tuoi log, eseguile su entrambi i modelli e tieni il secondo solo se corregge quelle che il primo ha mancato. Il suo vantaggio documentato è il limite di risposta di 32.768 token, e il tuo set mostra se è il vantaggio che ti serve.
- Invia la stessa richiesta, non una più lunga. Se incolli la risposta fallita nella seconda chiamata, la paghi come input. Inizia il secondo passaggio pulito a meno che la prima risposta non sia un contesto davvero utile.
Verifica te stesso#
Verifica rapida
In una cascata, il 30% delle richieste fallisce il controllo sul primo modello. Quanto costano quelle richieste?
Mostra risposta
Risposta: Il prezzo del primo modello più il prezzo del secondo modello
La prima chiamata è già fatturata quando getti via la sua risposta. Le richieste escalate pagano due volte, ed è per questo che la quota p decide tutto.
Dove andare dopo#
Se non sei sicuro di quale modello debba fare il primo passaggio, MiniMax-M2.7 vs DeepSeek-V4-Flash li confronta per attività. Per una vista per attività invece che per token, vedi prezzo per 1M token vs costo per attività, e per loop con molti passaggi, come stimare il costo di un agente AI. I prezzi live per ogni modello sono sulla pagina dei prezzi, e le pagine dei modelli sono DeepSeek e GLM.


