Оптимізація витратПосібник
Маршрутизація моделей для зниження вартості API: спочатку дешева модель, ескалація
Надсилайте легкі запити до дешевої моделі й ескалюйте лише складні. Дивіться змішану вартість 10 000 запитів при 10%, 30% і 50% ескалації, а також короткий маршрутизатор на Python.
На цій сторінці
Маршрутизація може зменшити рахунок, коли перший прохід дешевої моделі значно дешевший за другу модель і мало запитів ескалюється: надсилайте кожен запит спочатку до дешевої моделі й повторно надсилайте лише складні до другої моделі. Чи справді ви заощадите, залежить від частки запитів, які ви ескалюєте. Нижче наведено арифметику для 10 000 запитів при 10%, 30% і 50%, а також функцію Python, яку можна вставити у свій проєкт.
Цей підхід не новий. Інженерний пост Anthropic "Building effective agents" (19 грудня 2024) називає його робочим процесом маршрутизації: звичайні, легкі питання йдуть до меншої, економічно ефективнішої моделі, а незвичайні, складні — до потужнішої. У пості не наведено цін, тому цифри тут наші власні, на живих цінах CheapTokens.
Які з ваших запитів легкі?#
Маршрутизація працює, лише якщо ви можете сказати правилом, що означає "складно". Не відчуттям, а правилом, яке код може перевірити. Виберіть випадок, найближчий до вашого:
Оберіть свій випадок
Виберіть свій випадок
Виберіть варіант, щоб побачити відповідь
Чат-бот підтримки
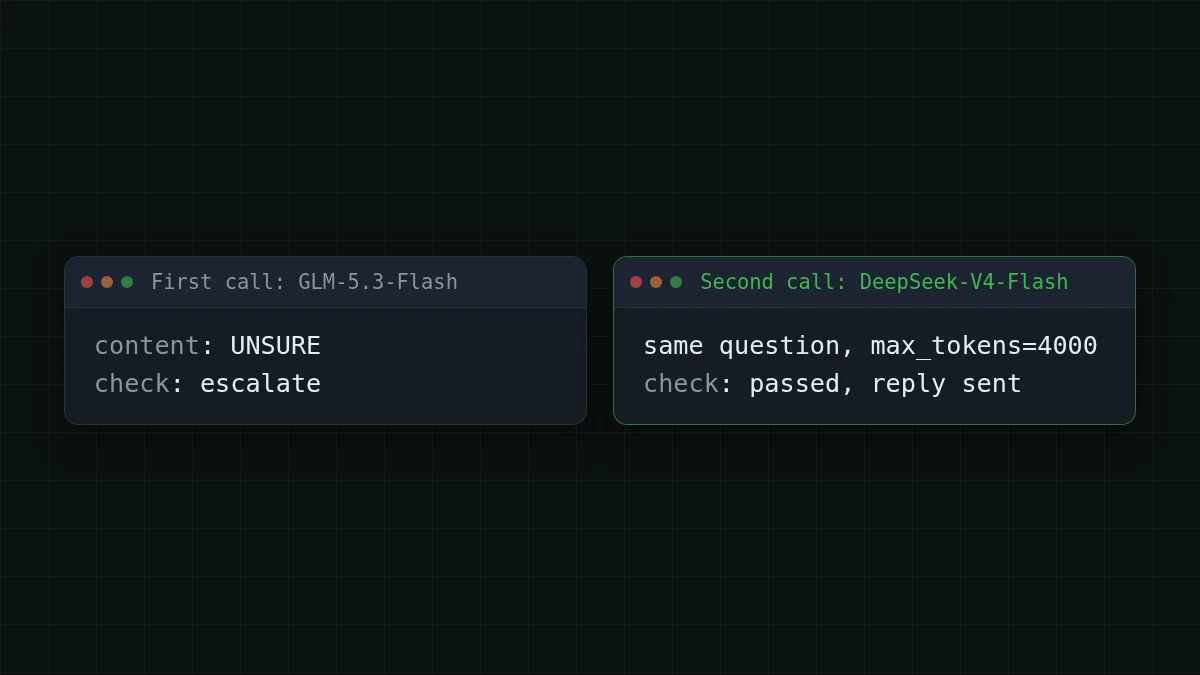
Більшість тікетів — короткі поширені запитання: де моє замовлення, як скинути пароль. Деякі потребують довгої, ретельної відповіді. Легко: перша модель відповідає й не повертає UNSURE. Складно: вона каже UNSURE, або відповідь обрізана (finish_reason дорівнює length).
Конвеєр документів
Кожен документ спочатку проходить вилучення. Легко: результат парситься як валідний JSON з усіма обов'язковими полями. Складно: парсинг не вдається або поле порожнє. Лише ці документи повторно обробляються другою моделлю.
Агент для кодування
Прості редагування йдуть до дешевої моделі. Ескалюйте крок, коли той самий крок не вдався двічі поспіль, або коли відповідь була обрізана (finish_reason дорівнює length).
Не ескалюйте на "модель звучить невпевнено", якщо ви не сказали їй, як це висловити. Однорядкова інструкція ("відповідай точно UNSURE, якщо не можеш відповісти") перетворює відчуття на щось, що if може прочитати.
Скільки коштують 10 000 запитів: каскад проти маршрутизатора#
Припустімо, ви запускаєте бота підтримки з 10 000 запитів на місяць. Середній запит — 800 токенів на вході та 300 токенів на виході. Це припущення; замініть їх своїми з usage (наша стаття про підрахунок токенів показує, де їх читати).
Є два способи налаштувати маршрутизацію, і вони тарифікуються по-різному:
- Каскад. Кожен запит іде до дешевої моделі. Частка p не проходить перевірку й надсилається знову до другої моделі. Ці запити оплачуються двічі: вартість = N × [дешева + p × друга].
- Маршрутизатор. Невеликий виклик класифікатора вирішує заздалегідь. Легкі йдуть до дешевої моделі, складні — одразу до другої: вартість = N × [(1 − p) × дешева + p × друга], плюс класифікатор на кожен запит.
Ми використаємо каскад, бо він не потребує класифікатора й з нього легше почати. Перший прохід — GLM-5.3-Flash (zai-, контекст 390K, до 8 192 вихідних токенів). Другий прохід — DeepSeek-V4-Flash release 0731 (deepseek-, контекст 380K, до 32 768 вихідних токенів), тож відповідь, яка не вмістилася в 8 192 токени, має місце, щоб завершитися. Обидві дешевші за OpenRouter у сумі, з урахуванням входу й виходу разом; жива таблиця нижче показує стовпець OpenRouter поруч із нашим.
Перший прохід завжди охоплює всі 10 000 запитів: 8 000 000 на вході та 3 000 000 на виході токенів. Другий прохід охоплює лише ескаловану частку. Останній стовпець — альтернатива: усі 10 000 запитів одразу на другій моделі.
Прокрутіть таблицю праворуч →
| Ескалована частка | Токени другого проходу (вх / вих) | Перший прохід, усі 10 000 | Другий прохід, лише ескаловані | Усе на другій моделі, усі 10 000 |
|---|---|---|---|---|
| 10% | 800 000 / 300 000 | $0.28 | $0.042 | $0.42 |
| 30% | 2 400 000 / 900 000 | $0.28 | $0.126 | $0.42 |
| 50% | 4 000 000 / 1 500 000 | $0.28 | $0.21 | $0.42 |
Додайте стовпці першого й другого проходу в кожному рядку, щоб отримати місяць каскаду, потім порівняйте цю суму з останнім стовпцем. Перший прохід — фіксована вартість, і лише другий прохід зростає з p. Ось уся суть каскаду: чим більше ви ескалюєте, тим ближче ви до оплати роботи двічі.
Ось те саме навантаження для кожної моделі одразу, щоб ви бачили, де опиняються одномодельні варіанти:
| Модель | Вхід $/1М | Вихід $/1М | За запит | 10 000 запитів | OpenRouter, 10 000 запитів |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.28 | $0.517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.42 | $0.98 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.85 | $10.20 |
800 вхідних і 300 вихідних токенів на запит. Ціни за 1 млн токенів актуальні та змінюються разом із нашими тарифами; стовпець OpenRouter показує довідкові ціни для того самого навантаження.
Коли каскад не вартий того? Коли перший прохід плюс ескалована частка коштують більше, ніж надіслати все до другої моделі. У символах: дешева + p × друга < друга, що означає p < 1 − дешева/друга. Для цієї пари перший прохід коштує помітну частку ціни другої моделі на цьому навантаженні, тож вигода від каскаду зменшується, а при високій частці ескалації зникає. При 50% каскад може програти простому надсиланню всіх 10 000 запитів до другої моделі, тож перевірте суму двох проходів проти останнього стовпця, перш ніж зобов'язуватися. Співвідношення залежить від вашого співвідношення входу/виходу, бо дві моделі по-різному оцінюють обидві сторони, тож читайте його зі свого рядка.
Варіант із маршрутизатором додає одне: класифікатор. Припустімо, він читає 300 вхідних токенів і відповідає 5 токенами на дешевій моделі на кожен запит. Для 10 000 запитів це 3 000 000 вхідних і 50 000 вихідних токенів, або $0.062 на місяць зверху. Порівняйте цей рядок із часткою p стовпця першого проходу (10%, 30% або 50% від нього): це те, що каскад марнує, запускаючи перший прохід на запитах, які потім ескалюються. Якщо рядок класифікатора більший, каскад — дешевший старт; якщо менший, маршрутизатор заощаджує більше.
Спробуйте власні цифри, перш ніж щось будувати:
Калькулятор вартості
Один місяць бота підтримки, усе на одній моделі
Вхідні токени на запит: 800 · Вихідні токени на запит: 300 · Запитів на день: 10 000
| Модель | За день | За місяць |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.28 | $8.40 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.42 | $12.60 |
| MiniMax-M2.7$0.05$0.15 | $0.85 | $25.50 |
Змініть runs на свій обсяг і прочитайте підсумок для кожної моделі. Потім скористайтеся таблицею вище, щоб побачити, скільки до нього додасть другий прохід.
Маршрутизатор на Python: два виклики й одна перевірка#
Обидві моделі стоять за однією базовою URL-адресою, сумісною з OpenAI, і одним балансом, тож маршрутизація не потребує другого акаунта чи ключа. Код нижче — приклад: числа в ньому (max_tokens, правило UNSURE) — ваші для налаштування. Другий виклик отримує вищий max_tokens, тож відповідь, обрізана на 600 токенах, може завершитися. Базова URL-адреса, ідентифікатори моделей та решта — у документації CheapTokens.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CHEAP = 'zai-org/GLM-5.3-Flash'
SECOND = 'deepseek-ai/DeepSeek-V4-Flash-0731'
SYSTEM = 'Answer briefly. If you cannot answer well, reply exactly UNSURE.'


def ask(model, question, max_tokens):
    r = client.chat.completions.create(
        model=model,
        max_tokens=max_tokens,
        messages=[
            {'role': 'system', 'content': SYSTEM},
            {'role': 'user', 'content': question},
        ],
    )
    choice = r.choices[0]
    return choice.message.content or '', choice.finish_reason


def needs_escalation(text, finish_reason):
    return finish_reason == 'length' or not text.strip() or 'UNSURE' in text


def answer(question):
    text, why = ask(CHEAP, question, 600)
    if needs_escalation(text, why):
        text, why = ask(SECOND, question, 4000)
        if 'UNSURE' in text:
            text = 'Sorry, I could not answer this one.'
    return text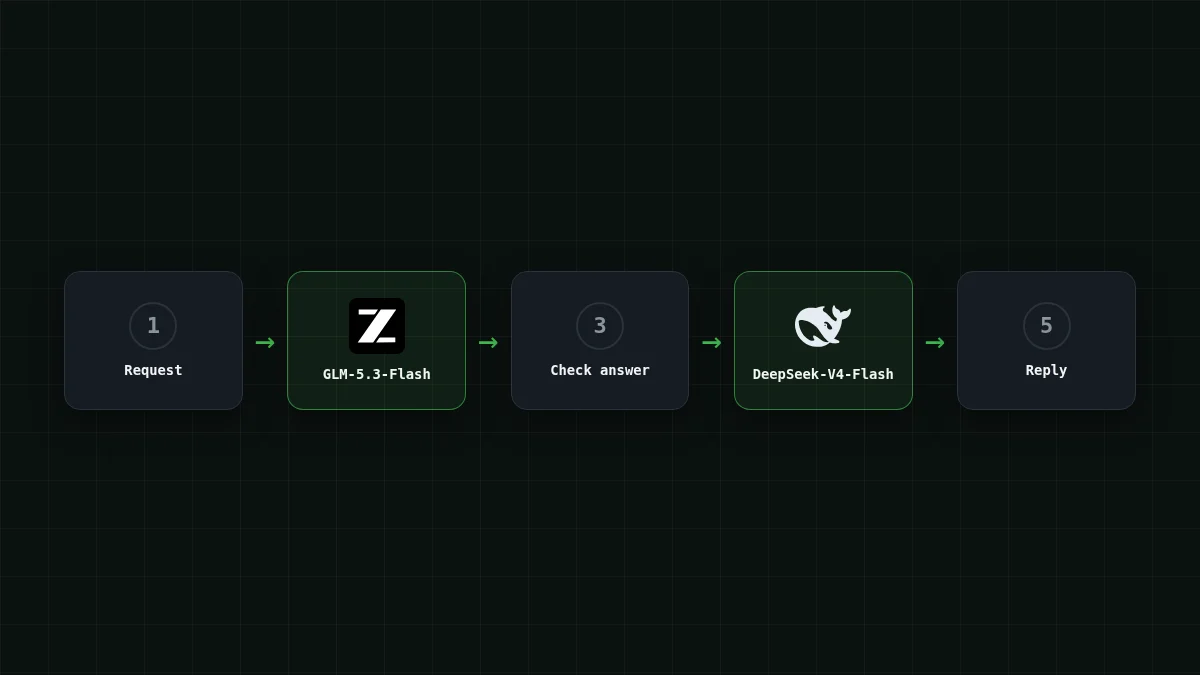
Три звички роблять це чесним, а не просто дешевим:
- Підраховуйте ескалації. Логуйте, як часто спрацьовує
needs_escalation. Це ваша p, і саме це число вирішує, чи окупається каскад. - Вибирайте другу модель на власному тестовому наборі. Візьміть 50 складних запитів зі своїх логів, проганьте їх через обидві моделі й залишайте другу модель, лише якщо вона виправляє ті, які пропустила перша. Її задокументована перевага — ліміт відповіді 32 768 токенів, і ваш власний набір покаже, чи це та перевага, яка вам потрібна.
- Надсилайте той самий запит, а не довший. Якщо ви вставляєте невдалу відповідь у другий виклик, ви платите за неї як за вхід. Починайте другий прохід чисто, якщо перша відповідь не є справді корисним контекстом.
Перевірте себе#
Швидка перевірка
У каскаді 30% запитів не проходять перевірку на першій моделі. Скільки коштують ці запити?
Показати відповідь
Відповідь: Ціна першої моделі плюс ціна другої моделі
Перший виклик уже оплачено, коли ви відкидаєте його відповідь. Ескаловані запити платять двічі, тому частка p вирішує все.
Куди рухатися далі#
Якщо ви не впевнені, яка модель має брати перший прохід, MiniMax-M2.7 vs DeepSeek-V4-Flash порівнює їх за завданнями. Для погляду на завдання, а не на токен, дивіться ціна за 1M токенів проти вартості за завдання, а для циклів із багатьма кроками — як оцінити вартість AI-агента. Живі ціни для кожної моделі — на сторінці цін, а сторінки моделей — DeepSeek і GLM.


