Оптимизация расходовИнструкция
Роутинг моделей: дешёвая модель первой, сложное — выше
Простые запросы идут на дешёвую модель, сложные — на вторую. Считаем стоимость 10 000 запросов при 10%, 30% и 50% эскалации и пишем роутер на Python.
Содержание
Роутинг может снизить счёт, когда первый проход на дешёвой модели заметно дешевле второй модели, а эскалируется немного запросов: каждый запрос сначала идёт на дешёвую модель, а на вторую уходят только сложные. Выгода зависит от доли запросов, которые вы эскалируете. Ниже расчёт для 10 000 запросов при 10%, 30% и 50% и функция на Python, которую можно вставить в проект.
Приём не новый. В инженерном посте Anthropic «Building effective agents» (19 декабря 2024) он назван routing workflow: частые простые вопросы идут на меньшую, экономичную модель, редкие сложные — на более мощную. Цен в посте нет, поэтому числа здесь наши, на живых ценах CheapTokens.
Какие из ваших запросов простые?#
Роутинг работает, только если «сложный» можно описать правилом, а не ощущением, — таким, которое проверит код. Выберите случай, ближе всего к вашему:
Выберите свой случай
Выберите свой случай
Выберите вариант, чтобы увидеть ответ
Чат-бот поддержки
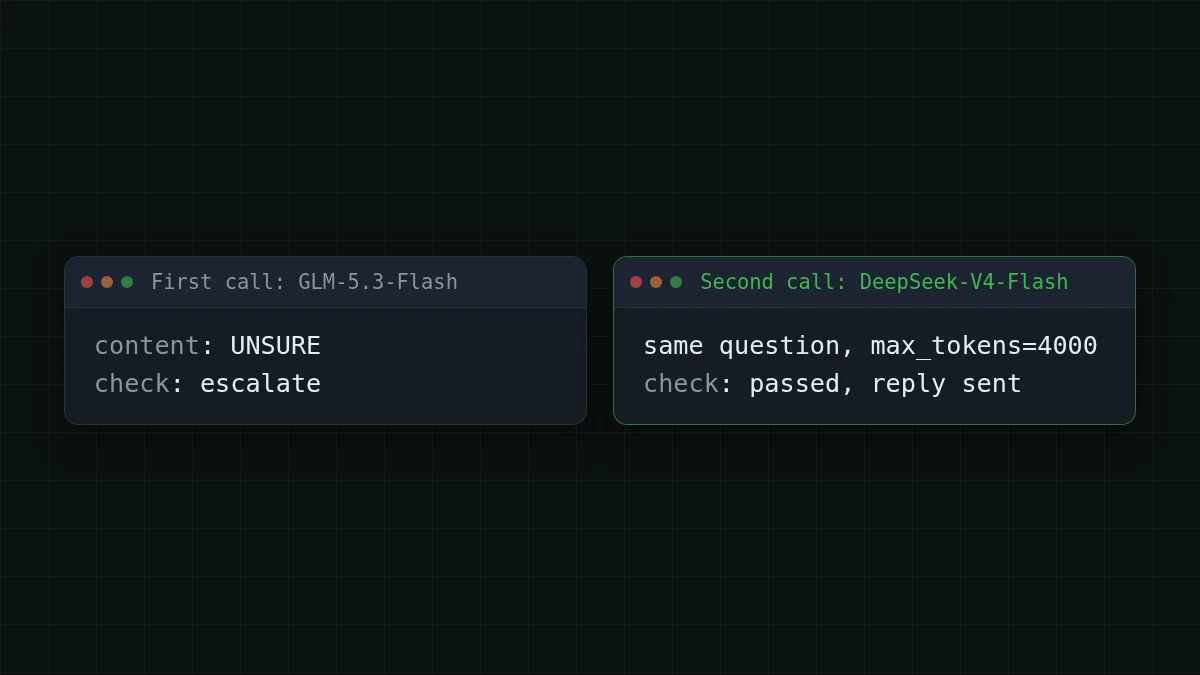
Большинство обращений — короткие FAQ: где мой заказ, как сбросить пароль. Немногие требуют длинного вдумчивого ответа. Простой: первая модель ответила и не написала UNSURE. Сложный: она написала UNSURE или ответ оборвался (finish_reason равен length).
Конвейер документов
Каждый документ сначала проходит извлечение полей. Простой: результат разбирается как валидный JSON со всеми обязательными полями. Сложный: разбор не удался или поле пустое. Только такие документы прогоняются заново на второй модели.
Кодовый агент
Простые правки идут на дешёвую модель. Шаг эскалируется, если он дважды подряд не удался или ответ оборвался (finish_reason равен length).
Не эскалируйте по принципу «модель звучит неуверенно», пока не договорились с ней, как об этом сообщать. Одна строка в промпте («если не можешь ответить, напиши ровно UNSURE») превращает ощущение в то, что читает if.
Сколько стоят 10 000 запросов: каскад и роутер#
Допустим, у вас бот поддержки на 10 000 запросов в месяц. Средний запрос — 800 токенов на входе и 300 на выходе. Это допущения: подставьте свои из поля usage (где их смотреть — в статье про токены в запросе).
Есть два способа собрать роутинг, и считаются они по-разному:
- Каскад. Каждый запрос идёт на дешёвую модель. Доля p не проходит проверку и отправляется повторно на вторую модель. Эти запросы оплачиваются дважды: стоимость = N × [дешёвая + p × вторая].
- Роутер. Небольшой вызов-классификатор решает заранее. Простые идут на дешёвую модель, сложные — сразу на вторую: стоимость = N × [(1 − p) × дешёвая + p × вторая], плюс классификатор на каждый запрос.
Дальше считаем каскад: классификатор не нужен, начать проще. Первый проход — GLM-5.3-Flash (zai-, контекст 390K, до 8 192 токенов в ответе). Второй — DeepSeek-V4-Flash выпуска 0731 (deepseek-, контекст 380K, до 32 768 токенов в ответе): ответ, который не уместился в 8 192 токена, там может закончиться. Обе модели в сумме, с учётом входа и выхода, дешевле OpenRouter; в живой таблице ниже колонка OpenRouter стоит рядом с нашей.
Первый проход всегда охватывает все 10 000 запросов: 8 000 000 токенов входа и 3 000 000 выхода. Второй проход — только эскалированную долю. Последний столбец — альтернатива: все 10 000 запросов сразу на второй модели.
Прокрутите таблицу вправо →
| Доля эскалации | Токены второго прохода (вход / выход) | Первый проход, все 10 000 | Второй проход, только эскалированные | Всё на второй модели, все 10 000 |
|---|---|---|---|---|
| 10% | 800 000 / 300 000 | $0.28 | $0.042 | $0.42 |
| 30% | 2 400 000 / 900 000 | $0.28 | $0.126 | $0.42 |
| 50% | 4 000 000 / 1 500 000 | $0.28 | $0.21 | $0.42 |
Сложите столбцы первого и второго прохода в каждой строке — получите месяц каскада — и сравните сумму с последним столбцом. Первый проход — постоянная часть, с p растёт только второй. В этом вся суть каскада: чем больше эскалируете, тем ближе к тому, что вы платите за работу дважды.
Та же нагрузка на каждой модели сразу — видно, где лежат варианты «всё на одной»:
| Модель | Вход $/1M | Выход $/1M | За запрос | 10 000 запросов | OpenRouter, 10 000 запросов |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.28 | $0.517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.42 | $0.98 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.85 | $10.20 |
800 входных и 300 выходных токенов на запрос. Цены за 1M токенов актуальны и меняются вместе с нашими тарифами; столбец OpenRouter показывает справочные цены для той же нагрузки.
Когда каскад не стоит затеи? Когда первый проход плюс эскалированная доля обходятся дороже, чем отправка всего на вторую модель. В символах: дешёвая + p × вторая < вторая, то есть p < 1 − дешёвая/вторая. Для этой пары первый проход на такой нагрузке стоит заметную долю цены второй модели, поэтому выгода каскада сжимается, а при большой доле эскалации исчезает. При 50% каскад может проиграть варианту «все 10 000 запросов сразу на вторую модель», так что перед внедрением сверьте сумму двух проходов с последним столбцом. Отношение зависит от вашего соотношения входа и выхода — модели оценивают стороны по-разному, — так что берите его из своей строки.
У роутера есть одна добавка — классификатор. Допустим, он читает 300 токенов входа и отвечает 5 токенами на дешёвой модели, на каждый запрос. На 10 000 запросов это 3 000 000 токенов входа и 50 000 выхода, то есть $0.062 в месяц сверху. Сравните эту строку с долей p от колонки первого прохода (10%, 30% или 50% от неё): столько каскад тратит впустую, прогоняя первый проход на запросах, которые потом эскалируются. Если строка классификатора больше, каскад — более дешёвое начало; если меньше — роутер выгоднее.
Подставьте свои числа до того, как что-то строить:
Калькулятор стоимости
Месяц бота поддержки, всё на одной модели
Входные токены на запрос: 800 · Выходные токены на запрос: 300 · Запросов в день: 10 000
| Модель | В день | В месяц |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.28 | $8.40 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.42 | $12.60 |
| MiniMax-M2.7$0.05$0.15 | $0.85 | $25.50 |
Поменяйте runs на свой объём и посмотрите итог по каждой модели. Затем по таблице выше оцените, сколько добавит второй проход.
Роутер на Python: два вызова и одна проверка#
Обе модели доступны через один OpenAI-совместимый base URL и один баланс, поэтому для роутинга не нужен второй аккаунт или ключ. Код ниже — пример: значения в нём (max_tokens, правило UNSURE) подберите под себя. Второй вызов получает больший max_tokens, чтобы ответ, оборванный на 600 токенах, мог закончиться. Base URL, id моделей и остальное — в документации CheapTokens.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CHEAP = 'zai-org/GLM-5.3-Flash'
SECOND = 'deepseek-ai/DeepSeek-V4-Flash-0731'
SYSTEM = 'Answer briefly. If you cannot answer well, reply exactly UNSURE.'


def ask(model, question, max_tokens):
    r = client.chat.completions.create(
        model=model,
        max_tokens=max_tokens,
        messages=[
            {'role': 'system', 'content': SYSTEM},
            {'role': 'user', 'content': question},
        ],
    )
    choice = r.choices[0]
    return choice.message.content or '', choice.finish_reason


def needs_escalation(text, finish_reason):
    return finish_reason == 'length' or not text.strip() or 'UNSURE' in text


def answer(question):
    text, why = ask(CHEAP, question, 600)
    if needs_escalation(text, why):
        text, why = ask(SECOND, question, 4000)
        if 'UNSURE' in text:
            text = 'Sorry, I could not answer this one.'
    return text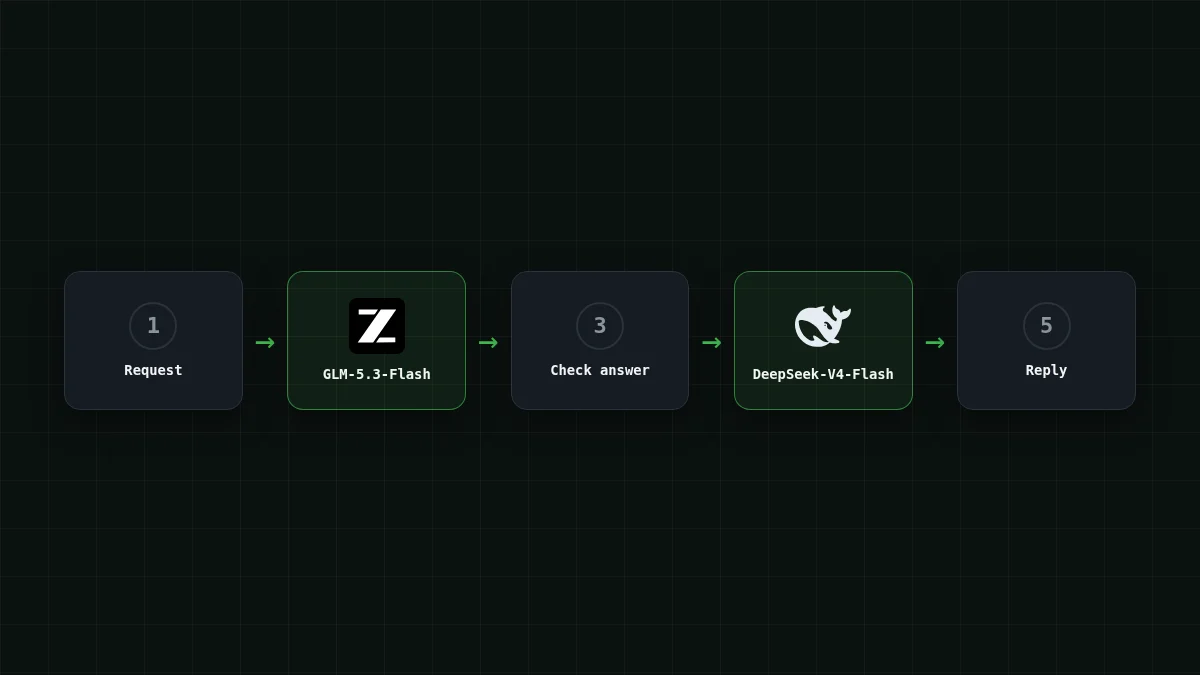
Три привычки делают это честной экономией, а не просто дешёвым решением:
- Считайте эскалации. Логируйте, как часто срабатывает
needs_escalation. Это ваше p, и именно оно решает, окупается ли каскад. - Вторую модель выбирайте на своём тестовом наборе. Возьмите из логов 50 сложных запросов, прогоните через обе модели и оставьте вторую, только если она исправляет то, что первая не смогла. Её документированное преимущество — лимит ответа 32 768 токенов; ваш набор покажет, то ли это преимущество, что вам нужно.
- Отправляйте тот же запрос, а не удлинённый. Если вставить неудачный ответ во второй вызов, вы заплатите за него как за вход. Начинайте второй проход с чистого листа, если первый ответ не несёт полезного контекста.
Проверьте себя#
Быстрая проверка
В каскаде 30% запросов не проходят проверку на первой модели. Сколько стоят эти запросы?
Показать ответ
Ответ: Цену первой модели плюс цену второй
Первый вызов уже оплачен, даже если вы выбросили ответ. Эскалированные запросы оплачиваются дважды — поэтому доля p решает всё.
Что почитать дальше#
Если не уверены, какую модель поставить на первый проход, MiniMax-M2.7 против DeepSeek-V4-Flash сравнивает их по задачам. Взгляд на задачу вместо токена — в статье цена за 1M токенов и стоимость задачи, а для циклов со многими шагами — как оценить стоимость ИИ-агента. Живые цены всех моделей — на странице цен, общий каталог — в моделях, страницы моделей — DeepSeek и GLM.


