Routage de modèles pour réduire le coût API : modèle bon marché d'abord, escalade
Envoyez les requêtes faciles à un modèle bon marché et n'escaladez que les difficiles. Voyez le coût mixte de 10 000 requêtes à 10 %, 30 % et 50 % d'escalade, plus un court routeur Python.
Sur cette page
Le routage peut réduire la facture lorsque la première passe du modèle bon marché est bien moins chère que le second modèle et que peu de requêtes sont escaladées : envoyez d'abord chaque requête au modèle bon marché et ne renvoyez que les plus difficiles à un second modèle. L'économie réelle dépend de la part de requêtes que vous escaladez. Voici l'arithmétique pour 10 000 requêtes à 10 %, 30 % et 50 %, et une fonction Python que vous pouvez coller dans votre projet.
Le schéma n'est pas nouveau. L'article d'ingénierie d'Anthropic "Building effective agents" (19 décembre 2024) l'appelle un workflow de routage : les questions courantes et faciles vont à un modèle plus petit et économique, et les questions inhabituelles et difficiles vont à un modèle plus capable. L'article ne donne pas de prix, donc les chiffres ici sont les nôtres, sur les prix live de CheapTokens.
Lesquelles de vos requêtes sont faciles ?#
Le routage ne fonctionne que si vous pouvez dire, dans une règle, ce que signifie « difficile ». Pas dans un ressenti, dans une règle que le code peut vérifier. Choisissez le cas le plus proche du vôtre :
Choisissez votre cas
Choisissez votre cas
Choisissez une option pour voir la réponse
Chatbot de support
La plupart des tickets sont de courtes FAQ : où est ma commande, comment réinitialiser un mot de passe. Quelques-uns nécessitent une réponse longue et soignée. Facile : le premier modèle répond et ne réplique pas UNSURE. Difficile : il dit UNSURE, ou la réponse est coupée (finish_reason vaut length).
Pipeline de documents
Chaque document passe d'abord par l'extraction. Facile : le résultat s'analyse comme un JSON valide avec tous les champs requis. Difficile : l'analyse échoue ou un champ est vide. Seuls ces documents sont relancés sur le second modèle.
Agent de codage
Les modifications simples vont au modèle bon marché. Escaladez une étape lorsque la même étape a échoué deux fois de suite, ou lorsque la réponse a été coupée (finish_reason vaut length).
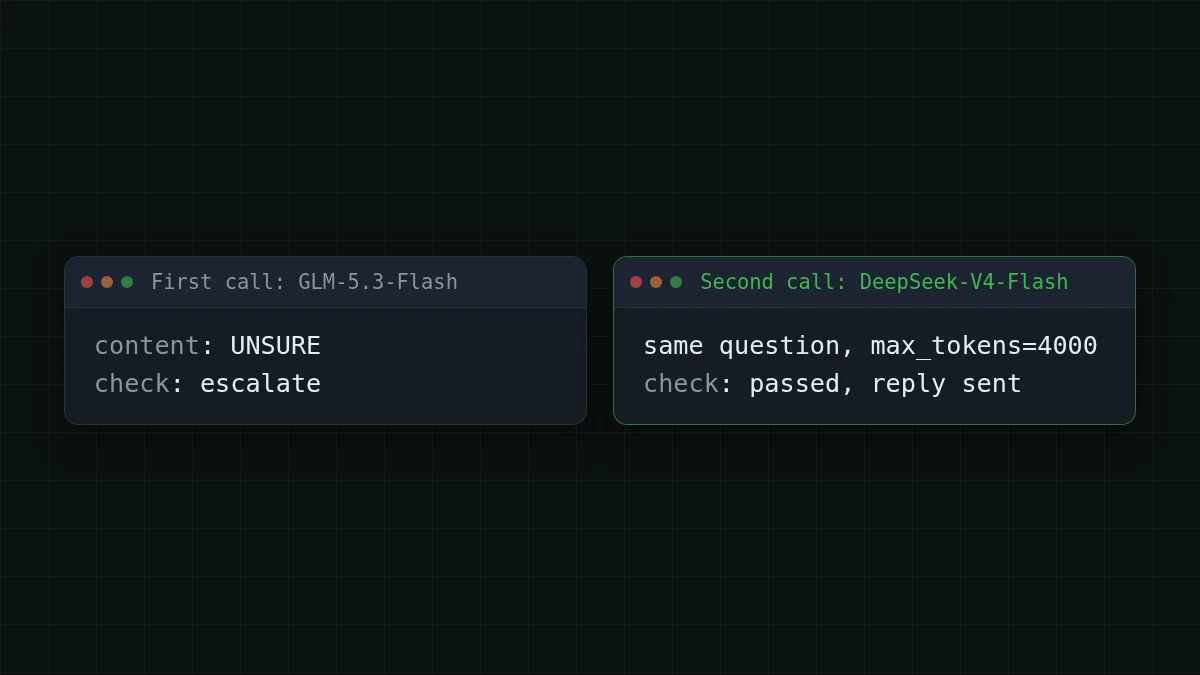
N'escaladez pas sur « le modèle semble incertain » sauf si vous lui avez dit comment le dire. Une instruction d'une ligne (« répondez exactement UNSURE si vous ne pouvez pas répondre ») transforme une impression en quelque chose que if peut lire.
Ce que coûtent 10 000 requêtes : cascade vs routeur#
Supposons que vous exploitiez un bot de support avec 10 000 requêtes par mois. Une requête moyenne fait 800 tokens en entrée et 300 tokens en sortie. Ce sont des hypothèses ; remplacez-les par les vôtres depuis usage (notre article sur le comptage des tokens montre où les lire).
Il y a deux façons de câbler le routage, et elles facturent différemment :
- Cascade. Chaque requête va au modèle bon marché. Une part p échoue au contrôle et est renvoyée au second modèle. Ces requêtes sont payées deux fois : coût = N × [bon marché + p × second].
- Routeur. Un petit appel de classificateur décide en amont. Les faciles vont au modèle bon marché, les difficiles directement au second : coût = N × [(1 − p) × bon marché + p × second], plus le classificateur sur chaque requête.
Nous utiliserons la cascade, car elle ne nécessite pas de classificateur et est la plus simple pour commencer. La première passe est GLM-5.3-Flash (zai-, contexte 390K, jusqu'à 8 192 tokens de sortie). La seconde passe est DeepSeek-V4-Flash version 0731 (deepseek-, contexte 380K, jusqu'à 32 768 tokens de sortie), afin qu'une réponse qui ne tenait pas dans 8 192 tokens ait la place de se terminer. Les deux sont moins chers qu'OpenRouter au total, entrée et sortie comptées ensemble ; le tableau live ci-dessous montre la colonne OpenRouter à côté de la nôtre.
La première passe couvre toujours les 10 000 requêtes : 8 000 000 en entrée et 3 000 000 en sortie. La seconde passe ne couvre que la part escaladée. La dernière colonne est l'alternative : les 10 000 requêtes directement sur le second modèle.
Faites défiler le tableau vers la droite →
| Part escaladée | Tokens de seconde passe (entrée / sortie) | Première passe, 10 000 au total | Seconde passe, escaladées uniquement | Tout sur le second modèle, 10 000 au total |
|---|---|---|---|---|
| 10 % | 800 000 / 300 000 | $0.28 | $0.042 | $0.42 |
| 30 % | 2 400 000 / 900 000 | $0.28 | $0.126 | $0.42 |
| 50 % | 4 000 000 / 1 500 000 | $0.28 | $0.21 | $0.42 |
Additionnez les colonnes première passe et seconde passe de chaque ligne pour obtenir le mois de la cascade, puis comparez cette somme à la dernière colonne. La première passe est un coût fixe, et seule la seconde passe augmente avec p. C'est toute l'histoire d'une cascade : plus vous escaladez, plus vous vous rapprochez de payer deux fois le travail.
Voici la même charge pour tous les modèles à la fois, pour que vous voyiez où se situent les options mono-modèle :
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 10 000 requêtes | OpenRouter, 10 000 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.28 | $0.517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.42 | $0.98 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.85 | $10.20 |
800 tokens d'entrée et 300 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
Quand une cascade n'est-elle pas rentable ? Lorsque la première passe plus la part escaladée coûte plus cher que d'envoyer tout au second modèle. En symboles : bon marché + p × second < second, ce qui signifie p < 1 − bon marché/second. Pour cette paire, la première passe coûte une part notable du prix du second modèle sur cette charge, donc le gain d'une cascade diminue, et à une part d'escalade élevée il disparaît. À 50 %, la cascade peut perdre face à l'envoi simple des 10 000 requêtes au second modèle, donc vérifiez la somme des deux passes par rapport à la dernière colonne avant de vous engager. Le ratio dépend de votre mix entrée/sortie, car les deux modèles tarifent différemment les deux côtés, donc lisez-le sur votre propre ligne.
La variante routeur ajoute une chose : le classificateur. Supposons qu'il lise 300 tokens en entrée et réponde en 5 tokens sur le modèle bon marché, par requête. Pour 10 000 requêtes, cela fait 3 000 000 en entrée et 50 000 en sortie, soit $0.062 par mois en plus. Comparez cette ligne avec la part p de la colonne première passe (10 %, 30 % ou 50 % de celle-ci) : c'est ce que la cascade gaspille en exécutant la première passe sur des requêtes qui sont ensuite escaladées. Si la ligne du classificateur est plus grande, la cascade est le départ le moins cher ; si elle est plus petite, un routeur économise davantage.
Essayez vos propres chiffres avant de construire quoi que ce soit :
Calculateur de coût
Un mois d'un bot de support, tout sur un seul modèle
Tokens d'entrée par requête: 800 · Tokens de sortie par requête: 300 · Requêtes par jour: 10 000
| Modèle | Par jour | Par mois |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.28 | $8.40 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.42 | $12.60 |
| MiniMax-M2.7$0.05$0.15 | $0.85 | $25.50 |
Changez runs pour votre volume et lisez le total pour chaque modèle. Utilisez ensuite le tableau ci-dessus pour voir combien une seconde passe y ajouterait.
Un routeur en Python : deux appels et un contrôle#
Les deux modèles se trouvent derrière une seule URL de base compatible OpenAI et un seul solde, donc le routage ne nécessite ni second compte ni clé. Le code ci-dessous est un exemple : les nombres qu'il contient (max_tokens, la règle UNSURE) sont à ajuster. Le second appel reçoit un max_tokens plus élevé, afin qu'une réponse coupée à 600 tokens puisse se terminer. L'URL de base, les ids de modèle et le reste sont dans la documentation CheapTokens.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CHEAP = 'zai-org/GLM-5.3-Flash'
SECOND = 'deepseek-ai/DeepSeek-V4-Flash-0731'
SYSTEM = 'Answer briefly. If you cannot answer well, reply exactly UNSURE.'


def ask(model, question, max_tokens):
    r = client.chat.completions.create(
        model=model,
        max_tokens=max_tokens,
        messages=[
            {'role': 'system', 'content': SYSTEM},
            {'role': 'user', 'content': question},
        ],
    )
    choice = r.choices[0]
    return choice.message.content or '', choice.finish_reason


def needs_escalation(text, finish_reason):
    return finish_reason == 'length' or not text.strip() or 'UNSURE' in text


def answer(question):
    text, why = ask(CHEAP, question, 600)
    if needs_escalation(text, why):
        text, why = ask(SECOND, question, 4000)
        if 'UNSURE' in text:
            text = 'Sorry, I could not answer this one.'
    return text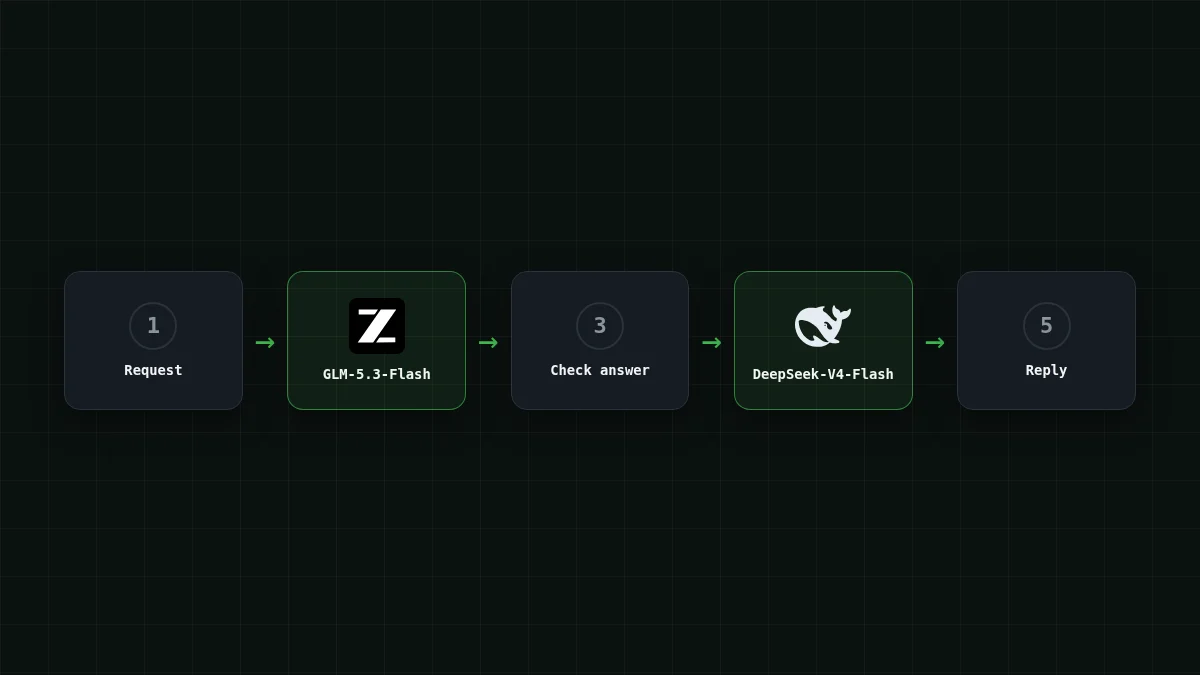
Trois habitudes rendent cela honnête plutôt que simplement bon marché :
- Comptez les escalades. Journalisez la fréquence de déclenchement de
needs_escalation. C'est votre p, et c'est le nombre qui décide si la cascade est rentable. - Choisissez le second modèle sur votre propre jeu de test. Prenez 50 requêtes difficiles dans vos logs, exécutez-les sur les deux modèles et ne gardez le second modèle que s'il corrige celles que le premier a manquées. Son avantage documenté est la limite de réponse de 32 768 tokens, et votre propre jeu montre si c'est l'avantage dont vous avez besoin.
- Envoyez la même requête, pas une plus longue. Si vous collez la réponse échouée dans le second appel, vous la payez en entrée. Démarrez la seconde passe proprement, sauf si la première réponse est un contexte réellement utile.
Vérifiez-vous#
Vérification rapide
Dans une cascade, 30 % des requêtes échouent au contrôle sur le premier modèle. Combien coûtent ces requêtes ?
Afficher la réponse
Réponse: Le prix du premier modèle plus le prix du second modèle
Le premier appel est déjà facturé quand vous jetez sa réponse. Les requêtes escaladées paient deux fois, c'est pourquoi la part p décide de tout.
Où aller ensuite#
Si vous n'êtes pas sûr du modèle qui doit prendre la première passe, MiniMax-M2.7 vs DeepSeek-V4-Flash les compare par tâche. Pour une vue par tâche plutôt que par token, voir prix par 1M de tokens vs coût par tâche, et pour les boucles à nombreuses étapes, comment estimer le coût d'un agent IA. Les prix live de chaque modèle sont sur la page de tarification, et les pages des modèles sont DeepSeek et GLM.


