IA pour débutantsGuide
Prix par million de tokens vs coût par tâche : comment comparer les modèles d'IA
Un modèle au prix par million de tokens plus bas peut tout de même coûter plus cher par tâche terminée. Apprenez à calculer le coût par tâche à partir des tokens d'entrée, des tokens de sortie et des tentatives.
Sur cette page
Comparez les modèles sur ce que coûte une tâche terminée, pas sur le prix par million de tokens. Une tâche coûte tokens in × prix d'entrée + tokens out × prix de sortie, multiplié par le nombre de tentatives nécessaires. Ainsi, un modèle à moitié prix par token peut tout de même vous présenter la facture la plus salée.
C'est la surprise habituelle : l'agent a terminé, la grille tarifaire semblait bon marché, et la facture dépasse ce que la tâche méritait. Voyons où se cache la différence.
Un prix par token, c'est un prix au kilo#
Un prix au kilo de farine ne vous dit rien du coût du dîner. Il faut savoir combien de kilos la recette demande, et si vous brûlez le premier lot pour recommencer.
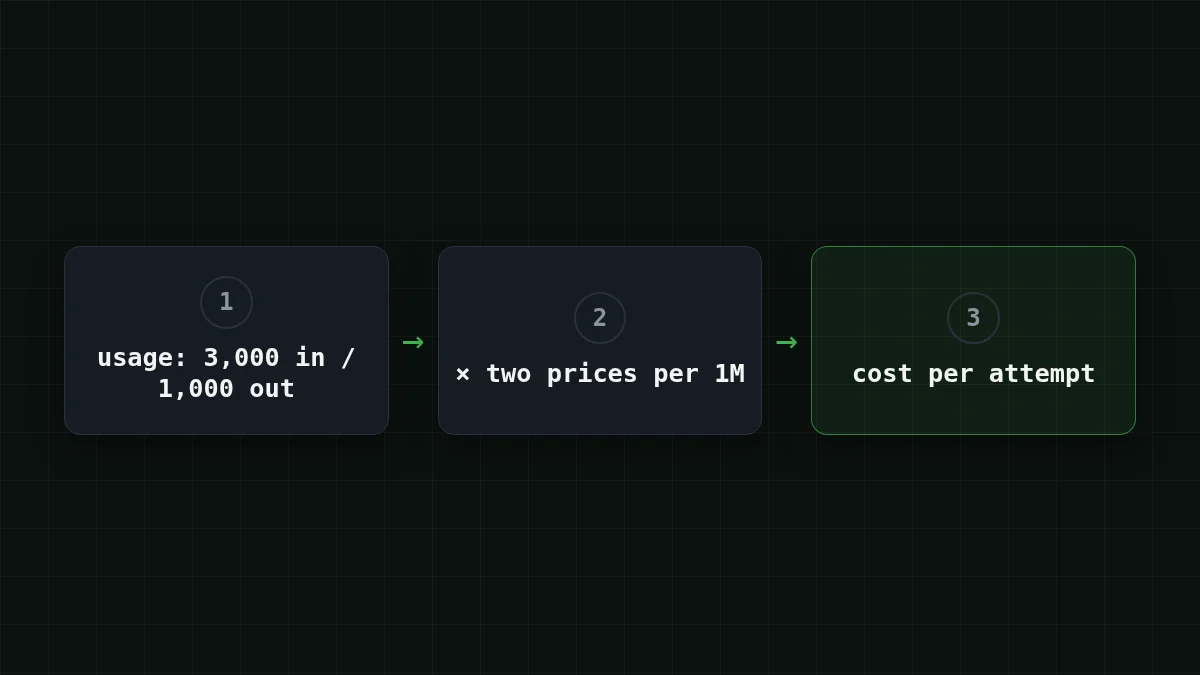
Les modèles d'IA fonctionnent de la même façon. Le prix par million de tokens, c'est le prix au kilo. La tâche, c'est le dîner. Chaque requête est facturée sur deux faces : les tokens que vous envoyez (entrée) et les tokens que le modèle renvoie (sortie). Ces deux nombres reviennent dans le champ usage de chaque réponse d'une API compatible OpenAI, comme l'API CheapTokens sur https:/ (vérifié le 29 octobre 2026), vous n'avez donc jamais à les deviner.
Voici la formule complète :
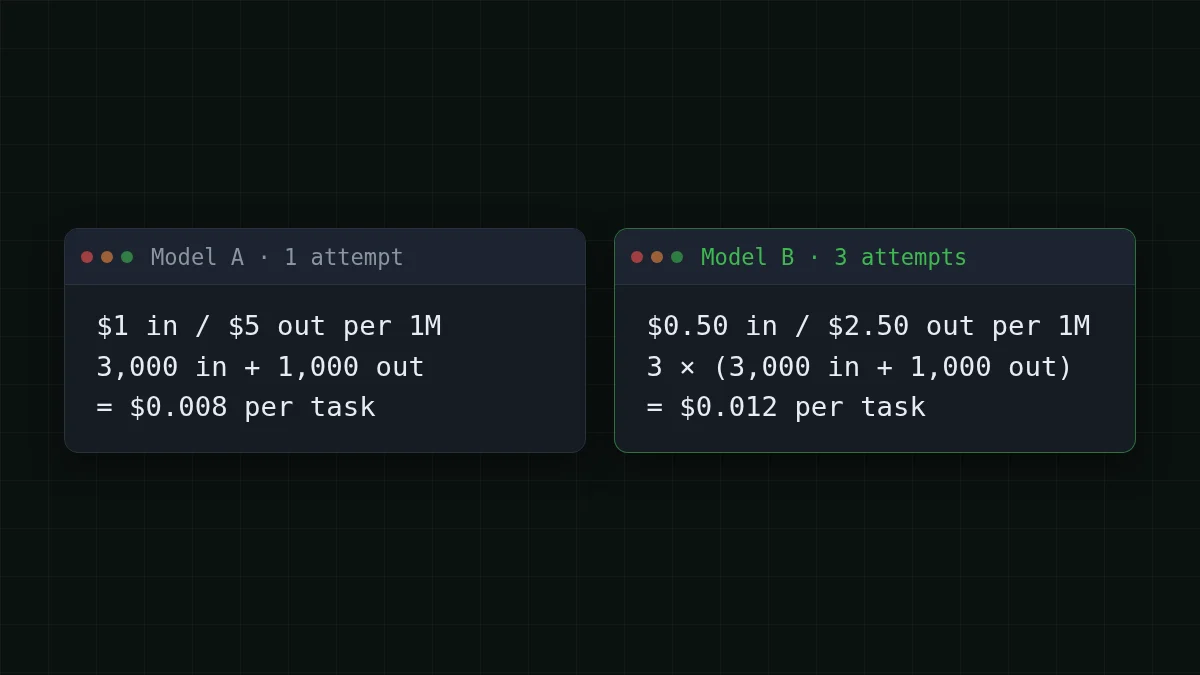
cost per task = attempts × (tokens in × input price + tokens out × output price)Prenons une tâche qui envoie 3 000 tokens et en reçoit 1 000. Le modèle A coûte 1 $ par million de tokens en entrée et 5 $ en sortie. Le modèle B est à moitié prix : 0,50 $ et 2,50 $. (Ce sont des prix ronds inventés pour le calcul, pas la grille tarifaire de qui que ce soit.)
Modèle A, une tentative :
- 3 000 × 1 $ ÷ 1 000 000 = 0,003 $ en entrée
- 1 000 × 5 $ ÷ 1 000 000 = 0,005 $ en sortie
- 0,003 $ + 0,005 $ = 0,008 $ par tâche
Le modèle B semble être l'affaire. Mais disons qu'il lui faut trois essais pour obtenir un résultat utilisable, et que chaque essai coûte pareil :
- 3 000 × 0,50 $ ÷ 1 000 000 = 0,0015 $ en entrée
- 1 000 × 2,50 $ ÷ 1 000 000 = 0,0025 $ en sortie
- 0,0015 $ + 0,0025 $ = 0,004 $ par tentative
- 3 × 0,004 $ = 0,012 $ par tâche
Moitié prix par token, une fois et demie le prix par tâche. La même chose se produit sans nouvelle tentative si B écrit simplement des réponses plus longues : avec 3 000 tokens de sortie en une tentative, 3 000 × 2,50 $ ÷ 1 000 000 = 0,0075 $, et 0,0015 $ + 0,0075 $ = 0,009 $. Toujours plus que les 0,008 $ de A.
Et l'inverse est vrai aussi. Si B réussit du premier coup, il coûte 0,004 $ par tâche, la moitié de A. Le prix par token ne l'emporte que lorsque le nombre de tokens et de tentatives est à peu près égal. C'est exactement ce qu'il faut vérifier.
Cartes mémo
Les termes que vous croiserez dans toute doc d'API
Touchez une carte pour la retourner
Où passent réellement les tokens par tâche#
Trois choses font varier le nombre de tokens, et aucune n'apparaît sur une grille tarifaire.
- La longueur de la réponse. Un modèle qui s'explique longuement écrit plus de tokens de sortie qu'un modèle qui répond en une ligne.
- Les nouvelles tentatives. Une réponse échouée ou inutilisable a quand même coûté des tokens, et l'essai suivant repaie.
- Le contexte renvoyé. Une API ne se souvient de rien : chaque étape d'un agent renvoie les instructions, les fichiers et l'historique. Si c'est nouveau pour vous, pourquoi une longue conversation coûte plus cher en montre le mécanisme.
La troisième est la grande affaire pour les agents. Prenez un agent de code qui travaille en 20 étapes. Supposez une étape d'agent lourde : 20 000 tokens en entrée et 1 000 en retour. Pour une exécution plus légère avec de vrais chiffres étape par étape, voir pourquoi les agents IA utilisent autant de tokens. Les réponses sont courtes. L'entrée ne l'est pas.
Devinez le nombre
Combien de tokens d'entrée un agent de 20 étapes envoie-t-il au total, si chaque étape en envoie 20 000 ?
Votre estimation
01 000 000
Afficher la réponse
Réponse: 400 000
20 × 20 000 = 400 000. Chaque étape renvoie le contexte, donc l'entrée s'accumule même si chaque réponse est courte.
Donc pour ce travail, c'est le côté entrée qui décide de la facture, et le côté sortie compte à peine. Un modèle au prix d'entrée bon marché peut l'emporter ici même si son prix de sortie paraît ordinaire. C'est ce qu'une grille tarifaire ne vous montre que si vous la lisez en pensant à votre propre tâche.
Voici ce travail exact, 20 étapes de 20 000 en entrée et 1 000 en sortie, sur les modèles disponibles chez CheapTokens. Le tableau est en direct, donc les chiffres suivent les prix actuels, et la colonne OpenRouter est là pour comparaison. Entrée et sortie comptées ensemble, les trois sont moins chers qu'OpenRouter au total.
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 20 requêtes | OpenRouter, 20 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00044 | $0.0088 | $0.0151 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0004 | $0.008 | $0.0308 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0012 | $0.023 | $0.276 |
20 000 tokens d'entrée et 1 000 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
Pour des boucles d'agent comme celle-ci, DeepSeek-V4-Flash est un choix naturel : 380K de contexte, jusqu'à 32 768 tokens de sortie par réponse, et un prix unique à toute heure, donc une exécution nocturne coûte pareil qu'une diurne. Le travail complet sur les 20 étapes revient à $0.008. Voir la page du modèle pour les détails et la grille tarifaire pour tous les modèles.
Un chatbot, c'est l'histoire inverse#
Prenez maintenant un bot de support. Disons qu'il reçoit 1 000 requêtes par jour, et que chacune est une question de 2 000 tokens avec contexte et une réponse de 500 tokens. Pas de boucle, pas d'historique qui grandit, une seule tentative.
Ici, le prix par token est presque le coût par tâche, car rien ne le multiplie. Sur GLM-5.3-Flash, avec 390K de contexte et jusqu'à 8 192 tokens de sortie par réponse, une requête coûte $0.00006 et la journée entière de 1 000 requêtes coûte $0.06.
La règle empirique est donc simple. Une tâche courte et en un seul coup : le prix par token est un bon guide. Une boucle, un travail sujet aux nouvelles tentatives ou aux réponses longues : chiffrez une tâche entière avant de choisir.
Mesurez votre propre tâche en dix minutes#
Vos propres chiffres valent mieux que n'importe quel exemple ici. Le script ci-dessous envoie une requête et affiche ce qu'elle a réellement consommé et ce que cela coûte. Les prix qu'il contient sont un exemple : remplacez-les par les prix actuels de la grille tarifaire.
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1", api_key="YOUR_KEY")

# example prices per 1M tokens, substitute current ones
PRICE_IN, PRICE_OUT = 1.00, 5.00

resp = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Summarize this ticket in one sentence: <your text>"}],
    max_tokens=300,
)
u = resp.usage
cost = (u.prompt_tokens * PRICE_IN + u.completion_tokens * PRICE_OUT) / 1_000_000
print(u.prompt_tokens, u.completion_tokens, round(cost, 6))
Quand il fonctionne, vous obtenez trois nombres sur une ligne : tokens en entrée, tokens en sortie et le coût de cette tentative. Ensuite :
- Lancez 20 vraies tâches à vous, pas des tâches jouets.
- Additionnez le coût de chaque tentative, y compris celles que vous avez jetées.
- Divisez par 20. C'est votre coût par tâche.
- Répétez avec l'autre modèle et comparez les deux résultats.
Pour une exécution plus longue, suivre le coût en tokens d'un agent en Python ajoute un budget et un arrêt à la même idée, et combien de tokens une requête utilise montre des tailles typiques pour commencer.
Vérification rapide#
Vérification rapide
Le modèle B coûte moitié moins par token que le modèle A. Quand B peut-il encore coûter plus cher par tâche terminée ?
Afficher la réponse
Réponse: Quand il faut plus de tentatives ou qu'il écrit des réponses bien plus longues
Coût par tâche = tentatives × tokens × prix. Divisez le prix par deux, triplez les tentatives et vous payez 1,5 fois plus.
Ensuite, tokens d'entrée vs tokens de sortie explique pourquoi les deux faces ont des prix différents, et la doc vous mène d'une clé à une première requête.


