Actus IAMise à jour
Prix de l'API Meta Muse Ember : 0,10 $ / 0,50 $, contexte de 1M
Meta Muse Ember : paliers tarifaires, contexte de 1M, sortie de 512K, et ce que coûte une session d'agent de 50 étapes, avec une alternative de sous-tâche bon marché.
Sur cette page
Le nouveau Muse Ember de Meta est un petit modèle conçu pour les étapes répétées et bon marché au sein d'un agent, et selon l'annonce de Meta, il coûte 0,10 $ en entrée et 0,50 $ en sortie par million de tokens sur des prompts allant jusqu'à 200K tokens. Au-delà de 200K, le prix triple. Une session d'agent de 50 étapes à 20K tokens en entrée et 500 en sortie par étape revient à environ 0,11 $ sur Ember, et le même rôle vous est ouvert chez CheapTokens avec DeepSeek-V4-Flash.
Le modèle a été annoncé le 9 novembre 2026 sur le blog de recherche de Meta (research.meta.ai/blog/muse-ember) ; l'article affiche une date mais pas d'heure. Nous avons consulté le blog et la page du modèle sur dev.meta.ai le 10 novembre 2026.
Ce que Meta a annoncé#
Muse Ember (id de modèle muse-ember-1.0) est le plus petit et le plus efficace des modèles de la gamme Muse de Meta, destiné aux sous-tâches d'agent : appels d'outils, extraction, routage, analyse de longs documents. Vous y accédez via Muse Code, la Meta Model API (mode Standard uniquement), Google Cloud et Oracle Cloud. Meta n'annonce pas de poids ouverts, donc l'API et Muse Code sont les seuls accès. Les régions ne sont pas précisées.
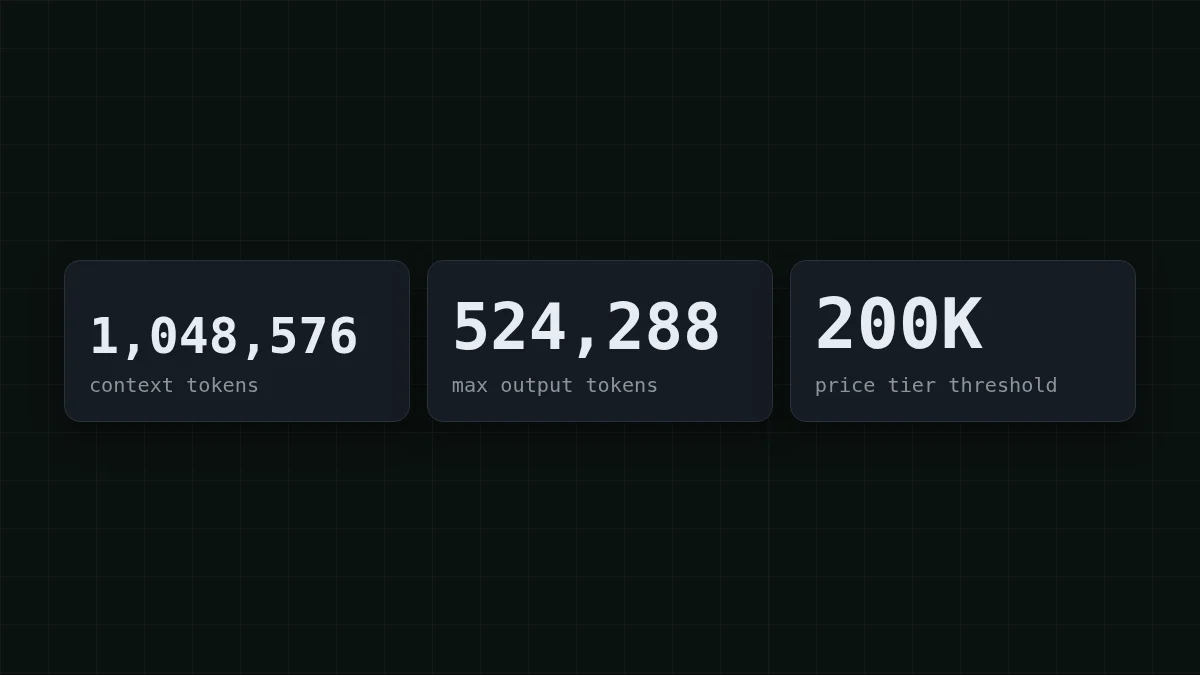
Les limites de la page du modèle de Meta (dev.meta.ai/docs/muse-ember, aucune date sur la page). Fenêtre de contexte — 1 048 576 tokens, sortie maximale — 524 288 tokens, et le palier tarifaire supérieur s'applique au-delà de 200K tokens de prompt.
Il accepte du texte, des images, de la vidéo, de l'audio et des PDF en entrée et renvoie du texte. Vous pouvez l'appeler via les endpoints Responses, Chat Completions ou Messages, avec appel d'outils, sortie structurée, computer use, compréhension d'images et search grounding. L'effort de raisonnement va de minimal à max, et la valeur par défaut est max. Le streaming n'est pas mentionné sur la page, nous ne l'affirmerons donc pas.
Meta a aussi publié des chiffres de benchmark, et ils sont de Meta, majoritairement à raisonnement max : Terminal-Bench 4.0 à 40,9 % contre 39,2 % pour Haiku 5.5, AutomationBench-AA à 37,8 % contre 13,9 % et 20,2 % pour les deux autres que Meta liste, et FrontierCode 2.0-AA à 27,2 %, derrière Haiku 5.5 à 34,9 %. Sur l'Artificial Analysis Intelligence Index, il obtient 36 contre 37 pour Muse Spark 1.3. Considérez-les comme des affirmations d'un fournisseur tant que vous n'avez pas testé vos propres cas.
Ce que coûte une session de 50 étapes sur Ember#
Le tableau des prix, selon l'annonce de Meta (la page du modèle renvoie elle-même à une page de tarifs sans chiffres) :
Faites défiler le tableau vers la droite →
| Taille du prompt | Entrée | Entrée en cache | Sortie |
|---|---|---|---|
| jusqu'à 200K tokens | 0,10 $ | 0,004 $ | 0,50 $ |
| plus de 200K tokens | 0,30 $ | 0,012 $ | 1,50 $ |
Les prix sont par million de tokens, vérifiés le 10 novembre 2026. Des sources secondaires décrivent différemment la règle au-delà de 200K, alors confirmez-la sur la page de tarifs de Meta avant de budgétiser dessus.
Maintenant, une session. Disons que votre agent fait 50 étapes, et que chaque étape envoie environ 20K tokens (l'historique croissant plus les résultats d'outils) et reçoit environ 500 tokens en retour. Cela fait 1M de tokens en entrée et 25K en sortie au total. Sur Ember : 1 × 0,10 $ + 0,025 × 0,50 $ = 0,1125 $ (comptes de tokens en millions). Le côté entrée représente presque toute la facture, c'est pourquoi le prix de l'entrée en cache de 0,004 $ compte si votre agent conserve le même préfixe.
Devinez le nombre
Supposons que le tarif supérieur s'applique à l'ensemble du prompt (c'est ce que suggère la formulation de Meta). Combien de centimes coûte l'entrée d'un prompt de 250K tokens sur Ember ?
Votre estimation
020
Afficher la réponse
Réponse: 7,5
Si le tarif supérieur s'applique à l'ensemble du prompt : 250 000 × 0,30 $ par million = 0,075 $, soit 7,5 centimes pour la seule entrée. Cinquante étapes de ce type représenteraient 3,75 $ d'entrée.
Pourquoi des prompts longs ? Parce que les agents renvoient l'historique à chaque étape ; si c'est nouveau pour vous, pourquoi un agent relit tout son historique l'explique avec un petit exemple.
Dans quel palier se situe votre prompt ?#
La ligne des 200K est celle à surveiller. Meta affiche des tarifs trois fois plus élevés pour les prompts plus longs : 0,30 $ en entrée, 0,012 $ en entrée en cache et 1,50 $ en sortie.
Choisissez votre cas
Où se situe la plus grosse requête de votre agent ?
Choisissez une option pour voir la réponse
Moins de 200K tokens
Vous restez dans le palier inférieur. Budgétez avec 0,10 $ en entrée / 0,50 $ en sortie et surveillez le côté sortie si vous laissez l'effort de raisonnement par défaut.
Entre 200K et 1M tokens
Le palier supérieur s'applique, et la fenêtre de 1 048 576 tokens d'Ember vous accueille encore. Tronquez les anciennes sorties d'outils avant de franchir 200K, ou découpez la tâche pour qu'une seule étape porte le document complet.
Plus de 1M tokens
Cela ne tient pas dans une seule requête. Découpez l'entrée et laissez un planificateur fusionner les résultats.
Le même rôle de sous-tâche bon marché chez CheapTokens#
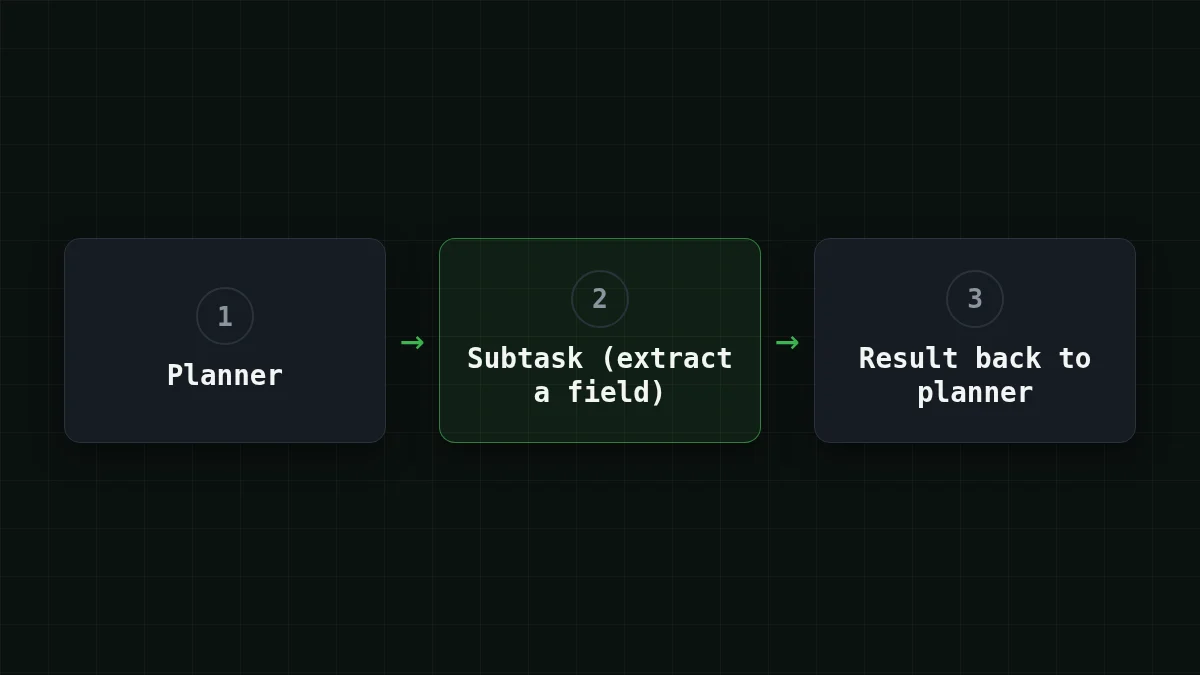
Une architecture d'agent courante réserve un plus gros modèle à la planification et envoie les sous-tâches répétées à un modèle bon marché. Pour ce second siège, CheapTokens propose DeepSeek-V4-Flash : un contexte de 380K, jusqu'à 32 768 tokens de sortie par réponse, un prix unique à toute heure sans heures de pointe, une API compatible OpenAI et Anthropic, et un solde unique pour tous les modèles. GLM-5.3-Flash est l'autre option pour les boucles d'appels d'outils et l'analyse de longs documents, avec un contexte de 390K et jusqu'à 8 192 tokens de sortie. Lancez 20 de vos propres sous-tâches sur DeepSeek-V4-Flash et comparez les résultats via le champ usage.
Voici la même session de 50 étapes, 20K tokens en entrée et 500 en sortie par étape, tarifée en direct :
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 50 requêtes | OpenRouter, 50 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00042 | $0.021 | $0.0356 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00035 | $0.0175 | $0.0735 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0011 | $0.0538 | $0.645 |
20 000 tokens d'entrée et 500 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
La ligne DeepSeek-V4-Flash pour toute la session est $0.0175 ; au total, entrée et sortie comprises, cela revient moins cher que le prix de référence d'OpenRouter pour le même modèle. Les prix de cette page se mettent à jour d'eux-mêmes.
L'essayer ne demande qu'une requête. La clé se place dans une variable d'environnement, et l'id de modèle est celui complet de la doc (la doc en donne la liste ; tarifs les taux actuels) :
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Extract the order number from: Order #48213 shipped today."}],
    "max_tokens": 100
  }'
La réponse contient l'objet usage habituel, vous pouvez donc lire les tokens réels d'entrée et de sortie de votre sous-tâche et les reporter dans le tableau ci-dessus. Pour le patron de routage lui-même, voir routage de modèles : modèle bon marché d'abord, escalade et, pour en savoir plus sur le modèle, DeepSeek sur CheapTokens.
Surveillez le côté sortie#
L'effort de raisonnement par défaut d'Ember est max, et les chiffres de benchmark de Meta ont majoritairement été obtenus ainsi. Une sous-tâche qui doit seulement extraire un champ d'un document n'en a pas besoin, et un effort de raisonnement plus élevé peut signifier plus de tokens de sortie, le côté le plus cher. Les pages de Meta ne précisent pas comment les tokens de raisonnement sont comptés, alors lisez usage plutôt que de supposer.
Essayez vous-mêmeEssayez : comment savoir ce que dépense réellement une sous-tâche ?Afficher la réponse
Envoyez 20 vraies sous-tâches au réglage d'effort le plus bas, puis au réglage par défaut, et lisez usage dans chaque réponse. Multipliez la moyenne d'entrée et de sortie par vos étapes par jour et calculez le coût aux prix d'Ember du tableau ci-dessus. Si les réponses concordent sur vos cas, le réglage le moins cher est celui à garder. Pourquoi cela fonctionne, c'est expliqué dans effort de raisonnement et tokens de réflexion.
La lecture pratique pour les développeurs : Ember est tarifé pour le siège bon marché d'un agent, la ligne des 200K est le chiffre autour duquel concevoir, et le seul chiffre qui tranche est celui de votre propre champ usage.


