Optimisation des coûtsAnalyse
Budgéter un projet agent de longue durée : calcul vs tokens (cas RSA-260)
Le titre des 400 k$ de RSA-260 correspond à de la location de GPU, pas à des tokens de modèle. Découpez un projet agent de longue durée en trois lignes de budget et dimensionnez la partie tokens avec sessions × étapes × tokens.
Sur cette page
Ce chiffre d'environ 400 k$ issu de la factorisation RSA-260 de Cognition correspond à de la location de GPU, pas à une facture de modèle. Le rapport ne chiffre pas du tout le volet agent : si vous prévoyez un projet agent de longue durée, vous devez estimer vous-même la ligne tokens : sessions × étapes × tokens par étape, aux prix du marché. C'est ce que fait le reste de cette page.
La source est l'article de Cognition rédigé par Eric Lu, ingénieur chez Cognition (Factoring RSA-260, publié le 9 septembre 2026, vérifié le 6 novembre 2026). Il est repartagé avec le montant en dollars dans le titre, et ce montant est facile à mal interpréter.
Ce que les 400 k$ paient réellement#
L'auteur a factorisé un nombre de 260 chiffres avec GNFS, à l'aide d'une version fortement modifiée de CADO-NFS exécutée sur GPU. Le rapport donne le temps GPU de chaque phase :
- sélection polynomiale : 643 jours-GPU
- criblage : 3 813 jours-GPU
- résolution du système linéaire : 467 jours-GPU
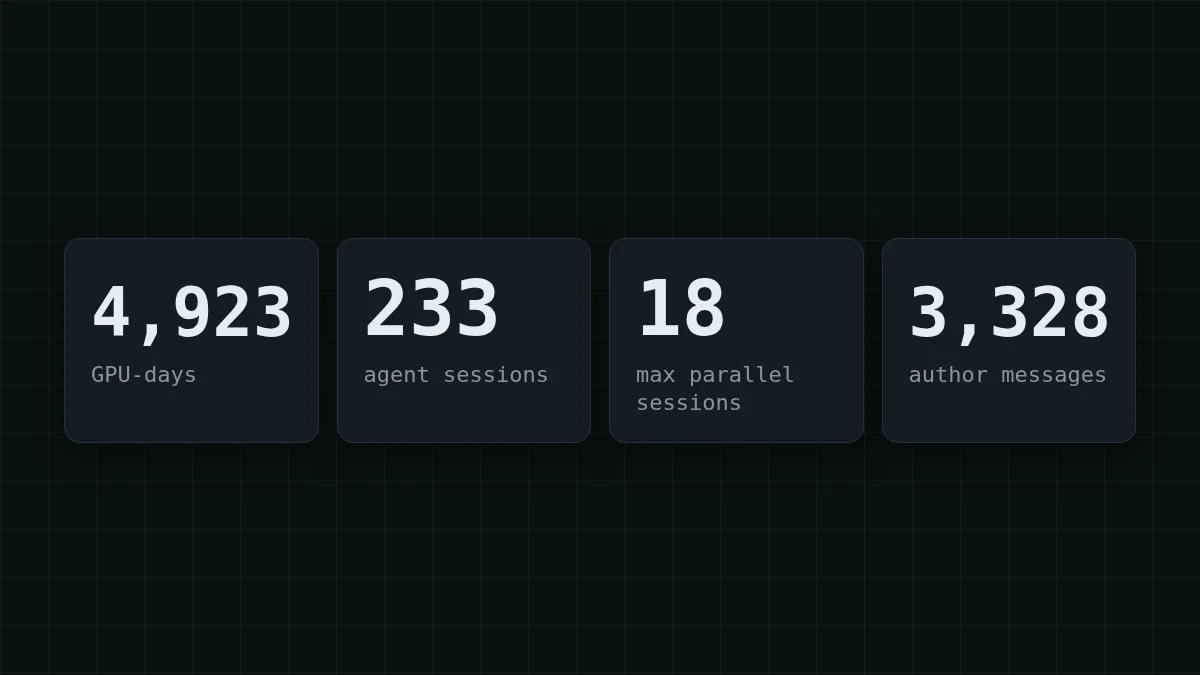
Soit 643 + 3 813 + 467 = 4 923 jours-GPU, que le rapport arrondit à ~4 900. Au tarif supposé de 3,50 $ par heure-GPU :
4 923 × 24 × 3,50 = 413 532
Cela correspond au chiffre de 414 k$ pour les GPU donné en annexe. Le titre désigne donc du matériel loué exécutant un calcul intensif pendant des semaines. Aucun token de modèle n'entre dans cette somme.
Vérification rapide
À quoi correspond le chiffre d'environ 400 k$ dans le rapport RSA-260 ?
Afficher la réponse
Réponse: Location de GPU au tarif du marché pour l'exécution de la factorisation
Il provient des jours-GPU × 3,50 $ par heure-GPU. Le rapport ne nomme aucun modèle et ne donne aucun nombre de tokens pour la partie agent.
Ce que les agents ont fait, et ce que le rapport ne dit pas#
Le volet agent est décrit par l'activité, pas par le coût. Le premier prompt a été envoyé le 13 août 2026, le travail a pris environ trois semaines, et les chiffres sont :
- 233 sessions Devin pour la factorisation, en moyenne 3 en parallèle et 18 au pic
- 192 d'entre elles ont reçu des messages de l'auteur, 36 ont tourné sans aucune intervention humaine
- 101 sessions enfants ont été lancées par d'autres sessions
- la comptabilité propre à Devin : 14 450 ACU (c'est l'unité de Devin, pas des tokens)
Les sessions ont pris en charge la mesure, l'exploitation du cluster, le réglage et le débogage. L'humain a fixé les priorités et construit les benchmarks. Deux détails honnêtes de l'auteur : la décomposition autour de CADO-NFS a été conçue par une personne et était essentielle, et les agents se sont perdus à mesure que le code s'éloignait de l'amont.
Ce qui manque est exactement ce dont un budget a besoin : quels modèles, combien de tokens. N'essayez donc pas de déduire une facture de tokens à partir de 14 450 ACU. Tout ce que vous lisez en ligne qui le fait est une supposition.
La troisième ligne : le pilotage humain#
L'auteur a envoyé 3 328 messages, soit 82 702 mots au total. Cela fait 82 702 ÷ 3 328 ≈ 25 mots par message, de courtes relances plutôt que des dissertations. Ces mots coûtent presque rien en tokens. Ils coûtent de l'attention : quelqu'un doit lire ce que les agents ont fait et décider de la suite. Quand vous budgétez un projet agent, mettez cela sur sa propre ligne en heures, pas en dollars de consommation d'API.
Un projet agent de longue durée comporte donc trois lignes :
Faites défiler le tableau vers la droite →
| Ligne | Dans le rapport RSA-260 | Ce qui la détermine chez vous |
|---|---|---|
| Calcul | ~414 k$ de temps GPU, à 3,50 $ par heure-GPU | Votre tâche elle-même : builds, tests, entraînement, simulations |
| Tokens de modèle | Non communiqué | Sessions × étapes × tokens par étape |
| Pilotage humain | 3 328 messages sur ~3 semaines | Fréquence à laquelle vous relisez et réorientez |
Estimez votre ligne tokens#
Voici la formule, et le point que les gens oublient : chaque étape renvoie l'historique. Un agent ne se souvient pas d'une session ; chaque appel transporte la tâche, les fichiers lus et la sortie des outils jusqu'ici. C'est pourquoi les tokens d'entrée dépassent généralement largement les tokens de sortie (voir pourquoi les agents IA consomment autant de tokens).
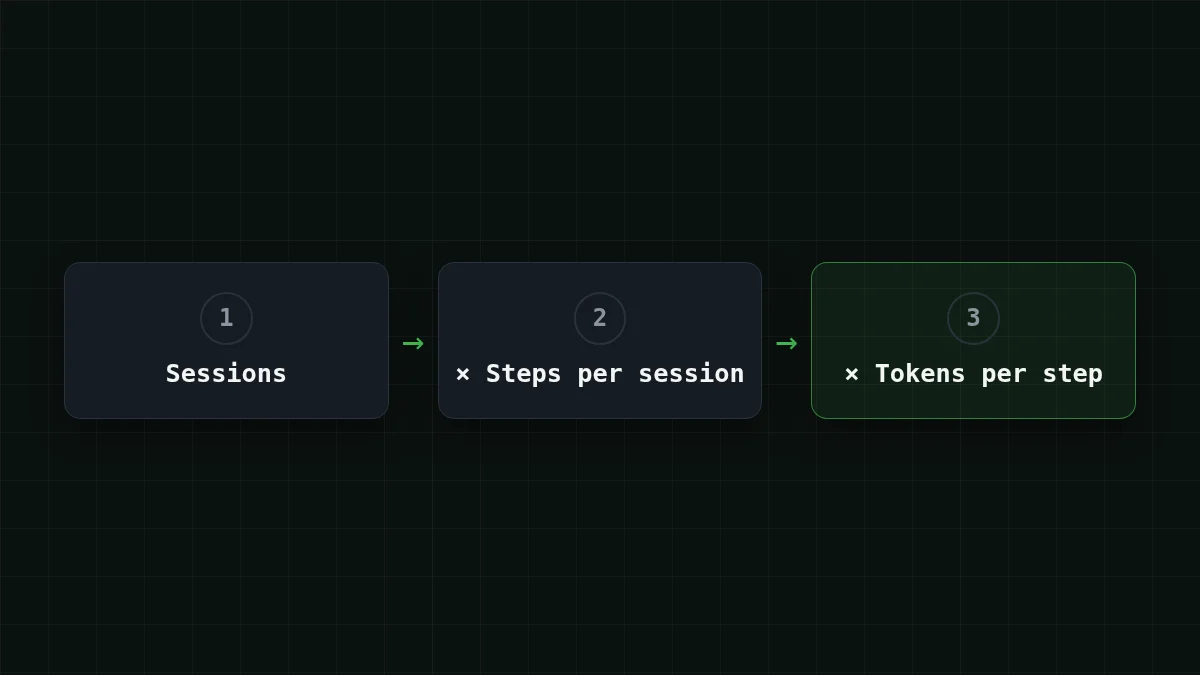
Supposons que vous prévoyiez un projet de la taille de celui de Cognition, 233 sessions, et que vous posiez 60 étapes par session. Ces deux nombres sont des hypothèses de cette page, pas des données de Cognition. Alors :
233 × 60 = 13 980
soit 13 980 appels de modèle. Maintenant, la taille d'un appel. Supposez qu'une étape moyenne envoie 60 000 tokens en entrée (tâche, historique, un ou deux fichiers) et reçoive 1 500 tokens en retour (une commande ou un patch). Totaux :
60 000 × 13 980 = 838 800 000
1 500 × 13 980 = 20 970 000
Soit environ 839 M de tokens d'entrée et 21 M de tokens de sortie. L'entrée représente quarante fois la sortie, et c'est là que se joue votre budget. Sur DeepSeek-V4-Flash, ce projet coûte $14.68, et une session de 60 étapes coûte $0.063. Voici la même charge sur chaque modèle, avec la référence OpenRouter à côté :
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 13 980 requêtes | OpenRouter, 13 980 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0013 | $17.61 | $29.84 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0011 | $14.68 | $61.65 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0032 | $45.09 | $541.03 |
60 000 tokens d'entrée et 1 500 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
Au total, entrée et sortie confondues, chacun de nos modèles revient moins cher qu'OpenRouter pour cette charge. Les prix sont à jour depuis la page de tarifs, donc le tableau évolue avec les tarifs.
Essayez vous-mêmeEssayez : la session de 60 étapes envoie en moyenne 60 000 tokens en entrée. L'étape 1 envoie-t-elle autant que l'étape 60 ?Afficher la réponse
Non. L'étape 1 envoie peu (la tâche et quelques fichiers), l'étape 60 renvoie tout ce qui a été accumulé en chemin. Prendre 60 000 comme moyenne suppose que la session démarre petit et finit près de 100 K ou plus. Si vous savez que vos sessions finissent à, disons, 120 K, la moyenne est d'environ la moitié, donc mesurez la plus grosse requête, pas seulement la moyenne.
Obtenez vos propres chiffres en dix minutes#
Les hypothèses ne sont qu'un point de départ. Lancez une vraie session de votre tâche sur un modèle bon marché et lisez l'objet usage que l'API renvoie à chaque réponse. Les endpoints compatibles OpenAI indiquent prompt_tokens et completion_ par appel :
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "max_tokens": 1500, "messages": [{"role": "user", "content": "Summarize this test failure and propose a fix: ..."}]}'
Additionnez usage sur toute la session, divisez par le nombre d'appels, et remplacez les 60 000 et 1 500 ci-dessus par vos moyennes. Les détails de configuration sont dans la documentation CheapTokens ; le suivi par étape en code est dans suivre le coût en tokens d'un agent IA en Python. Pour le même calcul sur une seule session de 50 étapes, voir coût d'une session agent sur GLM, DeepSeek ou MiniMax.
Pour les longues boucles, DeepSeek-V4-Flash dispose d'une fenêtre de contexte de 380 K et de jusqu'à 32 768 tokens de sortie par réponse, à un prix unique à toute heure. GLM-5.3-Flash a une fenêtre de 390 K et MiniMax-M2.7 de 180 K, vérifiez donc que votre plus grosse requête tient.
Choisissez votre cas
À quel projet ressemble le vôtre ?
Choisissez une option pour voir la réponse
Beaucoup de sessions courtes
Petites tâches, chacune repartant de zéro : l'entrée par appel reste faible. Multipliez sessions par étapes, et attendez-vous à ce que le total soit dominé par le nombre d'appels, pas par leur taille.
Quelques sessions très longues
L'historique grossit au fil de la session, donc les dernières étapes sont les plus coûteuses. Estimez avec la plus grosse requête, découpez le travail en sessions enfants avec un court brief chacune, et l'entrée cesse de boule de neige.
Calcul intensif plus agents
Comme RSA-260 : la tâche elle-même exige du matériel. Chiffrez le matériel à l'heure auprès de votre fournisseur, et gardez la ligne tokens comme une estimation séparée. Elles ne s'additionnent pas de tête, seulement dans un tableur.
Resserez la tâche avant d'augmenter le budget#
Le rapport contient une leçon de plus qui colle à un budget : plus le code s'éloignait de l'amont, plus les agents se perdaient. Des agents perdus font plus d'étapes. Si votre estimation semble trop élevée, réduisez d'abord les étapes par session : un brief plus clair, une zone de code plus petite, des étapes fixes déplacées dans des scripts (voir les agents ont-ils besoin du modèle à chaque étape). Diviser les étapes par deux divise la ligne tokens par deux ; c'est le levier le plus simple dont vous disposez.


