Otimização de custosAnálise
Orce um projeto longo com agentes: computação vs tokens (caso RSA-260)
A manchete de $400k do RSA-260 é aluguel de GPU, não tokens de modelo. Divida um projeto longo com agentes em três linhas de orçamento e dimensione a parte de tokens com sessões × passos × tokens.
Nesta página
Essa cifra de ~$400k da fatoração RSA-260 da Cognition é aluguel de GPU, não uma conta de modelo. O relatório não precifica o lado do agente de forma alguma, então se você planeja um projeto longo com agentes, você mesmo estima a linha de tokens: sessões × passos × tokens por passo, com preços atuais. É isso que o resto desta página faz.
A fonte é o texto da Cognition escrito por Eric Lu, engenheiro da Cognition (Factoring RSA-260, publicado em 9 de setembro de 2026, verificado em 6 de novembro de 2026). Ele está sendo recompartilhado com a cifra em dólares na manchete, e a cifra é fácil de interpretar errado.
O que os $400k realmente pagam#
O autor fatorou um número de 260 dígitos com GNFS, usando um CADO-NFS fortemente modificado que roda em GPUs. O relatório dá o tempo de GPU para cada fase:
- seleção de polinômios: 643 dias de GPU
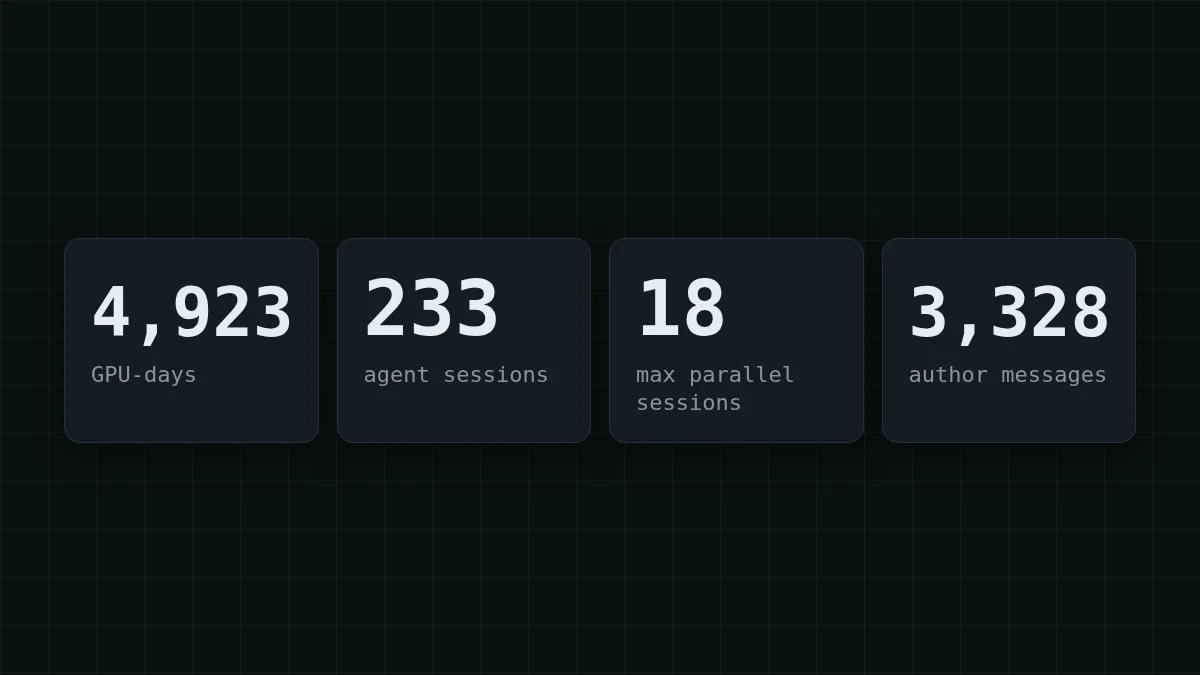
- peneiramento: 3.813 dias de GPU
- resolução do sistema linear: 467 dias de GPU
Isso dá 643 + 3.813 + 467 = 4.923 dias de GPU, que o relatório arredonda para ~4.900. Com o valor assumido no relatório de $3,50 por hora de GPU:
4.923 × 24 × 3,50 = 413.532
Isso bate com a cifra de $414k de GPU no apêndice. Então a manchete é hardware alugado rodando um trabalho de cálculo pesado por semanas. Nenhum token de modelo entra nessa soma.
Verificação rápida
Qual é a cifra de ~$400k no relatório RSA-260?
Mostrar resposta
Resposta: Aluguel de GPUs a preço de mercado para a execução da fatoração
Vem de dias de GPU × $3,50 por hora de GPU. O relatório não nomeia modelos e não dá contagens de tokens para a parte do agente.
O que os agentes fizeram, e o que o relatório não diz#
O lado do agente é descrito por atividade, não por custo. O primeiro prompt saiu em 13 de agosto de 2026, o trabalho levou cerca de três semanas, e os números são:
- 233 sessões do Devin para a fatoração, em média 3 rodando em paralelo e 18 no pico
- 192 delas receberam mensagens do autor, 36 rodaram sem nenhuma intervenção humana
- 101 sessões filhas foram iniciadas por outras sessões
- A contabilidade do próprio Devin: 14.450 ACUs (essa é a unidade do Devin, não tokens)
As sessões cuidaram de medição, operações de cluster, ajuste e depuração. O humano definiu prioridades e construiu os benchmarks. Dois detalhes honestos do autor: a decomposição em torno do CADO-NFS foi projetada por uma pessoa e era essencial, e os agentes ficaram mais confusos quanto mais o código se afastava do upstream.
O que falta é exatamente o que um orçamento precisa: quais modelos, quantos tokens. Então não tente deduzir uma conta de tokens a partir de 14.450 ACUs. Qualquer coisa que você leia online que faça isso é um chute.
A terceira linha: condução humana#
O autor enviou 3.328 mensagens, 82.702 palavras no total. Isso dá 82.702 ÷ 3.328 ≈ 25 palavras por mensagem, cutucadas curtas em vez de ensaios. Essas palavras custam quase nada em tokens. Custam atenção: alguém tem que ler o que os agentes fizeram e decidir o próximo passo. Quando você orça um projeto com agentes, coloque isso em uma linha própria em horas, não em dólares de uso de API.
Então um projeto longo com agentes tem três linhas:
Role a tabela para a direita →
| Linha | No relatório RSA-260 | O que define isso para você |
|---|---|---|
| Computação | ~$414k de tempo de GPU, a $3,50 por hora de GPU | Seu próprio trabalho: builds, testes, treinamento, simulações |
| Tokens de modelo | Não reportado | Sessões × passos × tokens por passo |
| Condução humana | 3.328 mensagens em ~3 semanas | Com que frequência você revisa e redireciona |
Estime sua linha de tokens#
Aqui está a fórmula, e a única coisa que as pessoas esquecem: cada passo reenvia o histórico. Um agente não lembra de uma sessão; cada chamada carrega a tarefa, os arquivos que leu e a saída de ferramentas até agora. É por isso que os tokens de entrada normalmente ofuscam os de saída (mais sobre isso em por que agentes de IA usam tantos tokens).
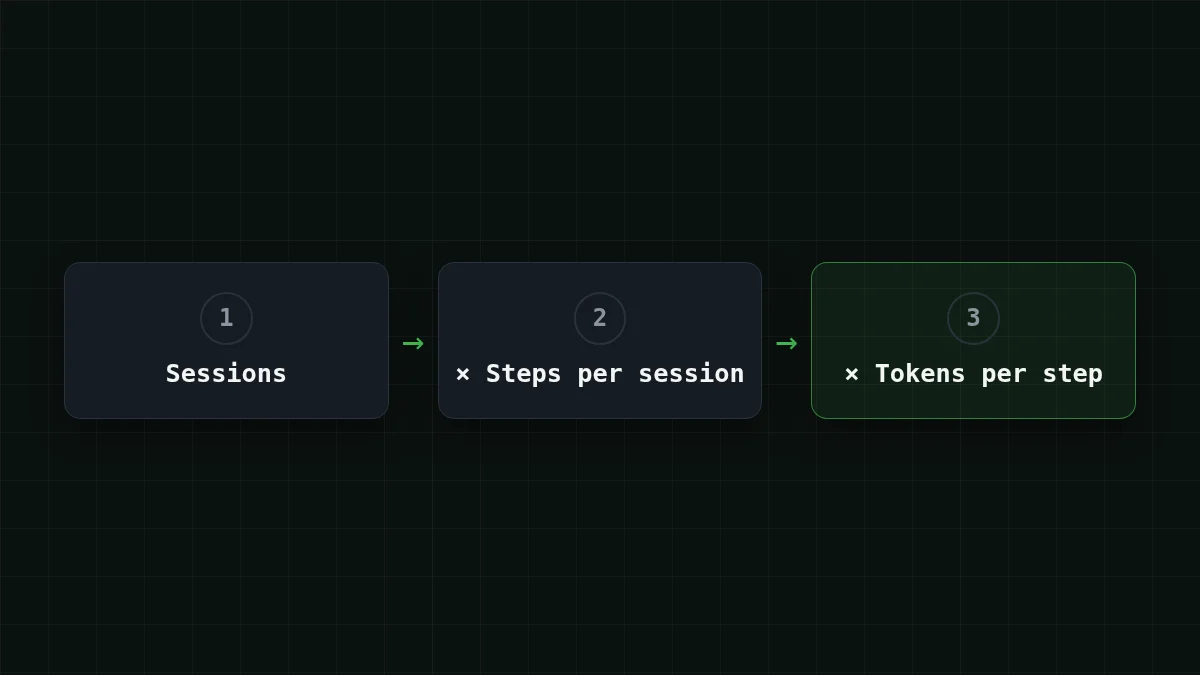
Digamos que você planeje um projeto do tamanho do da Cognition, 233 sessões, e assuma 60 passos por sessão. Esses dois números são suposições desta página, não dados da Cognition. Então:
233 × 60 = 13.980
são 13.980 chamadas de modelo. Agora o tamanho de uma chamada. Suponha que um passo médio envie 60.000 tokens de entrada (tarefa, histórico, um ou dois arquivos) e receba 1.500 tokens de volta (um comando ou um patch). Totais:
60.000 × 13.980 = 838.800.000
1.500 × 13.980 = 20.970.000
Então cerca de 839M tokens de entrada e 21M tokens de saída. A entrada é quarenta vezes a saída, e é desse lado que vive seu orçamento. No DeepSeek-V4-Flash esse projeto custa $14.68, e uma sessão de 60 passos custa $0.063. Aqui está a mesma carga em todos os modelos, com a referência do OpenRouter ao lado:
| Modelo | Entrada $/1M | Saída $/1M | Por solicitação | 13.980 solicitações | OpenRouter, 13.980 solicitações |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0013 | $17.61 | $29.84 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0011 | $14.68 | $61.65 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0032 | $45.09 | $541.03 |
60.000 tokens de entrada e 1.500 tokens de saída por solicitação. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
Contado no total, com entrada e saída juntas, cada um dos nossos modelos sai mais barato que o OpenRouter para essa carga. Os preços são ao vivo da página de preços, então a tabela muda quando as tarifas mudam.
Experimente você mesmoTeste: a sessão de 60 passos tem média de 60.000 tokens de entrada. O passo 1 envia tanto quanto o passo 60?Mostrar resposta
Não. O passo 1 envia pouco (a tarefa e alguns arquivos), o passo 60 reenvia tudo o que foi acumulado no caminho. Tomar 60.000 como média assume que a sessão começa pequena e termina perto de 100K ou mais. Se você sabe que suas sessões terminam em, digamos, 120K, a média é cerca de metade disso, então meça a maior requisição, não apenas a média.
Obtenha seus próprios números em dez minutos#
Suposições são apenas um ponto de partida. Rode uma sessão real da sua tarefa em um modelo barato e leia o objeto usage que a API retorna em cada resposta. Endpoints compatíveis com OpenAI reportam prompt_tokens e completion_ por chamada:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "max_tokens": 1500, "messages": [{"role": "user", "content": "Summarize this test failure and propose a fix: ..."}]}'
Some usage ao longo da sessão inteira, divida pelo número de chamadas e substitua os 60.000 e 1.500 acima pelas suas médias. Detalhes de configuração estão na documentação do CheapTokens; o rastreamento por passo em código está em rastrear o custo de tokens de agentes de IA em Python. Para a mesma aritmética em uma única sessão de 50 passos, veja custo de sessão de agente no GLM, DeepSeek ou MiniMax.
Para loops longos, o DeepSeek-V4-Flash tem janela de contexto de 380K e até 32.768 tokens de saída por resposta, com um preço a qualquer hora. O GLM-5.3-Flash tem janela de 390K e o MiniMax-M2.7 tem 180K, então verifique se sua maior requisição cabe.
Escolha o seu caso
Qual projeto se parece com o seu?
Escolha uma opção para ver a resposta
Muitas sessões curtas
Tarefas pequenas, cada uma começando do zero: a entrada por chamada fica baixa. Multiplique sessões por passos, e espere que o total seja dominado pela contagem de chamadas, não pelo tamanho delas.
Poucas sessões muito longas
O histórico cresce ao longo da sessão, então os últimos passos são os caros. Estime com a maior requisição, divida o trabalho em sessões filhas com um briefing curto cada, e a entrada para de crescer em bola de neve.
Computação pesada mais agentes
Como o RSA-260: o trabalho em si precisa de hardware. Precifique o hardware por hora com seu provedor e mantenha a linha de tokens como uma estimativa separada. Elas não se somam na sua cabeça, só numa planilha.
Reduza a tarefa antes de aumentar o orçamento#
O relatório tem mais uma lição que se encaixa num orçamento: quanto mais o código se afastava do upstream, mais confusos os agentes ficavam. Agentes confusos dão mais passos. Se sua estimativa parecer alta demais, reduza primeiro os passos por sessão: um briefing mais claro, uma área menor de código, passos fixos movidos para scripts (veja agentes precisam do modelo em cada passo). Reduzir os passos pela metade reduz a linha de tokens pela metade; essa é a alavanca mais fácil que você tem.


