Optymalizacja kosztówAnaliza
Budżet długiego projektu agentowego: obliczenia a tokeny (przypadek RSA-260)
Nagłówek o 400 tys. dolarów w RSA-260 to wynajem GPU, a nie tokeny modelu. Podziel długi projekt agentowy na trzy linie budżetu i oszacuj część tokenową jako sesje × kroki × tokeny.
Na tej stronie
Ta liczba ~400 tys. dolarów z fakturacji RSA-260 przez Cognition to wynajem GPU, a nie rachunek za model. Raport w ogóle nie wycenia strony agentowej, więc jeśli planujesz długi projekt agentowy, sam oszacujesz linię tokenów: sesje × kroki × tokeny na krok, na podstawie aktualnych cen. Właśnie to robi reszta tej strony.
Źródłem jest artykuł Cognition autorstwa Erica Lu, inżyniera w Cognition (Factoring RSA-260, opublikowany 9 września 2026, sprawdzony 6 listopada 2026). Jest on ponownie udostępniany z kwotą w nagłówku, a tę kwotę łatwo błędnie odczytać.
Za co faktycznie płaci te 400 tys. dolarów#
Autor rozłożył liczbę 260-cyfrową metodą GNFS, używając mocno zmodyfikowanego CADO-NFS działającego na GPU. Raport podaje czas GPU dla każdej fazy:
- wybór wielomianu: 643 dni GPU
- przesiewanie: 3813 dni GPU
- rozwiązywanie układu liniowego: 467 dni GPU
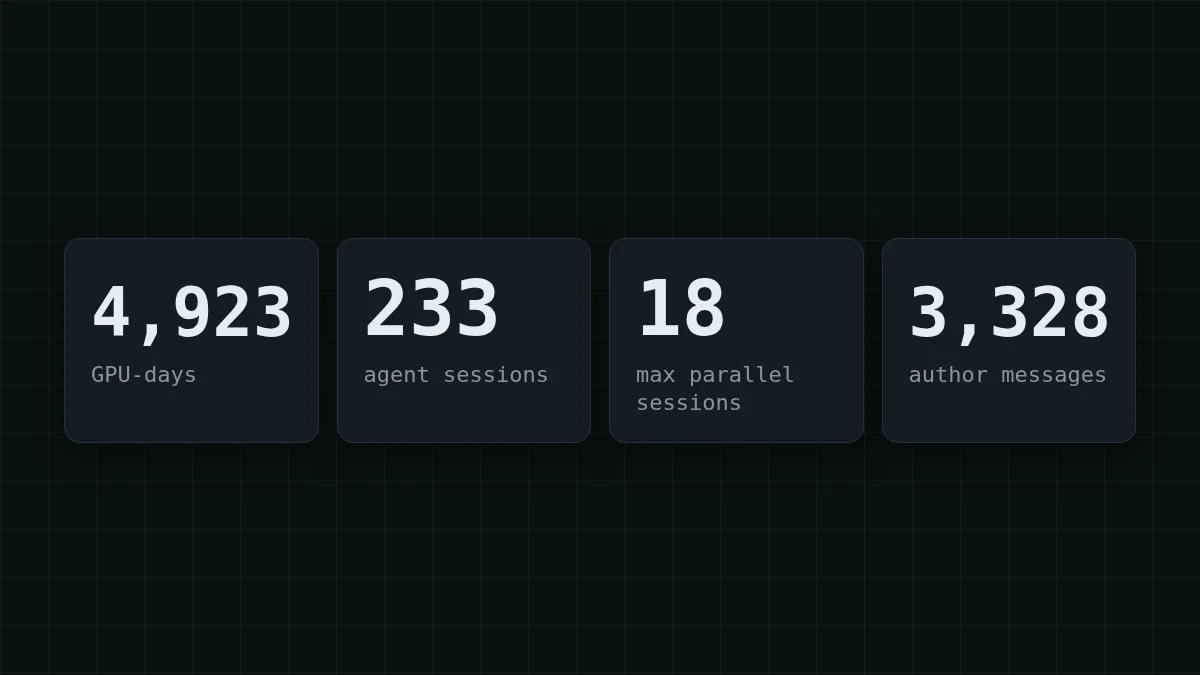
To daje 643 + 3813 + 467 = 4923 dni GPU, które raport zaokrągla do ~4900. Przy założonej w raporcie stawce 3,50 USD za godzinę GPU:
4923 × 24 × 3,50 = 413 532
To zgadza się z kwotą 414 tys. dolarów za GPU w jego aneksie. Nagłówek dotyczy więc wynajętego sprzętu wykonującego obliczenia przez tygodnie. W tej sumie nie ma żadnych tokenów modelu.
Szybkie sprawdzenie
Czym jest kwota ~400 tys. dolarów w raporcie o RSA-260?
Pokaż odpowiedź
Odpowiedź: Rynkowy wynajem GPU na potrzeby fakturacji
Wynika ona z dni GPU × 3,50 USD za godzinę GPU. Raport nie wymienia żadnych modeli ani nie podaje liczby tokenów dla części agentowej.
Co robili agenci i czego raport nie mówi#
Strona agentowa jest opisana przez aktywność, a nie przez koszt. Pierwszy prompt wysłano 13 sierpnia 2026, praca zajęła około trzech tygodni, a liczby są następujące:
- 233 sesje Devin na potrzeby fakturacji, średnio 3 działające równolegle i 18 w szczycie
- 192 z nich otrzymały wiadomości od autora, 36 działało całkowicie bez interwencji człowieka
- 101 sesji potomnych zostało uruchomionych przez inne sesje
- własna ewidencja Devin: 14 450 ACU (to jednostka Devin, nie tokeny)
Sesje zajmowały się pomiarami, operacjami klastra, dostrajaniem i debugowaniem. Człowiek ustalał priorytety i budował benchmarki. Dwa uczciwe szczegóły od autora: dekompozycja wokół CADO-NFS została zaprojektowana przez człowieka i była kluczowa, a agenci gubili się tym bardziej, im dalej kod odchodził od wersji upstream.
Brakuje dokładnie tego, czego potrzebuje budżet: jakie modele, ile tokenów. Nie próbuj więc wyliczać rachunku za tokeny z 14 450 ACU. Wszystko, co przeczytasz w internecie, że to robi, jest zgadywaniem.
Trzecia linia: sterowanie przez człowieka#
Autor wysłał 3328 wiadomości, łącznie 82 702 słowa. To daje 82 702 ÷ 3328 ≈ 25 słów na wiadomość, krótkie podpowiedzi, a nie eseje. Te słowa kosztują w tokenach prawie nic. Kosztują uwagę: ktoś musi przeczytać, co zrobili agenci, i zdecydować, co dalej. Planując budżet projektu agentowego, umieść to w osobnej linii w godzinach, a nie w dolarach za użycie API.
Długi projekt agentowy ma więc trzy linie:
Przewiń tabelę w prawo →
| Linia | W raporcie o RSA-260 | Co ją u ciebie określa |
|---|---|---|
| Obliczenia | ~414 tys. dolarów czasu GPU, po 3,50 USD za godzinę GPU | Samo twoje zadanie: buildy, testy, trening, symulacje |
| Tokeny modelu | Nie podano | Sesje × kroki × tokeny na krok |
| Sterowanie przez człowieka | 3328 wiadomości w ~3 tygodnie | Jak często przeglądasz i przekierowujesz |
Oszacuj swoją linię tokenów#
Oto wzór i jedna rzecz, o której ludzie zapominają: każdy krok ponownie wysyła historię. Agent nie pamięta sesji; każde wywołanie niesie zadanie, przeczytane pliki i dotychczasowe wyjście narzędzi. Dlatego tokeny wejściowe zwykle znacznie przewyższają tokeny wyjściowe (więcej na ten temat w dlaczego agenci AI zużywają tak wiele tokenów).
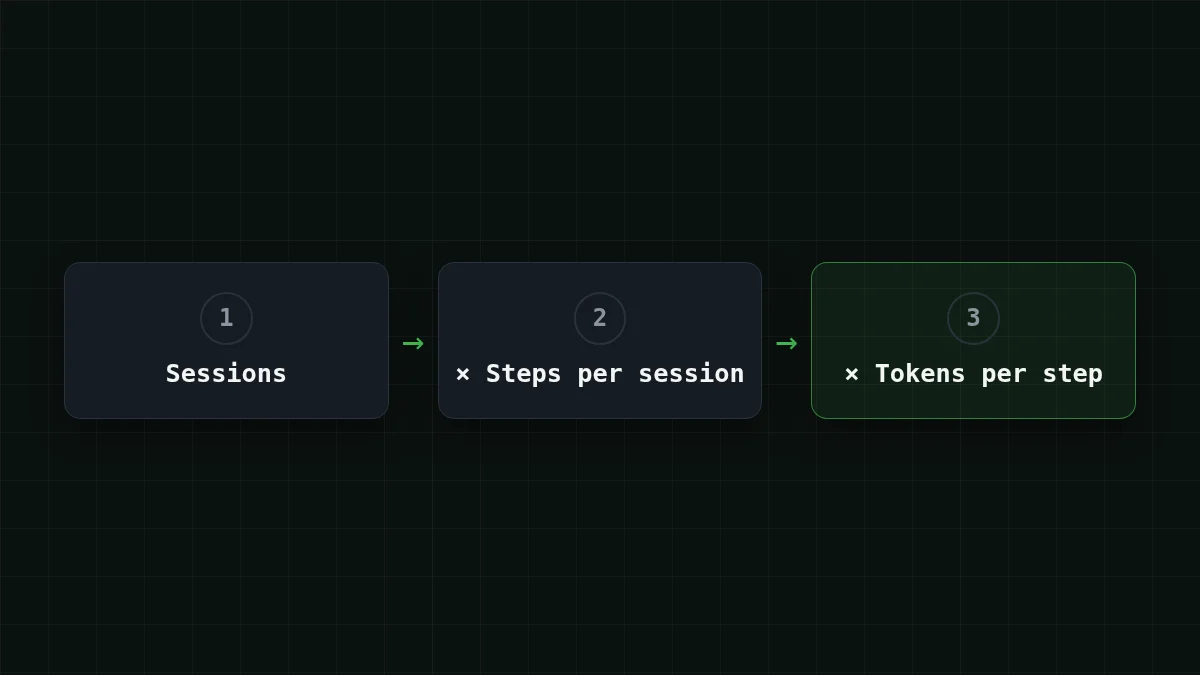
Załóżmy, że planujesz projekt wielkości tego Cognition, 233 sesje, i przyjmujesz 60 kroków na sesję. Te dwie liczby to założenia tej strony, a nie dane Cognition. Wtedy:
233 × 60 = 13 980
to 13 980 wywołań modelu. Teraz rozmiar jednego wywołania. Załóżmy, że przeciętny krok wysyła 60 000 tokenów wejściowych (zadanie, historia, plik lub dwa) i otrzymuje 1500 tokenów wyjściowych (polecenie lub patch). Sumy:
60 000 × 13 980 = 838 800 000
1500 × 13 980 = 20 970 000
Czyli około 839 mln tokenów wejściowych i 21 mln tokenów wyjściowych. Wejście to czterdzieści razy więcej niż wyjście i to po tej stronie leży twój budżet. Na DeepSeek-V4-Flash ten projekt kosztuje $14.68, a jedna sesja 60 kroków to $0.063. Oto to samo obciążenie na każdym modelu, z odniesieniem do OpenRouter obok:
| Model | Wejście $/1M | Wyjście $/1M | Za żądanie | 13 980 żądań | OpenRouter, 13 980 żądań |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0013 | $17.61 | $29.84 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0011 | $14.68 | $61.65 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0032 | $45.09 | $541.03 |
60 000 tokenów wejściowych i 1500 tokenów wyjściowych na żądanie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
Liczone łącznie, z wejściem i wyjściem razem, każdy z naszych modeli wypada taniej niż OpenRouter przy tym obciążeniu. Ceny są aktualne z strony cennika, więc tabela zmienia się wraz z taryfami.
Spróbuj samSprawdź: sesja 60 kroków średnio wysyła 60 000 tokenów wejściowych. Czy krok 1 wysyła tyle samo co krok 60?Pokaż odpowiedź
Nie. Krok 1 wysyła niewiele (zadanie i kilka plików), krok 60 ponownie wysyła wszystko zebrane po drodze. Przyjęcie 60 000 jako średniej zakłada, że sesja zaczyna się mała i kończy blisko 100 tys. lub więcej. Jeśli wiesz, że twoje sesje kończą się na przykład na 120 tys., średnia wynosi około połowy tego, więc mierz największe żądanie, a nie tylko średnią.
Zdobądź własne liczby w dziesięć minut#
Założenia to tylko punkt wyjścia. Uruchom jedną prawdziwą sesję swojego zadania na tanim modelu i odczytaj obiekt usage, który API zwraca przy każdej odpowiedzi. Endpointy zgodne z OpenAI podają prompt_tokens i completion_ na wywołanie:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "max_tokens": 1500, "messages": [{"role": "user", "content": "Summarize this test failure and propose a fix: ..."}]}'
Zsumuj usage w całej sesji, podziel przez liczbę wywołań i zastąp powyższe 60 000 i 1500 swoimi średnimi. Szczegóły konfiguracji są w dokumentacji CheapTokens; śledzenie kosztów na krok w kodzie jest w track AI agent token cost in Python. Tę samą arytmetykę dla jednej sesji 50 kroków znajdziesz w agent session cost on GLM, DeepSeek or MiniMax.
W przypadku długich pętli DeepSeek-V4-Flash ma okno kontekstu 380 tys. i do 32 768 tokenów wyjściowych na odpowiedź, w jednej cenie o każdej porze. GLM-5.3-Flash ma okno 390 tys., a MiniMax-M2.7 ma 180 tys., więc sprawdź, czy twoje największe żądanie się mieści.
Wybierz swój przypadek
Który projekt wygląda jak twój?
Wybierz opcję, aby zobaczyć odpowiedź
Wiele krótkich sesji
Małe zadania, każde zaczynane od zera: wejście na wywołanie pozostaje niskie. Pomnóż sesje przez kroki i oczekuj, że sumę zdominuje liczba wywołań, a nie ich rozmiar.
Kilka bardzo długich sesji
Historia rośnie w trakcie sesji, więc ostatnie kroki są najdroższe. Szacuj na podstawie największego żądania, podziel pracę na sesje potomne z krótkim briefem, a wejście przestanie narastać jak kula śnieżna.
Ciężkie obliczenia plus agenci
Jak w RSA-260: samo zadanie wymaga sprzętu. Wyceń sprzęt za godzinę u swojego dostawcy i trzymaj linię tokenów jako osobne oszacowanie. Nie sumują się w głowie, tylko w arkuszu kalkulacyjnym.
Zawęź zadanie, zanim podniesiesz budżet#
Raport zawiera jeszcze jedną lekcję pasującą do budżetu: im dalej kod odchodził od wersji upstream, tym bardziej agenci się gubili. Zdezorientowani agenci wykonują więcej kroków. Jeśli twoje oszacowanie wygląda na zbyt wysokie, najpierw zmniejsz liczbę kroków na sesję: jaśniejszy brief, mniejszy obszar kodu, stałe kroki przeniesione do skryptów (zobacz czy agenci potrzebują modelu na każdym kroku). Zmniejszenie liczby kroków o połowę zmniejsza linię tokenów o połowę; to najłatwiejsza dźwignia, jaką masz.


