Optimización de costosAnálisis
Presupuesta un proyecto de agente largo: cómputo vs tokens (caso RSA-260)
El titular de los $400k de RSA-260 es alquiler de GPU, no tokens de modelo. Divide un proyecto de agente largo en tres líneas de presupuesto y dimensiona la parte de tokens con sesiones × pasos × tokens.
En esta página
Esa cifra de ~$400k de la factorización RSA-260 de Cognition es alquiler de GPU, no una factura de modelo. El informe no valoriza en absoluto el lado del agente, así que si planeas un proyecto de agente largo, estimas tú mismo la línea de tokens: sesiones × pasos × tokens por paso, con precios en vivo. Eso es lo que hace el resto de esta página.
La fuente es el artículo de Cognition de Eric Lu, ingeniero en Cognition (Factoring RSA-260, publicado el 9 de septiembre de 2026, consultado el 6 de noviembre de 2026). Se está volviendo a compartir con la cifra en dólares en el titular, y la cifra es fácil de malinterpretar.
Qué paga realmente los $400k#
El autor factorizó un número de 260 dígitos con GNFS, usando un CADO-NFS muy modificado que se ejecuta en GPUs. El informe da el tiempo de GPU de cada fase:
- selección de polinomios: 643 días-GPU
- cribado: 3.813 días-GPU
- resolución del sistema lineal: 467 días-GPU
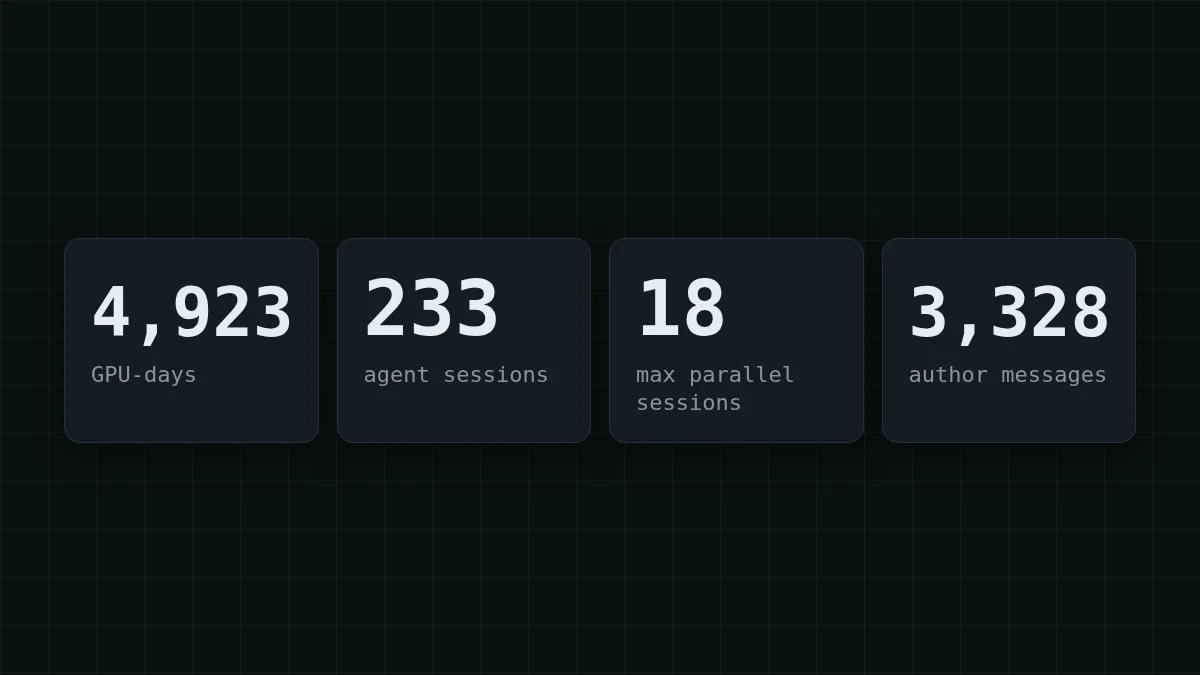
Eso son 643 + 3.813 + 467 = 4.923 días-GPU, que el informe redondea a ~4.900. Al precio asumido en el informe de $3,50 por hora-GPU:
4.923 × 24 × 3,50 = 413.532
Eso coincide con la cifra de $414k de GPU de su apéndice. Así que el titular es hardware alquilado ejecutando un trabajo de cálculo numérico durante semanas. No hay tokens de modelo en esa suma.
Verificación rápida
¿Qué es la cifra de ~$400k en el informe RSA-260?
Mostrar respuesta
Respuesta: Alquiler de GPUs a precio de mercado para la ejecución de factorización
Sale de días-GPU × $3,50 por hora-GPU. El informe no nombra modelos ni da recuentos de tokens para la parte del agente.
Qué hicieron los agentes, y qué no dice el informe#
El lado del agente se describe por actividad, no por coste. El primer prompt salió el 13 de agosto de 2026, el trabajo llevó unas tres semanas, y las cifras son:
- 233 sesiones de Devin para la factorización, de media 3 ejecutándose en paralelo y 18 en el pico
- 192 de ellas recibieron mensajes del autor, 36 se ejecutaron sin ninguna intervención humana
- 101 sesiones hijas fueron iniciadas por otras sesiones
- La propia contabilidad de Devin: 14.450 ACUs (esa es la unidad de Devin, no tokens)
Las sesiones se encargaron de medición, operaciones de clúster, ajuste y depuración. El humano fijó prioridades y construyó los benchmarks. Dos detalles honestos del autor: la descomposición en torno a CADO-NFS la diseñó una persona y fue esencial, y los agentes se confundían más cuanto más se alejaba el código del upstream.
Lo que falta es exactamente lo que necesita un presupuesto: qué modelos, cuántos tokens. Así que no intentes deducir una factura de tokens a partir de 14.450 ACUs. Cualquier cosa que leas en internet que lo haga es una suposición.
La tercera línea: dirección humana#
El autor envió 3.328 mensajes, 82.702 palabras en total. Eso son 82.702 ÷ 3.328 ≈ 25 palabras por mensaje, empujones cortos más que ensayos. Esas palabras cuestan casi nada en tokens. Cuestan atención: alguien tiene que leer lo que hicieron los agentes y decidir qué viene después. Cuando presupuestes un proyecto de agente, pon eso en su propia línea en horas, no en dólares de uso de API.
Así que un proyecto de agente largo tiene tres líneas:
Desplaza la tabla hacia la derecha →
| Línea | En el informe RSA-260 | Qué la determina en tu caso |
|---|---|---|
| Cómputo | ~$414k de tiempo de GPU, a $3,50 por hora-GPU | Tu propio trabajo: builds, tests, entrenamiento, simulaciones |
| Tokens de modelo | No reportado | Sesiones × pasos × tokens por paso |
| Dirección humana | 3.328 mensajes en ~3 semanas | Con qué frecuencia revisas y rediriges |
Estima tu línea de tokens#
Aquí está la fórmula, y lo que la gente olvida: cada paso reenvía el historial. Un agente no recuerda una sesión; cada llamada lleva la tarea, los archivos que leyó y la salida de herramientas hasta el momento. Por eso los tokens de entrada suelen empequeñecer a los de salida (más sobre esto en por qué los agentes de IA usan tantos tokens).
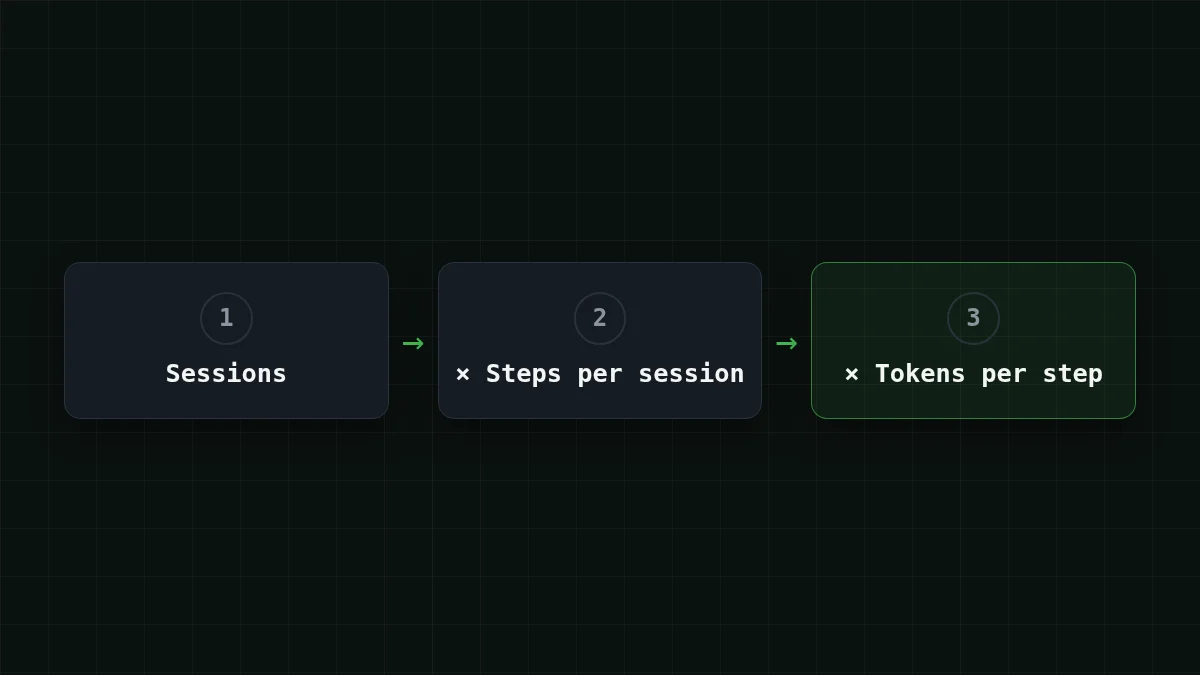
Supón que planeas un proyecto del tamaño del de Cognition, 233 sesiones, y asumes 60 pasos por sesión. Estos dos números son suposiciones de esta página, no datos de Cognition. Entonces:
233 × 60 = 13.980
eso son 13.980 llamadas al modelo. Ahora el tamaño de una llamada. Supón que un paso medio envía 60.000 tokens de entrada (tarea, historial, un archivo o dos) y recibe 1.500 tokens de vuelta (un comando o un parche). Totales:
60.000 × 13.980 = 838.800.000
1.500 × 13.980 = 20.970.000
Así que unos 839M de tokens de entrada y 21M de tokens de salida. La entrada es cuarenta veces la salida, y ese es el lado donde vive tu presupuesto. En DeepSeek-V4-Flash ese proyecto cuesta $14.68, y una sesión de 60 pasos es $0.063. Aquí está la misma carga en cada modelo, con la referencia de OpenRouter al lado:
| Modelo | Entrada $/1M | Salida $/1M | Por solicitud | 13.980 solicitudes | OpenRouter, 13.980 solicitudes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0013 | $17.61 | $29.84 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0011 | $14.68 | $61.65 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0032 | $45.09 | $541.03 |
60.000 tokens de entrada y 1500 tokens de salida por solicitud. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
Contado en total, con entrada y salida juntas, cada uno de nuestros modelos sale más barato que OpenRouter para esta carga. Los precios son en vivo de la página de precios, así que la tabla se mueve cuando lo hacen las tarifas.
Pruébalo tú mismoPruébalo: la sesión de 60 pasos promedia 60.000 tokens de entrada. ¿El paso 1 envía tanto como el paso 60?Mostrar respuesta
No. El paso 1 envía poco (la tarea y unos pocos archivos), el paso 60 reenvía todo lo acumulado por el camino. Tomar 60.000 como media asume que la sesión empieza pequeña y termina cerca de 100K o más. Si sabes que tus sesiones terminan en, digamos, 120K, la media es aproximadamente la mitad de eso, así que mide la petición más grande, no solo la media.
Obtén tus propios números en diez minutos#
Las suposiciones son solo un punto de partida. Ejecuta una sesión real de tu tarea en un modelo barato y lee el objeto usage que la API devuelve en cada respuesta. Los endpoints compatibles con OpenAI reportan prompt_tokens y completion_ por llamada:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "max_tokens": 1500, "messages": [{"role": "user", "content": "Summarize this test failure and propose a fix: ..."}]}'
Suma usage en toda la sesión, divide por el número de llamadas, y sustituye los 60.000 y 1.500 de arriba por tus medias. Los detalles de configuración están en la documentación de CheapTokens; el seguimiento por paso en código está en rastrear el coste de tokens de un agente de IA en Python. Para la misma aritmética en una sola sesión de 50 pasos, consulta coste de sesión de agente en GLM, DeepSeek o MiniMax.
Para bucles largos, DeepSeek-V4-Flash tiene una ventana de contexto de 380K y hasta 32.768 tokens de salida por respuesta, con un único precio a cualquier hora. GLM-5.3-Flash tiene una ventana de 390K y MiniMax-M2.7 tiene 180K, así que comprueba que tu petición más grande cabe.
Elige tu caso
¿A qué proyecto se parece el tuyo?
Elige una opción para ver la respuesta
Muchas sesiones cortas
Tareas pequeñas, cada una empezando de cero: la entrada por llamada se mantiene baja. Multiplica sesiones por pasos, y espera que el total esté dominado por el número de llamadas, no por su tamaño.
Pocas sesiones muy largas
El historial crece a lo largo de la sesión, así que los últimos pasos son los caros. Estima con la petición más grande, divide el trabajo en sesiones hijas con un brief corto cada una, y la entrada deja de hacer bola de nieve.
Cómputo pesado más agentes
Como RSA-260: el trabajo en sí necesita hardware. Valora el hardware por hora según tu proveedor, y mantén la línea de tokens como una estimación aparte. No se suman en tu cabeza, solo en una hoja de cálculo.
Acota la tarea antes de subir el presupuesto#
El informe tiene una lección más que encaja con un presupuesto: cuanto más se alejaba el código del upstream, más se confundían los agentes. Los agentes confundidos dan más pasos. Si tu estimación parece demasiado alta, reduce primero los pasos por sesión: un brief más claro, un área de código más pequeña, pasos fijos movidos a scripts (consulta ¿necesitan los agentes el modelo en cada paso?). Reducir los pasos a la mitad reduce a la mitad la línea de tokens; esa es la palanca más fácil que tienes.


