Ottimizzazione dei costiAnalisi
Preventivare un progetto agente lungo: calcolo vs token (caso RSA-260)
Il titolo da $400k dell'RSA-260 è noleggio di GPU, non token di modello. Suddividi un progetto agente lungo in tre voci di budget e dimensiona la parte token con sessioni × passi × token.
In questa pagina
Quel dato di ~$400k dell'RSA-260 di Cognition è il noleggio delle GPU, non una bolletta del modello. Il report non quantifica affatto il lato agente, quindi se pianifichi un progetto agente di lungo periodo, la voce token te la stimi da solo: sessioni × passi × token per passo, sui prezzi correnti. È quello che fa il resto di questa pagina.
La fonte è il write-up di Cognition a cura di Eric Lu, un ingegnere di Cognition (Factoring RSA-260, pubblicato il 9 settembre 2026, verificato il 6 novembre 2026). Viene ricondiviso con la cifra in dollari nel titolo, e la cifra è facile da fraintendere.
Cosa paga davvero quel $400k#
L'autore ha fattorizzato un numero di 260 cifre con GNFS, usando un CADO-NFS pesantemente modificato che gira su GPU. Il report riporta il tempo GPU per ogni fase:
- selezione del polinomio: 643 GPU-giorni
- setacciatura: 3.813 GPU-giorni
- risoluzione del sistema lineare: 467 GPU-giorni
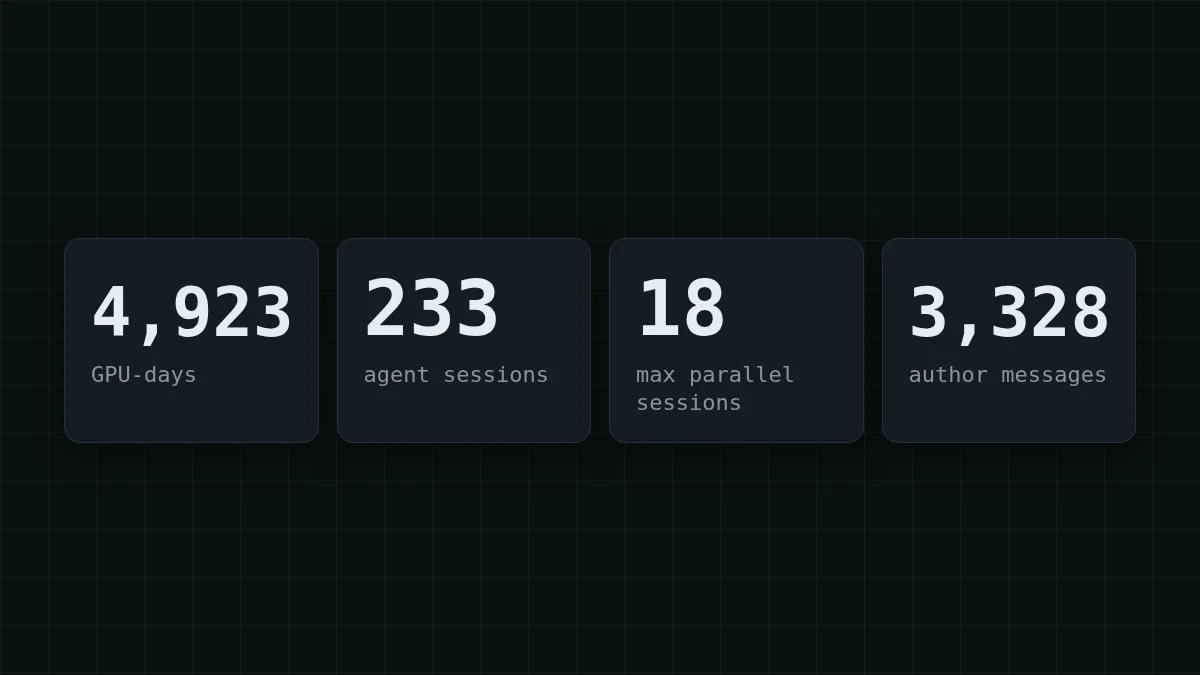
Sono 643 + 3.813 + 467 = 4.923 GPU-giorni, che il report arrotonda a ~4.900. Ai $3,50 per GPU-ora ipotizzati nel report:
4.923 × 24 × 3,50 = 413.532
Corrisponde alla cifra GPU di $414k nell'appendice. Quindi il titolo è hardware noleggiato che esegue un lavoro di calcolo numerico per settimane. In quella somma non ci sono token di modello.
Verifica rapida
A cosa corrisponde la cifra di ~$400k nel report RSA-260?
Mostra risposta
Risposta: Noleggio delle GPU a prezzo di mercato per l'esecuzione della fattorizzazione
Deriva da GPU-giorni × $3,50 per GPU-ora. Il report non nomina modelli e non fornisce conteggi di token per la parte agente.
Cosa hanno fatto gli agenti, e cosa il report non dice#
Il lato agente è descritto per attività, non per costo. Il primo prompt è partito il 13 agosto 2026, il lavoro è durato circa tre settimane, e i numeri sono:
- 233 sessioni Devin per la fattorizzazione, in media 3 in esecuzione in parallelo e 18 al picco
- 192 di esse hanno ricevuto messaggi dall'autore, 36 hanno girato senza alcun intervento umano
- 101 sessioni figlie sono state avviate da altre sessioni
- la contabilità di Devin: 14.450 ACU (è l'unità di Devin, non token)
Le sessioni hanno gestito misurazioni, operazioni sul cluster, tuning e debugging. L'umano ha fissato le priorità e costruito i benchmark. Due dettagli onesti dall'autore: la decomposizione attorno a CADO-NFS è stata progettata da una persona ed era essenziale, e gli agenti diventavano più confusi quanto più il codice si allontanava dall'upstream.
Manca esattamente ciò che serve a un budget: quali modelli, quanti token. Quindi non provare a ricavare una bolletta token dai 14.450 ACU. Qualsiasi cosa leggi online che lo faccia è una congettura.
La terza voce: la guida umana#
L'autore ha inviato 3.328 messaggi, 82.702 parole in totale. Sono 82.702 ÷ 3.328 ≈ 25 parole per messaggio, brevi sollecitazioni più che saggi. Quelle parole costano quasi nulla in token. Costano attenzione: qualcuno deve leggere cosa hanno fatto gli agenti e decidere il passo successivo. Quando preventivi un progetto agente, metti quella voce su una riga a sé in ore, non in dollari di utilizzo API.
Quindi un progetto agente di lungo periodo ha tre voci:
Scorri la tabella verso destra →
| Voce | Nel report RSA-260 | Cosa la determina per te |
|---|---|---|
| Calcolo | ~$414k di tempo GPU, a $3,50 per GPU-ora | Il tuo lavoro stesso: build, test, training, simulazioni |
| Token di modello | Non riportati | Sessioni × passi × token per passo |
| Guida umana | 3.328 messaggi in ~3 settimane | Quanto spesso rivedi e ridirigi |
Stima la tua voce token#
Ecco la formula, e la cosa che tutti dimenticano: ogni passo reinvia la cronologia. Un agente non ricorda una sessione; ogni chiamata porta con sé il task, i file letti e l'output degli strumenti fino a quel momento. Ecco perché i token di input di solito sovrastano quelli di output (ne parliamo in perché gli agenti AI usano così tanti token).
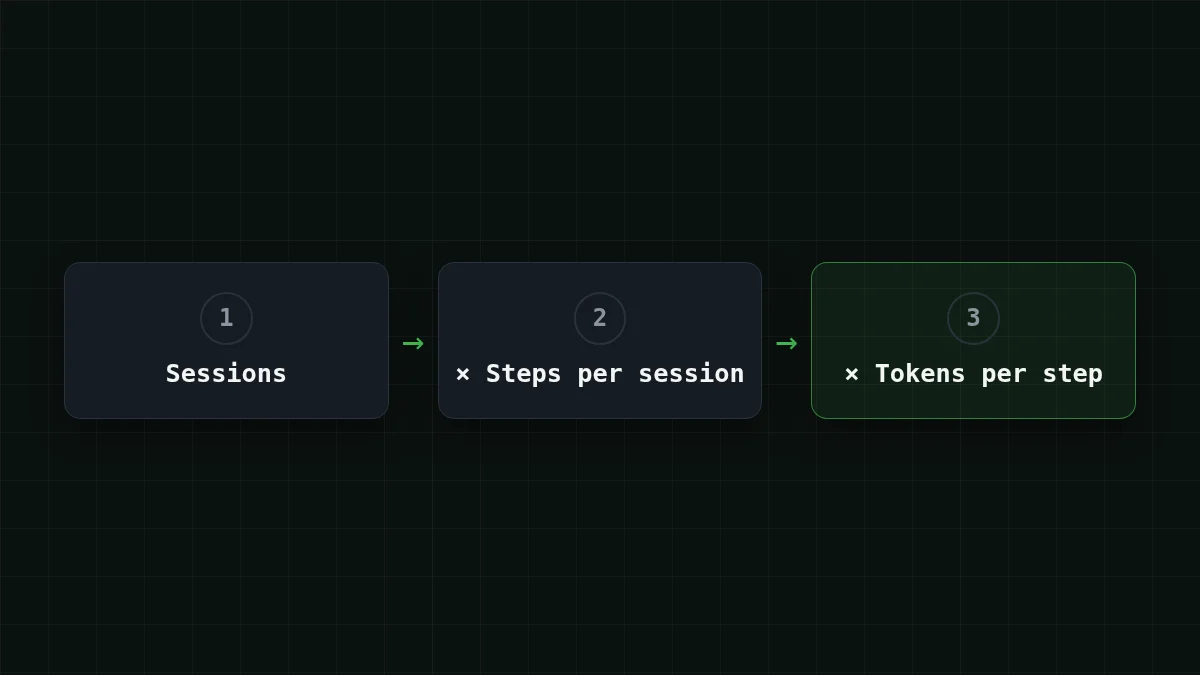
Supponi di pianificare un progetto delle dimensioni di quello di Cognition, 233 sessioni, e di ipotizzare 60 passi per sessione. Questi due numeri sono ipotesi di questa pagina, non dati di Cognition. Allora:
233 × 60 = 13.980
cioè 13.980 chiamate al modello. Ora la dimensione di una chiamata. Supponi che un passo medio invii 60.000 token in input (task, cronologia, un file o due) e riceva 1.500 token in output (un comando o una patch). Totali:
60.000 × 13.980 = 838.800.000
1.500 × 13.980 = 20.970.000
Quindi circa 839M token di input e 21M token di output. L'input è quaranta volte l'output, ed è il lato dove vive il tuo budget. Su DeepSeek-V4-Flash quel progetto costa $14.68, e una sessione di 60 passi costa $0.063. Ecco lo stesso carico su ogni modello, con il riferimento OpenRouter accanto:
| Modello | Input $/1M | Output $/1M | Per richiesta | 13.980 richieste | OpenRouter, 13.980 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0013 | $17.61 | $29.84 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0011 | $14.68 | $61.65 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0032 | $45.09 | $541.03 |
60.000 token di input e 1500 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
Considerando il totale, input e output insieme, ciascuno dei nostri modelli risulta più economico di OpenRouter per questo carico. I prezzi sono aggiornati da la pagina dei prezzi, quindi la tabella si muove quando cambiano le tariffe.
Provalo tu stessoProva: la sessione di 60 passi ha in media 60.000 token in input. Il passo 1 invia tanto quanto il passo 60?Mostra risposta
No. Il passo 1 invia poco (il task e qualche file), il passo 60 reinvia tutto ciò che è stato raccolto lungo il percorso. Prendere 60.000 come media presuppone che la sessione parta piccola e finisca vicino a 100K o più. Se sai che le tue sessioni finiscono a, diciamo, 120K, la media è circa la metà, quindi misura la richiesta più grande, non solo la media.
Ottieni i tuoi numeri in dieci minuti#
Le ipotesi sono solo un punto di partenza. Esegui una sessione reale del tuo task su un modello economico e leggi l'oggetto usage che l'API restituisce a ogni risposta. Gli endpoint compatibili con OpenAI riportano prompt_tokens e completion_ per chiamata:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "max_tokens": 1500, "messages": [{"role": "user", "content": "Summarize this test failure and propose a fix: ..."}]}'
Somma usage su tutta la sessione, dividi per il numero di chiamate e sostituisci i 60.000 e 1.500 qui sopra con le tue medie. I dettagli di configurazione sono nella documentazione di CheapTokens; il tracciamento per passo nel codice è in tracciare il costo in token di un agente AI in Python. Per la stessa aritmetica su una singola sessione di 50 passi, vedi costo di una sessione agente su GLM, DeepSeek o MiniMax.
Per i cicli lunghi, DeepSeek-V4-Flash ha una finestra di contesto di 380K e fino a 32.768 token di output per risposta, con un unico prezzo a qualsiasi ora. GLM-5.3-Flash ha una finestra di 390K e MiniMax-M2.7 di 180K, quindi verifica che la tua richiesta più grande ci stia.
Scegli il tuo caso
A quale progetto assomiglia il tuo?
Scegli un'opzione per vedere la risposta
Molte sessioni brevi
Task piccoli, ognuno che parte da zero: l'input per chiamata resta basso. Moltiplica sessioni per passi, e aspettati che il totale sia dominato dal numero di chiamate, non dalla loro dimensione.
Poche sessioni molto lunghe
La cronologia cresce durante la sessione, quindi gli ultimi passi sono quelli costosi. Stima con la richiesta più grande, suddividi il lavoro in sessioni figlie con un breve brief ciascuna, e l'input smette di crescere a valanga.
Calcolo pesante più agenti
Come RSA-260: il lavoro stesso richiede hardware. Prezza l'hardware all'ora dal tuo provider e tieni la voce token come stima separata. Non si sommano a mente, solo in un foglio di calcolo.
Restringi il task prima di alzare il budget#
Il report contiene un'altra lezione che si adatta a un budget: quanto più il codice si allontanava dall'upstream, tanto più gli agenti si confondevano. Gli agenti confusi fanno più passi. Se la tua stima sembra troppo alta, riduci prima i passi per sessione: un brief più chiaro, un'area di codice più piccola, passi fissi spostati in script (vedi gli agenti hanno bisogno del modello a ogni passo). Dimezzare i passi dimezza la voce token; è la leva più facile che hai.


