Optimasi biayaAnalisis
Anggarkan proyek agen jangka panjang: komputasi vs token (kasus RSA-260)
Judul $400k RSA-260 adalah sewa GPU, bukan token model. Pisahkan proyek agen jangka panjang menjadi tiga lini anggaran dan ukur bagian token dengan sesi × langkah × token.
Di halaman ini
Angka ~$400k dari faktorisasi RSA-260 milik Cognition itu adalah sewa GPU, bukan tagihan model. Laporan tersebut sama sekali tidak menghitung sisi agen, jadi jika Anda merencanakan proyek agen jangka panjang, Anda memperkirakan sendiri lini tokennya: sesi × langkah × token per langkah, dengan harga live. Itulah yang dilakukan sisa halaman ini.
Sumbernya adalah tulisan Cognition oleh Eric Lu, seorang engineer di Cognition (Factoring RSA-260, diterbitkan 9 September 2026, diperiksa 6 November 2026). Tulisan itu dibagikan ulang dengan angka dolar di judul, dan angka tersebut mudah disalahartikan.
Untuk apa $400k itu sebenarnya#
Penulis memfaktorkan bilangan 260 digit dengan GNFS, menggunakan CADO-NFS yang dimodifikasi berat agar berjalan di GPU. Laporan memberikan waktu GPU untuk setiap fase:
- pemilihan polinomial: 643 hari-GPU
- penyaringan: 3.813 hari-GPU
- penyelesaian sistem linear: 467 hari-GPU
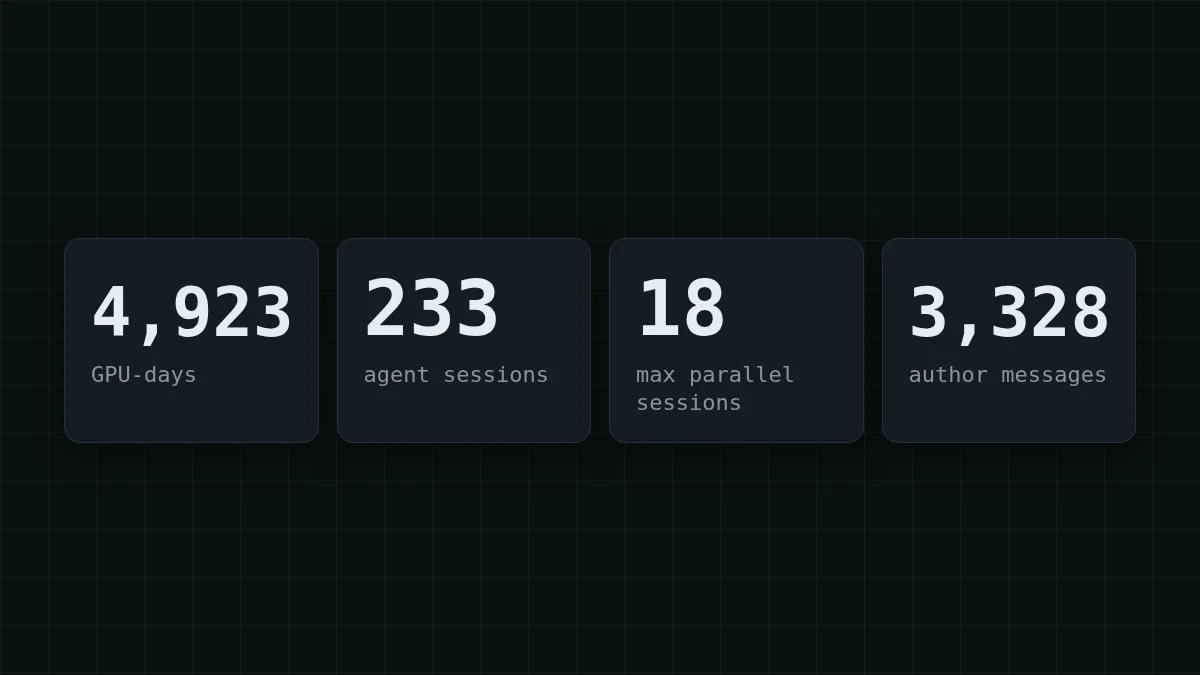
Itu berarti 643 + 3.813 + 467 = 4.923 hari-GPU, yang dibulatkan laporan menjadi ~4.900. Dengan asumsi laporan sebesar $3,50 per jam-GPU:
4.923 × 24 × 3,50 = 413.532
Itu cocok dengan angka GPU $414k di lampirannya. Jadi judulnya adalah perangkat keras sewaan yang menjalankan pekerjaan komputasi berat selama berminggu-minggu. Tidak ada token model dalam jumlah itu.
Cek cepat
Berapa angka ~$400k dalam laporan RSA-260?
Tampilkan jawaban
Jawaban: Sewa GPU dengan harga pasar untuk proses faktorisasi
Angka itu berasal dari hari-GPU × $3,50 per jam-GPU. Laporan tidak menyebut model apa pun dan tidak memberikan jumlah token untuk bagian agen.
Apa yang dilakukan agen, dan apa yang tidak dikatakan laporan#
Sisi agen dijelaskan melalui aktivitas, bukan biaya. Prompt pertama dikirim pada 13 Agustus 2026, pekerjaan memakan waktu sekitar tiga minggu, dan angkanya adalah:
- 233 sesi Devin untuk faktorisasi, rata-rata 3 berjalan paralel dan 18 pada puncaknya
- 192 di antaranya menerima pesan dari penulis, 36 berjalan tanpa intervensi manusia sama sekali
- 101 sesi anak dimulai oleh sesi lain
- Akuntansi Devin sendiri: 14.450 ACU (itu unit Devin, bukan token)
Sesi-sesi tersebut menangani pengukuran, operasi klaster, penyetelan, dan debugging. Manusia menetapkan prioritas dan membangun benchmark. Dua detail jujur dari penulis: dekomposisi di sekitar CADO-NFS dirancang oleh manusia dan itu penting, dan agen semakin bingung semakin jauh kode menyimpang dari upstream.
Yang hilang justru yang dibutuhkan anggaran: model apa, berapa token. Jadi jangan mencoba menurunkan tagihan token dari 14.450 ACU. Apa pun yang Anda baca online yang melakukannya adalah tebakan.
Lini ketiga: pengarahan manusia#
Penulis mengirim 3.328 pesan, total 82.702 kata. Itu berarti 82.702 ÷ 3.328 ≈ 25 kata per pesan, dorongan singkat bukan esai. Kata-kata itu hampir tidak memakan token. Yang mereka makan adalah perhatian: seseorang harus membaca apa yang dilakukan agen dan memutuskan langkah berikutnya. Saat Anda menganggarkan proyek agen, masukkan itu di lini terpisah dalam jam, bukan dolar penggunaan API.
Jadi proyek agen jangka panjang memiliki tiga lini:
Gulir tabel ke kanan →
| Lini | Dalam laporan RSA-260 | Apa yang menentukannya bagi Anda |
|---|---|---|
| Komputasi | ~$414k waktu GPU, dengan harga $3,50 per jam-GPU | Pekerjaan Anda sendiri: build, tes, pelatihan, simulasi |
| Token model | Tidak dilaporkan | Sesi × langkah × token per langkah |
| Pengarahan manusia | 3.328 pesan selama ~3 minggu | Seberapa sering Anda meninjau dan mengarahkan ulang |
Perkirakan lini token Anda#
Inilah rumusnya, dan satu hal yang orang lupakan: setiap langkah mengirim ulang riwayat. Agen tidak mengingat sesi; setiap panggilan membawa tugas, file yang dibaca, dan output alat sejauh ini. Itulah sebabnya token input biasanya jauh lebih besar daripada token output (lebih lanjut di mengapa agen AI menggunakan begitu banyak token).
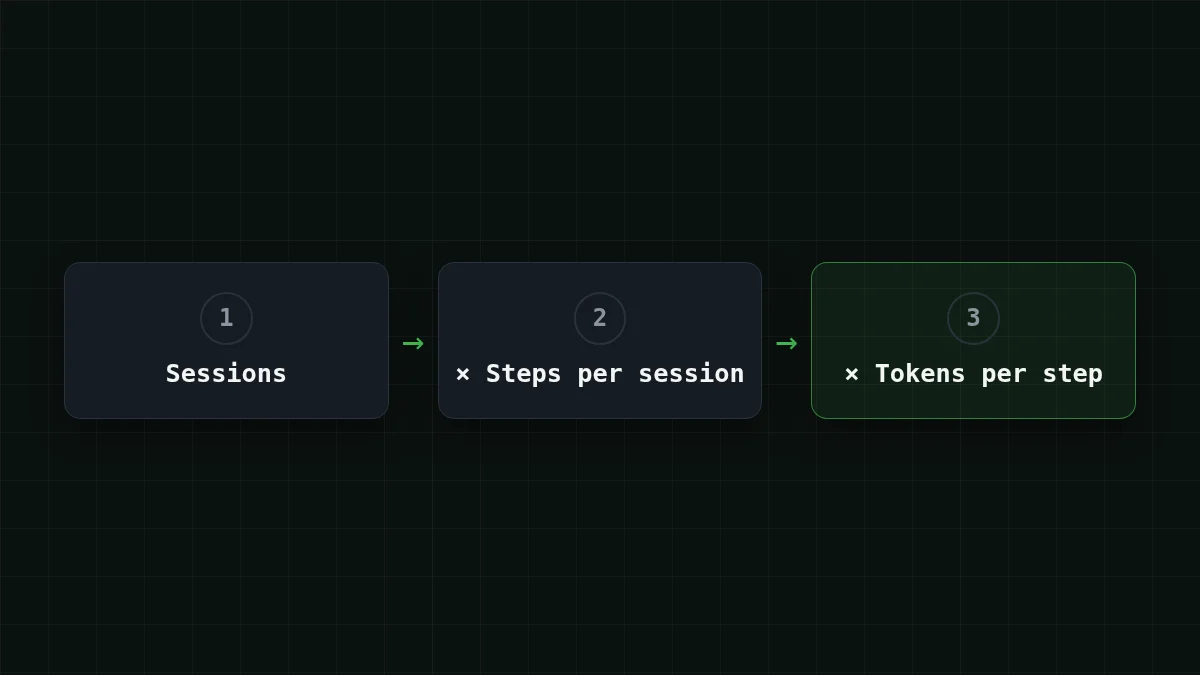
Katakanlah Anda merencanakan proyek seukuran milik Cognition, 233 sesi, dan Anda mengasumsikan 60 langkah per sesi. Dua angka ini adalah asumsi halaman ini, bukan data Cognition. Maka:
233 × 60 = 13.980
itu berarti 13.980 panggilan model. Sekarang ukuran satu panggilan. Misalkan langkah rata-rata mengirim 60.000 token masuk (tugas, riwayat, satu atau dua file) dan mendapat 1.500 token kembali (perintah atau patch). Totalnya:
60.000 × 13.980 = 838.800.000
1.500 × 13.980 = 20.970.000
Jadi sekitar 839 juta token input dan 21 juta token output. Input empat puluh kali output, dan di situlah anggaran Anda berada. Pada DeepSeek-V4-Flash proyek itu berbiaya $14.68, dan satu sesi 60 langkah berbiaya $0.063. Berikut beban yang sama pada setiap model, dengan referensi OpenRouter di sebelahnya:
| Model | Input $/1Jt | Output $/1Jt | Per permintaan | 13.980 permintaan | OpenRouter, 13.980 permintaan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0013 | $17.61 | $29.84 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0011 | $14.68 | $61.65 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0032 | $45.09 | $541.03 |
60.000 token input dan 1.500 token output per permintaan. Harga per 1 juta token adalah harga saat ini dan berubah seiring tarif kami; kolom OpenRouter menunjukkan harga referensi untuk beban kerja yang sama.
Dihitung secara total, dengan input dan output digabung, setiap model kami lebih murah daripada OpenRouter untuk beban ini. Harga live dari halaman harga, jadi tabelnya bergerak saat tarif berubah.
Coba sendiriCoba: sesi 60 langkah rata-rata mengirim 60.000 token masuk. Apakah langkah 1 mengirim sebanyak langkah 60?Tampilkan jawaban
Tidak. Langkah 1 mengirim sedikit (tugas dan beberapa file), langkah 60 mengirim ulang semua yang terkumpul di sepanjang jalan. Mengambil 60.000 sebagai rata-rata mengasumsikan sesi dimulai kecil dan berakhir mendekati 100K atau lebih. Jika Anda tahu sesi Anda berakhir pada, katakanlah, 120K, rata-ratanya sekitar setengahnya, jadi ukur permintaan terbesar, bukan hanya rata-rata.
Dapatkan angka Anda sendiri dalam sepuluh menit#
Asumsi hanyalah titik awal. Jalankan satu sesi nyata dari tugas Anda pada model murah dan baca objek usage yang dikembalikan API pada setiap respons. Endpoint yang kompatibel dengan OpenAI melaporkan prompt_tokens dan completion_ per panggilan:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "max_tokens": 1500, "messages": [{"role": "user", "content": "Summarize this test failure and propose a fix: ..."}]}'
Jumlahkan usage selama seluruh sesi, bagi dengan jumlah panggilan, dan ganti 60.000 dan 1.500 di atas dengan rata-rata Anda. Detail penyiapan ada di dokumentasi CheapTokens; pelacakan per langkah dalam kode ada di melacak biaya token agen AI dalam Python. Untuk aritmetika yang sama pada satu sesi 50 langkah, lihat biaya sesi agen pada GLM, DeepSeek atau MiniMax.
Untuk loop panjang, DeepSeek-V4-Flash memiliki jendela konteks 380K dan hingga 32.768 token output per jawaban, dengan satu harga kapan pun. GLM-5.3-Flash memiliki jendela 390K dan MiniMax-M2.7 memiliki 180K, jadi pastikan permintaan terbesar Anda muat.
Pilih kasus Anda
Proyek mana yang mirip dengan Anda?
Pilih opsi untuk melihat jawabannya
Banyak sesi pendek
Tugas kecil, masing-masing dimulai dari awal: input per panggilan tetap rendah. Kalikan sesi dengan langkah, dan perkirakan totalnya didominasi oleh jumlah panggilan, bukan ukurannya.
Beberapa sesi sangat panjang
Riwayat tumbuh sepanjang sesi, jadi langkah terakhir adalah yang mahal. Perkirakan dengan permintaan terbesar, pecah pekerjaan menjadi sesi anak dengan ringkasan singkat masing-masing, dan input berhenti membesar seperti bola salju.
Komputasi berat plus agen
Seperti RSA-260: pekerjaan itu sendiri membutuhkan perangkat keras. Harga perangkat keras per jam dari penyedia Anda, dan pertahankan lini token sebagai perkiraan terpisah. Keduanya tidak dijumlahkan di kepala Anda, hanya di spreadsheet.
Persempit tugas sebelum menaikkan anggaran#
Laporan itu punya satu pelajaran lagi yang cocok untuk anggaran: semakin jauh kode menyimpang dari upstream, semakin bingung agen. Agen yang bingung mengambil lebih banyak langkah. Jika perkiraan Anda tampak terlalu tinggi, kecilkan langkah per sesi terlebih dahulu: ringkasan yang lebih jelas, area kode yang lebih kecil, langkah tetap dipindahkan ke skrip (lihat apakah agen membutuhkan model di setiap langkah). Memotong setengah langkah memotong setengah lini token; itu tuas termudah yang Anda miliki.


