لاگت کی بہتریتجزیہ
طویل ایجنٹ پروجیکٹ کا بجٹ: کمپیوٹ بمقابلہ ٹوکنز (RSA-260 کیس)
$400k RSA-260 کی سرخی GPU کرایہ ہے، ماڈل ٹوکنز نہیں۔ طویل ایجنٹ پروجیکٹ کو تین بجٹ لائنوں میں تقسیم کریں اور ٹوکن حصے کا سائز سیشنز × مراحل × ٹوکنز سے طے کریں۔
اس صفحہ پر
Cognition کے RSA-260 فیکٹرنگ سے حاصل ہونے والا ~$400k کا عدد GPU کرایہ ہے، ماڈل بل نہیں۔ رپورٹ ایجنٹ کی طرف کی قیمت بالکل نہیں لگاتی، لہٰذا اگر آپ طویل ایجنٹ پروجیکٹ کا منصوبہ بنا رہے ہیں تو ٹوکن لائن کا تخمینہ خود لگائیں: سیشنز × مراحل × فی مرحلہ ٹوکنز، لائیو قیمتوں پر۔ یہی اس صفحے کا باقی حصہ کرتا ہے۔
ماخذ Cognition کی تحریر ہے جس کے مصنف Eric Lu ہیں، جو Cognition میں انجینئر ہیں (Factoring RSA-260، 9 ستمبر 2026 کو شائع، 6 نومبر 2026 کو چیک کیا گیا)۔ اسے دوبارہ شیئر کیا جا رہا ہے جس کی سرخی میں ڈالر کا عدد ہے، اور اس عدد کو غلط پڑھنا آسان ہے۔
$400k دراصل کس چیز کے لیے ہے#
مصنف نے GNFS کے ذریعے 260 ہندسوں کا عدد فیکٹر کیا، ایک بہت زیادہ تبدیل شدہ CADO-NFS استعمال کرتے ہوئے جو GPUs پر چلتا ہے۔ رپورٹ ہر مرحلے کے لیے GPU وقت دیتی ہے:
- پولینومیل انتخاب: 643 GPU-دن
- چھلنی: 3,813 GPU-دن
- لکیری نظام حل: 467 GPU-دن
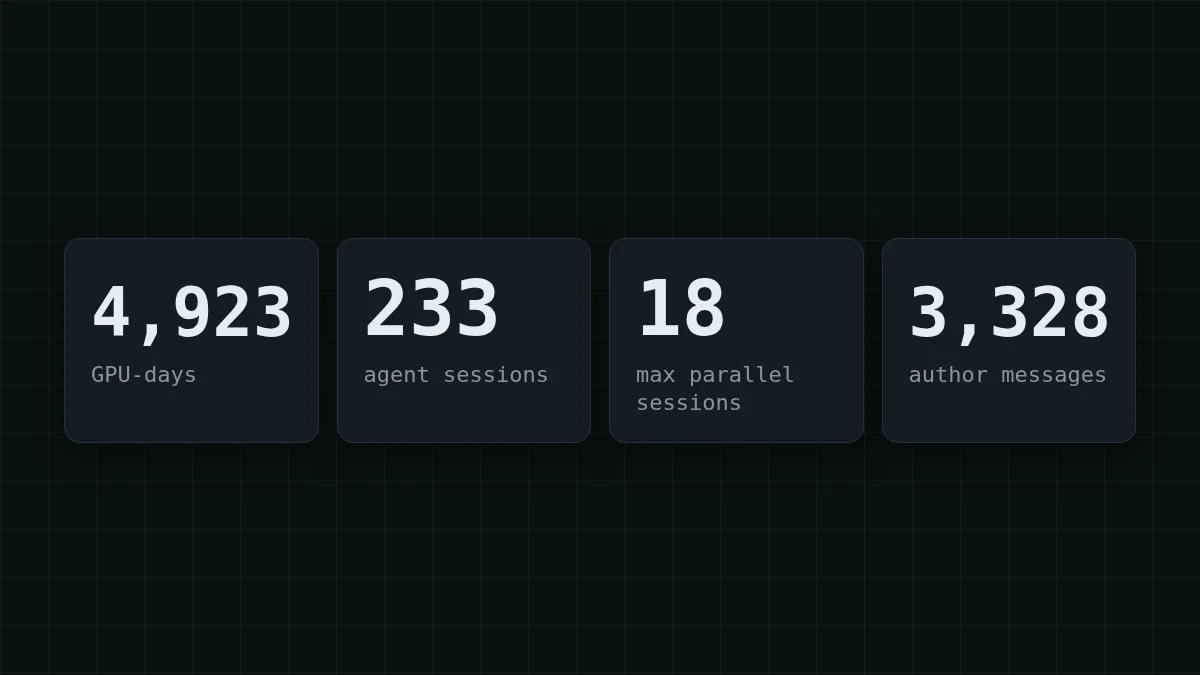
یہ 643 + 3,813 + 467 = 4,923 GPU-دن ہیں، جنہیں رپورٹ ~4,900 تک گول کرتی ہے۔ رپورٹ کے فرض کردہ $3.50 فی GPU-گھنٹہ پر:
4,923 × 24 × 3.50 = 413,532
یہ اس کے ضمیمے میں دیے گئے $414k GPU عدد سے میل کھاتا ہے۔ تو سرخی کرائے کا ہارڈویئر ہے جو ہفتوں تک عددی کام کر رہا ہے۔ اس رقم میں کوئی ماڈل ٹوکنز شامل نہیں۔
فوری جانچ
RSA-260 رپورٹ میں ~$400k کا عدد کیا ہے؟
جواب دکھائیں
جواب: فیکٹرنگ رن کے لیے GPUs کا مارکیٹ ریٹ کرایہ
یہ GPU-دن × $3.50 فی GPU-گھنٹہ سے آتا ہے۔ رپورٹ کوئی ماڈل نام نہیں دیتی اور ایجنٹ حصے کے لیے کوئی ٹوکن تعداد نہیں دیتی۔
ایجنٹس نے کیا کیا، اور رپورٹ کیا نہیں کہتی#
ایجنٹ کی طرف سرگرمی سے بیان کی گئی ہے، لاگت سے نہیں۔ پہلا پرامپٹ 13 اگست 2026 کو گیا، کام میں تقریباً تین ہفتے لگے، اور اعداد یہ ہیں:
- فیکٹرنگ کے لیے 233 Devin سیشنز، اوسطاً 3 متوازی چل رہے تھے اور چوٹی پر 18
- ان میں سے 192 کو مصنف کی طرف سے پیغامات ملے، 36 بالکل بغیر انسانی مداخلت کے چلے
- 101 چائلڈ سیشنز دوسرے سیشنز نے شروع کیے
- Devin کی اپنی حساب کتاب: 14,450 ACUs (یہ Devin کی اکائی ہے، ٹوکنز نہیں)
سیشنز نے پیمائش، کلسٹر آپریشنز، ٹیوننگ اور ڈیبگنگ سنبھالی۔ انسان نے ترجیحات طے کیں اور بینچ مارکس بنائے۔ مصنف کی دو ایماندار تفصیلات: CADO-NFS کے گرد ڈی کمپوزیشن ایک شخص نے ڈیزائن کی تھی اور یہ ضروری تھی، اور کوڈ جتنا زیادہ اپ اسٹریم سے ہٹتا گیا ایجنٹس اتنا ہی زیادہ الجھتے گئے۔
جو چیز غائب ہے وہی ہے جو بجٹ کو درکار ہوتی ہے: کون سے ماڈلز، کتنے ٹوکنز۔ لہٰذا 14,450 ACUs سے ٹوکن بل نکالنے کی کوشش نہ کریں۔ آن لائن جو کچھ بھی ایسا کرتا ہے وہ اندازہ ہے۔
تیسری لائن: انسانی رہنمائی#
مصنف نے 3,328 پیغامات بھیجے، کل 82,702 الفاظ۔ یہ 82,702 ÷ 3,328 ≈ 25 الفاظ فی پیغام ہیں، مختصر اشارے نہ کہ مضامین۔ ان الفاظ کی ٹوکنز میں تقریباً کوئی لاگت نہیں۔ وہ توجہ کی لاگت رکھتے ہیں: کسی کو پڑھنا ہوتا ہے کہ ایجنٹس نے کیا کیا اور فیصلہ کرنا ہوتا ہے کہ آگے کیا ہے۔ جب آپ ایجنٹ پروجیکٹ کا بجٹ بنائیں تو اسے اپنی الگ لائن میں گھنٹوں میں رکھیں، API استعمال کے ڈالرز میں نہیں۔
تو ایک طویل ایجنٹ پروجیکٹ کی تین لائنیں ہیں:
ٹیبل کو دائیں طرف اسکرول کریں →
| لائن | RSA-260 رپورٹ میں | آپ کے لیے اسے کیا طے کرتا ہے |
|---|---|---|
| کمپیوٹ | ~$414k GPU وقت، $3.50 فی GPU-گھنٹہ پر قیمت | آپ کا کام خود: بلڈز، ٹیسٹس، ٹریننگ، سمولیشنز |
| ماڈل ٹوکنز | رپورٹ نہیں کی گئیں | سیشنز × مراحل × فی مرحلہ ٹوکنز |
| انسانی رہنمائی | ~3 ہفتوں میں 3,328 پیغامات | آپ کتنی بار جائزہ لیتے اور رخ بدلتے ہیں |
اپنی ٹوکن لائن کا تخمینہ لگائیں#
فارمولا یہ ہے، اور ایک چیز جو لوگ بھول جاتے ہیں: ہر مرحلہ تاریخ دوبارہ بھیجتا ہے۔ ایجنٹ سیشن یاد نہیں رکھتا؛ ہر کال میں ٹاسک، اس کی پڑھی ہوئی فائلیں اور اب تک کا ٹول آؤٹ پٹ شامل ہوتا ہے۔ اسی لیے ان پٹ ٹوکنز عام طور پر آؤٹ پٹ ٹوکنز سے بہت زیادہ ہوتے ہیں (کیوں AI ایجنٹس اتنے زیادہ ٹوکنز استعمال کرتے ہیں میں مزید)۔
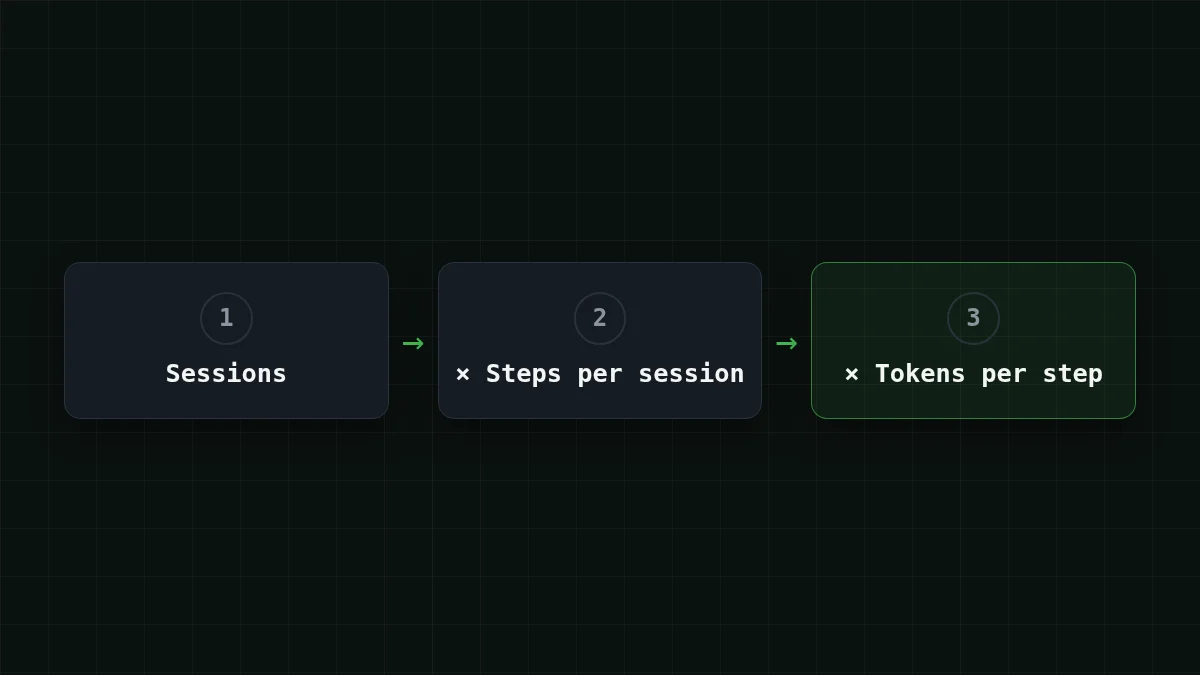
فرض کریں آپ Cognition کے سائز کا پروجیکٹ، 233 سیشنز، کا منصوبہ بناتے ہیں، اور فی سیشن 60 مراحل مانتے ہیں۔ یہ دو اعداد اس صفحے کے مفروضے ہیں، Cognition کا ڈیٹا نہیں۔ پھر:
233 × 60 = 13,980
یعنی 13,980 ماڈل کالز۔ اب ایک کال کا سائز۔ فرض کریں اوسط مرحلہ 60,000 ٹوکنز اندر بھیجتا ہے (ٹاسک، تاریخ، ایک دو فائلیں) اور 1,500 ٹوکنز واپس پاتا ہے (ایک کمانڈ یا پیچ)۔ کل:
60,000 × 13,980 = 838,800,000
1,500 × 13,980 = 20,970,000
تو تقریباً 839M ان پٹ ٹوکنز اور 21M آؤٹ پٹ ٹوکنز۔ ان پٹ آؤٹ پٹ سے چالیس گنا ہے، اور یہی وہ طرف ہے جہاں آپ کا بجٹ رہتا ہے۔ DeepSeek-V4-Flash پر اس پروجیکٹ کی لاگت $14.68 ہے، اور 60 مراحل کا ایک سیشن $0.063 ہے۔ یہاں ہر ماڈل پر وہی بوجھ ہے، ساتھ میں OpenRouter کا حوالہ:
| ماڈل | ان پٹ $/1M | آؤٹ پٹ $/1M | فی درخواست | 13,980 درخواستیں | OpenRouter، 13,980 درخواستیں |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0013 | $17.61 | $29.84 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0011 | $14.68 | $61.65 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0032 | $45.09 | $541.03 |
فی درخواست 60,000 ان پٹ اور 1,500 آؤٹ پٹ ٹوکنز۔ فی 1M ٹوکنز کی قیمتیں موجودہ ہیں اور ہمارے ٹیرف کے ساتھ تبدیل ہوتی ہیں؛ OpenRouter کالم اسی ورک لوڈ کے لیے حوالہ جاتی قیمتیں دکھاتا ہے۔
کل میں گنتی کریں تو، ان پٹ اور آؤٹ پٹ ملا کر، اس بوجھ کے لیے ہمارا ہر ماڈل OpenRouter سے سستا نکلتا ہے۔ قیمتیں قیمتوں کے صفحے سے لائیو ہیں، تو جدول بدلتا رہتا ہے جب ٹیرف بدلتے ہیں۔
خود آزمائیںآزمائیں: 60-مرحلہ سیشن اوسطاً 60,000 ٹوکنز اندر بھیجتا ہے۔ کیا مرحلہ 1 اتنا ہی بھیجتا ہے جتنا مرحلہ 60؟جواب دکھائیں
نہیں۔ مرحلہ 1 کم بھیجتا ہے (ٹاسک اور چند فائلیں)، مرحلہ 60 راستے میں جمع ہونے والا سب کچھ دوبارہ بھیجتا ہے۔ 60,000 کو اوسط ماننا یہ فرض کرتا ہے کہ سیشن چھوٹا شروع ہوتا ہے اور 100K یا اس سے زیادہ کے قریب ختم ہوتا ہے۔ اگر آپ جانتے ہیں کہ آپ کے سیشنز، مثلاً، 120K پر ختم ہوتے ہیں، تو اوسط اس کا تقریباً نصف ہے، لہٰذا سب سے بڑی درخواست کی پیمائش کریں، صرف اوسط کی نہیں۔
اپنے اعداد دس منٹ میں حاصل کریں#
مفروضے صرف نقطہ آغاز ہیں۔ اپنے ٹاسک کا ایک حقیقی سیشن سستے ماڈل پر چلائیں اور ہر جواب پر API کے واپس کردہ usage آبجیکٹ کو پڑھیں۔ OpenAI-مطابق اینڈ پوائنٹس فی کال prompt_tokens اور completion_ رپورٹ کرتے ہیں:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "max_tokens": 1500, "messages": [{"role": "user", "content": "Summarize this test failure and propose a fix: ..."}]}'
پورے سیشن پر usage جمع کریں، کالز کی تعداد سے تقسیم کریں، اور اوپر کے 60,000 اور 1,500 کو اپنی اوسط سے بدل دیں۔ سیٹ اپ کی تفصیلات CheapTokens ڈاکس میں ہیں؛ کوڈ میں فی مرحلہ ٹریکنگ Python میں AI ایجنٹ ٹوکن لاگت ٹریک کریں میں ہے۔ ایک ہی 50-مرحلہ سیشن پر وہی حساب GLM، DeepSeek یا MiniMax پر ایجنٹ سیشن لاگت میں دیکھیں۔
طویل لوپس کے لیے، DeepSeek-V4-Flash کا 380K کانٹیکسٹ ونڈو اور فی جواب 32,768 آؤٹ پٹ ٹوکنز تک ہے، کسی بھی وقت ایک ہی قیمت کے ساتھ۔ GLM-5.3-Flash کا 390K ونڈو اور MiniMax-M2.7 کا 180K ہے، تو چیک کریں کہ آپ کی سب سے بڑی درخواست فٹ ہوتی ہے۔
اپنا کیس منتخب کریں
کون سا پروجیکٹ آپ کے جیسا لگتا ہے؟
جواب دیکھنے کے لیے ایک آپشن منتخب کریں
بہت سے مختصر سیشنز
چھوٹے ٹاسکس، ہر ایک نئے سرے سے: فی کال ان پٹ کم رہتا ہے۔ سیشنز کو مراحل سے ضرب دیں، اور توقع رکھیں کہ کل پر کالز کی گنتی حاوی ہوگی، ان کا سائز نہیں۔
چند بہت طویل سیشنز
تاریخ سیشن کے دوران بڑھتی ہے، تو آخری مراحل مہنگے ہوتے ہیں۔ سب سے بڑی درخواست سے تخمینہ لگائیں، کام کو چائلڈ سیشنز میں تقسیم کریں جن میں ہر ایک کا مختصر بریف ہو، اور ان پٹ کا برفانی گولہ بند ہو جاتا ہے۔
بھاری کمپیوٹ کے ساتھ ایجنٹس
RSA-260 کی طرح: کام خود ہارڈویئر مانگتا ہے۔ ہارڈویئر کی قیمت اپنے فراہم کنندہ سے فی گھنٹہ لگائیں، اور ٹوکن لائن کو الگ تخمینہ رکھیں۔ وہ آپ کے دماغ میں نہیں، صرف اسپریڈ شیٹ میں جمع ہوتے ہیں۔
بجٹ بڑھانے سے پہلے ٹاسک کو تنگ کریں#
رپورٹ میں ایک اور سبق ہے جو بجٹ پر لاگو ہوتا ہے: کوڈ جتنا زیادہ اپ اسٹریم سے ہٹتا گیا، ایجنٹس اتنا ہی زیادہ الجھتے گئے۔ الجھے ہوئے ایجنٹس زیادہ مراحل لیتے ہیں۔ اگر آپ کا تخمینہ بہت زیادہ لگتا ہے تو پہلے فی سیشن مراحل کم کریں: واضح بریف، کوڈ کا چھوٹا علاقہ، مقررہ مراحل اسکرپٹس میں منتقل کریں (کیا ایجنٹس کو ہر مرحلے پر ماڈل کی ضرورت ہے دیکھیں)۔ مراحل آدھے کرنے سے ٹوکن لائن آدھی ہو جاتی ہے؛ یہی آپ کا سب سے آسان لیور ہے۔


