लागत अनुकूलनविश्लेषण
एक लंबी एजेंट परियोजना का बजट: कंप्यूट बनाम टोकन (RSA-260 मामला)
$400k RSA-260 हेडलाइन GPU किराया है, मॉडल टोकन नहीं। एक लंबी एजेंट परियोजना को तीन बजट पंक्तियों में विभाजित करें और टोकन भाग को सत्र × चरण × टोकन से मापें।
इस पृष्ठ पर
Cognition के RSA-260 फैक्टरिंग से मिली वह ~$400k राशि GPU किराये की है, मॉडल बिल की नहीं। रिपोर्ट एजेंट पक्ष की कीमत बिल्कुल नहीं बताती, इसलिए यदि आप एक लंबी एजेंट परियोजना की योजना बनाते हैं, तो आप टोकन लाइन का अनुमान स्वयं लगाते हैं: सत्र × चरण × प्रति चरण टोकन, लाइव कीमतों पर। यह पेज का बाकी हिस्सा यही करता है।
स्रोत Cognition के इंजीनियर Eric Lu का लेख है (Factoring RSA-260, 9 सितंबर 2026 को प्रकाशित, 6 नवंबर 2026 को जाँचा गया)। इसे हेडलाइन में डॉलर के आंकड़े के साथ फिर से साझा किया जा रहा है, और उस आंकड़े को गलत समझना आसान है।
$400k वास्तव में किस चीज़ के लिए है#
लेखक ने GNFS का उपयोग करके 260 अंकों की संख्या का गुणनखंडन किया, एक भारी संशोधित CADO-NFS से जो GPUs पर चलता है। रिपोर्ट प्रत्येक चरण के लिए GPU समय देती है:
- बहुपद चयन: 643 GPU-दिन
- छलनी: 3,813 GPU-दिन
- रैखिक समीकरण हल करना: 467 GPU-दिन
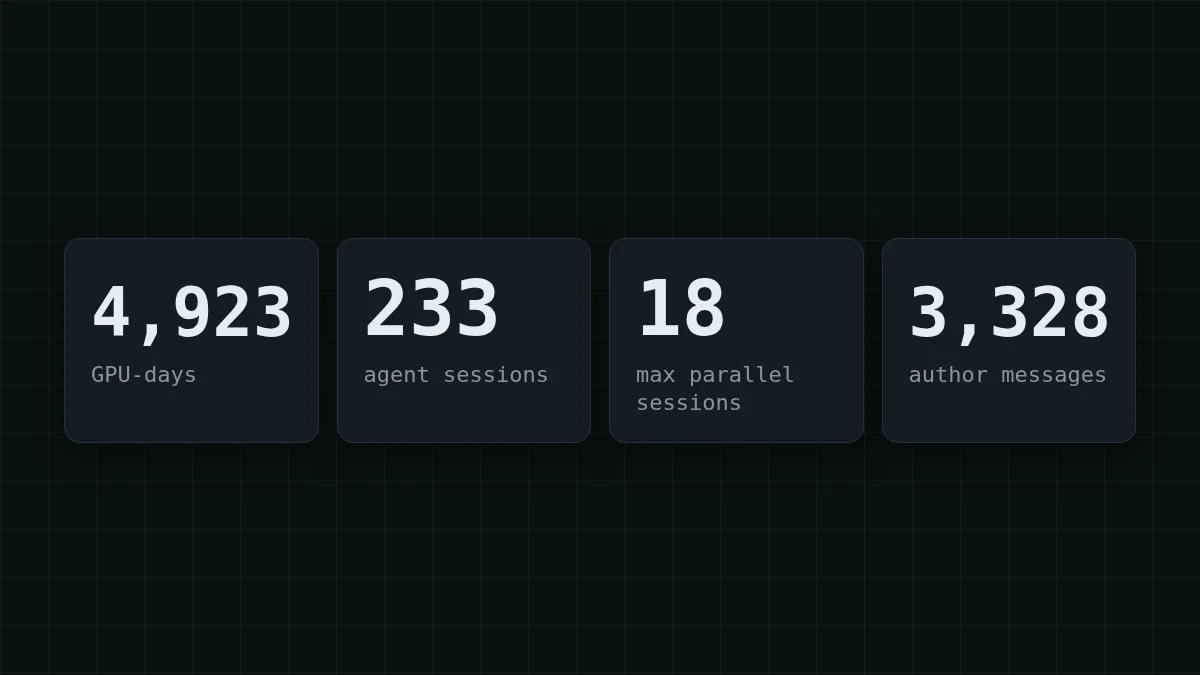
यह 643 + 3,813 + 467 = 4,923 GPU-दिन है, जिसे रिपोर्ट ~4,900 तक गोल करती है। रिपोर्ट के अनुमानित $3.50 प्रति GPU-घंटे पर:
4,923 × 24 × 3.50 = 413,532
यह इसके परिशिष्ट में दिए गए $414k GPU आंकड़े से मेल खाता है। तो हेडलाइन किराए पर लिया गया हार्डवेयर है जो हफ्तों तक संख्या-क्रंचिंग कार्य चला रहा है। उस योग में कोई मॉडल टोकन नहीं हैं।
त्वरित जाँच
RSA-260 रिपोर्ट में ~$400k का आंकड़ा क्या है?
उत्तर दिखाएँ
उत्तर: फैक्टरिंग रन के लिए GPUs का बाजार-दर किराया
यह GPU-दिन × $3.50 प्रति GPU-घंटे से आता है। रिपोर्ट कोई मॉडल नाम नहीं देती और एजेंट भाग के लिए कोई टोकन गणना नहीं देती।
एजेंटों ने क्या किया, और रिपोर्ट क्या नहीं बताती#
एजेंट पक्ष को लागत से नहीं, गतिविधि से वर्णित किया गया है। पहला प्रॉम्प्ट 13 अगस्त 2026 को गया, काम में लगभग तीन सप्ताह लगे, और संख्याएँ हैं:
- फैक्टरिंग के लिए 233 Devin सत्र, औसतन 3 समानांतर चल रहे थे और शिखर पर 18
- उनमें से 192 को लेखक से संदेश मिले, 36 बिना किसी मानवीय हस्तक्षेप के चले
- 101 चाइल्ड सत्र अन्य सत्रों द्वारा शुरू किए गए
- Devin का अपना लेखा: 14,450 ACUs (यह Devin की इकाई है, टोकन नहीं)
सत्रों ने माप, क्लस्टर संचालन, ट्यूनिंग और डिबगिंग संभाली। मानव ने प्राथमिकताएँ तय कीं और बेंचमार्क बनाए। लेखक से दो ईमानदार विवरण: CADO-NFS के आसपास का अपघटन एक व्यक्ति द्वारा डिज़ाइन किया गया था और आवश्यक था, और कोड अपस्ट्रीम से जितना दूर जाता गया, एजेंट उतने ही अधिक भ्रमित होते गए।
जो गायब है वह ठीक वही है जो बजट को चाहिए: कौन से मॉडल, कितने टोकन। इसलिए 14,450 ACUs से टोकन बिल निकालने की कोशिश न करें। ऑनलाइन जो कुछ भी आप पढ़ते हैं जो ऐसा करता है, वह अनुमान है।
तीसरी पंक्ति: मानवीय मार्गदर्शन#
लेखक ने 3,328 संदेश भेजे, कुल 82,702 शब्द। यह 82,702 ÷ 3,328 ≈ 25 शब्द प्रति संदेश है, निबंधों के बजाय छोटे संकेत। उन शब्दों की टोकन में लागत लगभग शून्य है। वे ध्यान की लागत लेते हैं: किसी को पढ़ना होता है कि एजेंटों ने क्या किया और तय करना होता है कि आगे क्या करना है। जब आप एक एजेंट परियोजना का बजट बनाएं, तो उसे घंटों में अपनी अलग पंक्ति में रखें, API उपयोग के डॉलर में नहीं।
तो एक लंबी एजेंट परियोजना में तीन पंक्तियाँ होती हैं:
तालिका को दाईं ओर स्क्रॉल करें →
| पंक्ति | RSA-260 रिपोर्ट में | आपके लिए इसे क्या तय करता है |
|---|---|---|
| कंप्यूट | ~$414k GPU समय, $3.50 प्रति GPU-घंटे पर मूल्यांकित | आपका कार्य स्वयं: बिल्ड, टेस्ट, प्रशिक्षण, सिमुलेशन |
| मॉडल टोकन | रिपोर्ट नहीं किया गया | सत्र × चरण × प्रति चरण टोकन |
| मानवीय मार्गदर्शन | ~3 सप्ताह में 3,328 संदेश | आप कितनी बार समीक्षा और पुनर्निर्देशन करते हैं |
अपनी टोकन लाइन का अनुमान लगाएं#
यहाँ सूत्र है, और एक चीज़ जो लोग भूल जाते हैं: प्रत्येक चरण इतिहास को फिर से भेजता है। एक एजेंट सत्र को याद नहीं रखता; प्रत्येक कॉल में कार्य, उसके द्वारा पढ़ी गई फाइलें और अब तक का टूल आउटपुट होता है। इसलिए इनपुट टोकन आमतौर पर आउटपुट टोकन से बहुत अधिक होते हैं (AI एजेंट इतने सारे टोकन क्यों उपयोग करते हैं में अधिक जानकारी)।
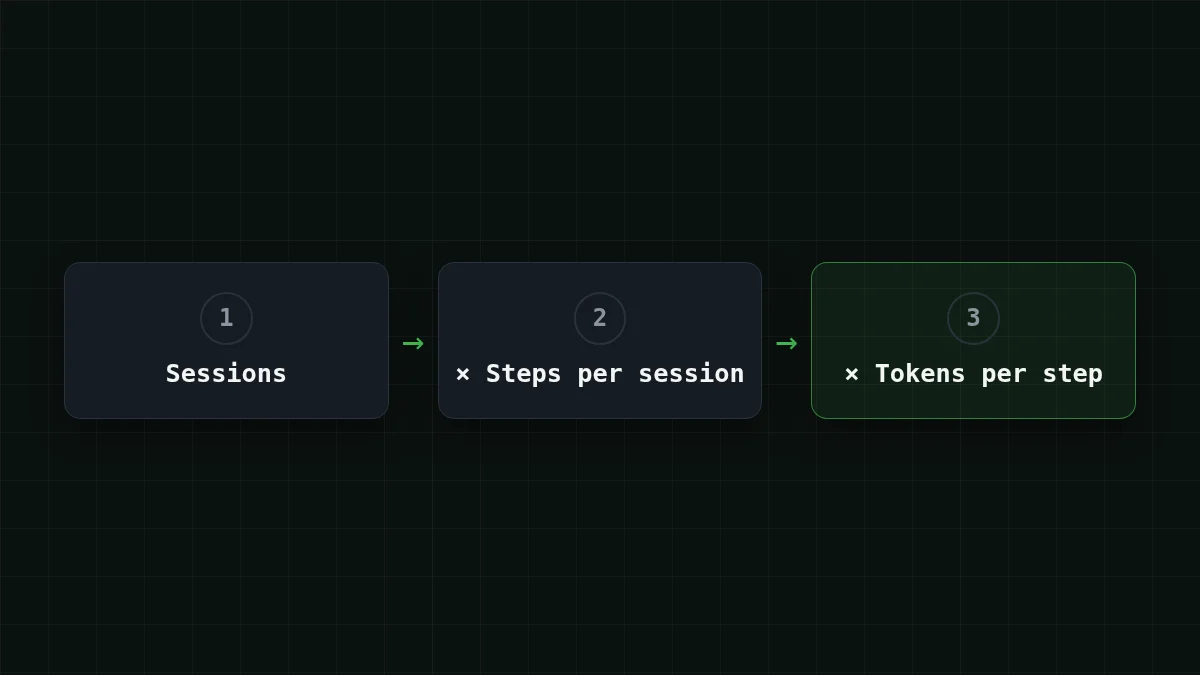
मान लें कि आप Cognition के आकार की परियोजना की योजना बनाते हैं, 233 सत्र, और आप प्रति सत्र 60 चरण मानते हैं। ये दो संख्याएँ इस पेज की मान्यताएँ हैं, Cognition डेटा नहीं। तो:
233 × 60 = 13,980
यह 13,980 मॉडल कॉल हैं। अब एक कॉल का आकार। मान लें कि एक औसत चरण 60,000 टोकन इन भेजता है (कार्य, इतिहास, एक या दो फाइलें) और 1,500 टोकन वापस पाता है (एक कमांड या एक पैच)। कुल:
60,000 × 13,980 = 838,800,000
1,500 × 13,980 = 20,970,000
तो लगभग 839M इनपुट टोकन और 21M आउटपुट टोकन। इनपुट आउटपुट का चालीस गुना है, और यही वह पक्ष है जहाँ आपका बजट रहता है। DeepSeek-V4-Flash पर उस परियोजना की लागत $14.68 है, और 60 चरणों का एक सत्र $0.063 है। यहाँ हर मॉडल पर वही लोड है, साथ में OpenRouter संदर्भ:
| मॉडल | इनपुट $/1M | आउटपुट $/1M | प्रति अनुरोध | 13,980 अनुरोध | OpenRouter, 13,980 अनुरोध |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0013 | $17.61 | $29.84 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0011 | $14.68 | $61.65 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0032 | $45.09 | $541.03 |
प्रति अनुरोध 60,000 इनपुट और 1,500 आउटपुट टोकन। प्रति 1M टोकन की कीमतें वर्तमान हैं और हमारे टैरिफ के साथ बदलती रहती हैं; OpenRouter कॉलम समान कार्यभार के लिए संदर्भ कीमतें दिखाता है।
कुल मिलाकर, इनपुट और आउटपुट को एक साथ लेकर, इस लोड के लिए हमारे प्रत्येक मॉडल OpenRouter से सस्ते पड़ते हैं। कीमतें मूल्य पृष्ठ से लाइव हैं, इसलिए टैरिफ बदलने पर तालिका बदलती है।
स्वयं आज़माएँइसे आज़माएं: 60-चरण वाला सत्र औसतन 60,000 टोकन इन भेजता है। क्या चरण 1 उतना ही भेजता है जितना चरण 60?उत्तर दिखाएँ
नहीं। चरण 1 थोड़ा भेजता है (कार्य और कुछ फाइलें), चरण 60 रास्ते में एकत्रित सब कुछ फिर से भेजता है। 60,000 को औसत मानने का अर्थ है कि सत्र छोटा शुरू होता है और 100K या अधिक के करीब समाप्त होता है। यदि आप जानते हैं कि आपके सत्र, मान लीजिए, 120K पर समाप्त होते हैं, तो औसत उसका लगभग आधा है, इसलिए सबसे बड़े अनुरोध को मापें, केवल औसत को नहीं।
दस मिनट में अपने स्वयं के आंकड़े प्राप्त करें#
मान्यताएँ केवल एक शुरुआती बिंदु हैं। अपने कार्य का एक वास्तविक सत्र एक सस्ते मॉडल पर चलाएं और हर प्रतिक्रिया पर API द्वारा लौटाए गए usage ऑब्जेक्ट को पढ़ें। OpenAI-संगत एंडपॉइंट प्रति कॉल prompt_tokens और completion_ रिपोर्ट करते हैं:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "max_tokens": 1500, "messages": [{"role": "user", "content": "Summarize this test failure and propose a fix: ..."}]}'
पूरे सत्र में usage का योग करें, कॉल की संख्या से विभाजित करें, और ऊपर के 60,000 और 1,500 को अपने औसत से बदलें। सेटअप विवरण CheapTokens दस्तावेज़ में हैं; कोड में प्रति-चरण ट्रैकिंग Python में AI एजेंट टोकन लागत ट्रैक करें में है। एकल 50-चरण सत्र पर वही गणना के लिए, देखें GLM, DeepSeek या MiniMax पर एजेंट सत्र लागत।
लंबे लूप के लिए, DeepSeek-V4-Flash में 380K संदर्भ विंडो और प्रति उत्तर अधिकतम 32,768 आउटपुट टोकन हैं, किसी भी घंटे एक ही कीमत पर। GLM-5.3-Flash में 390K विंडो है और MiniMax-M2.7 में 180K है, इसलिए जाँचें कि आपका सबसे बड़ा अनुरोध फिट बैठता है।
अपना मामला चुनें
कौन सी परियोजना आपकी जैसी दिखती है?
उत्तर देखने के लिए एक विकल्प चुनें
कई छोटे सत्र
छोटे कार्य, प्रत्येक नए सिरे से शुरू: प्रति कॉल इनपुट कम रहता है। सत्रों को चरणों से गुणा करें, और अपेक्षा करें कि कुल कॉल की संख्या से प्रभावित होगा, उनके आकार से नहीं।
कुछ बहुत लंबे सत्र
सत्र के दौरान इतिहास बढ़ता है, इसलिए अंतिम चरण महंगे होते हैं। सबसे बड़े अनुरोध से अनुमान लगाएं, कार्य को चाइल्ड सत्रों में विभाजित करें जिनमें प्रत्येक का संक्षिप्त विवरण हो, और इनपुट स्नोबॉल होना बंद हो जाता है।
भारी कंप्यूट प्लस एजेंट
RSA-260 की तरह: कार्य को स्वयं हार्डवेयर चाहिए। अपने प्रदाता से हार्डवेयर की प्रति घंटा कीमत लें, और टोकन लाइन को अलग अनुमान के रूप में रखें। वे आपके दिमाग में नहीं, केवल स्प्रेडशीट में जुड़ते हैं।
बजट बढ़ाने से पहले कार्य को संकीर्ण करें#
रिपोर्ट में एक और सबक है जो बजट में फिट बैठता है: कोड अपस्ट्रीम से जितना दूर जाता गया, एजेंट उतने ही अधिक भ्रमित होते गए। भ्रमित एजेंट अधिक चरण लेते हैं। यदि आपका अनुमान बहुत अधिक लगता है, तो पहले प्रति सत्र चरण कम करें: एक स्पष्ट संक्षिप्त विवरण, कोड का छोटा क्षेत्र, निश्चित चरणों को स्क्रिप्ट में स्थानांतरित करें (क्या एजेंटों को हर चरण में मॉडल की आवश्यकता होती है देखें)। चरणों को आधा करने से टोकन लाइन आधी हो जाती है; यह आपका सबसे आसान लीवर है।


