क्या एजेंट को हर कदम पर मॉडल चाहिए? तय कदम कोड में डालें
हर टूल परिणाम एक और मॉडल कॉल क्यों करता है, कौन से एजेंट कदम सादा कोड हो सकते हैं, और 3-कदम के लूप की लागत अतिरिक्त कॉल के साथ और बिना।
इस पृष्ठ पर
आपका एजेंट दस मिनट तक चला, और बिल काम से बड़ा है। अक्सर कारण उबाऊ होता है: हर टूल परिणाम के बाद हार्नेस मॉडल को फिर से कॉल करता है, भले ही अगला कदम स्पष्ट था।
तो नहीं, एजेंट को हर कदम पर मॉडल की ज़रूरत नहीं होती। उसे मॉडल वहाँ चाहिए जहाँ कुछ तय करना होता है। जो कदम हमेशा एक जैसा हो, जैसे पास हुए बिल्ड के बाद टेस्ट चलाना, वह आपके कोड में एक सादा नियम हो सकता है।
इसकी परवाह करने की एक पैसे वाली वजह है। हर अतिरिक्त कॉल पूरे कॉन्टेक्स्ट को इनपुट टोकन के रूप में फिर से पढ़ता है (लंबी चैट वाला लेख बताता है क्यों), इसलिए छोड़ा गया कॉल अपने छोटे जवाब से ज़्यादा बचाता है। अगर लूप आपके लिए नया है, तो AI एजेंट कैसे काम करता है से शुरू करें और फिर लौटें।
एक टूल परिणाम का मतलब एक और मॉडल कॉल क्यों है#
मॉडल कभी कुछ चलाता नहीं। वह लिखता है "कृपया make build चलाएँ", आपका हार्नेस (मॉडल के आसपास का प्रोग्राम) उसे चलाता है, आउटपुट को बातचीत में चिपकाता है और अब तक के सब कुछ के साथ मॉडल को फिर से कॉल करता है। पूरा लूप यही है। मॉडल को तभी पता चलता है कि किसी टूल ने क्या लौटाया जब आप उसे कॉल करते हैं।
एक नए सहकर्मी की तरह सोचें जो हर एक कदम के बाद मैनेजर को फोन करके पूछता है "और अब?", भले ही चेकलिस्ट कहती है "कंपाइल करने के बाद, टेस्ट चलाएँ"। मैनेजर हर बार वही जवाब देता है, और हर कॉल में पूरी कहानी ऊपर से पढ़ने का एक मिनट लगता है।
एजेंट लॉग में यह ऐसा दिखता है। मान लें काम है "फेल हो रहा टेस्ट ठीक करें":
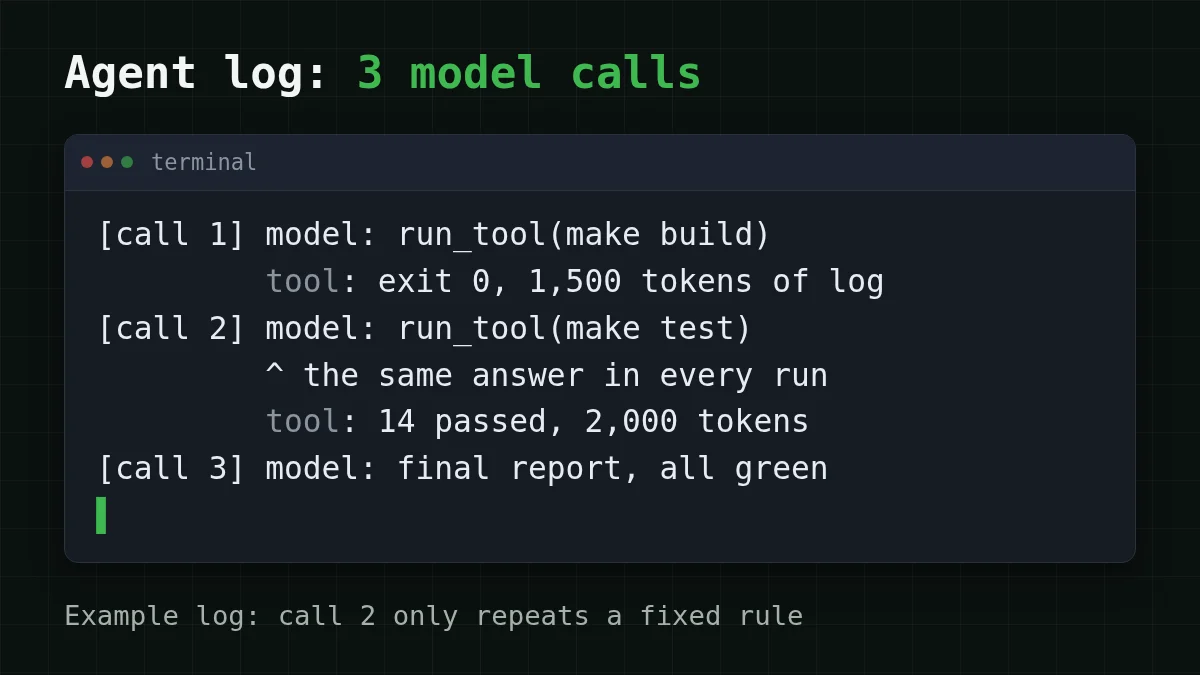
कॉल 2 दिलचस्प है। बिल्ड पास हुआ, अगला कदम हमेशा टेस्ट हैं, और मॉडल कॉन्टेक्स्ट का पूरा पाठ पढ़कर "टेस्ट चलाएँ" कहता है। कॉल 1 और कॉल 3 अलग हैं: कॉल 1 तय करता है कि शुरुआत कैसे करें, कॉल 3 टेस्ट परिणाम पढ़ता है और रिपोर्ट लिखता है। वे असली काम हैं।
कौन से कदम फैसला माँगते हैं और कौन से तय हैं#
तीन सवाल ज़्यादातर कदमों को छाँट देते हैं:
- क्या अगली क्रिया किसी स्पष्ट संकेत से तय होती है, जैसे exit code, HTTP स्टेटस या "मिला / नहीं मिला"?
- क्या वह संकेत आने पर हर बार वही क्रिया होती है?
- क्या गलत अनुमान पलटना सस्ता है?
तीनों हाँ: इसे नियम के रूप में लिखें। वरना मॉडल वह कदम रखे।
कोडिंग के बाहर एक दूसरा उदाहरण। मान लें आप एक सपोर्ट स्क्रिप्ट चलाते हैं: ग्राहक लिखता है, स्क्रिप्ट ऑर्डर देखती है, फिर जवाब देती है। ऑर्डर को उसके नंबर से देखना कोड है। टेम्पलेट से "आपका ऑर्डर {id} {status} है" भरना भी कोड है। "यह टूटा हुआ आया, अब क्या?" पढ़कर रिफंड, रिप्लेसमेंट और माफी के बीच चुनना एक फैसला है, इसलिए वह एक मॉडल कॉल है, तीन नहीं।
जोड़े मिलाएँ
हर कदम कौन संभाले?
बाईं ओर एक आइटम पर टैप करें, फिर उसका जोड़ा
- बिल्ड exit code 0 के साथ खत्म, और अगला कदम हमेशा टेस्ट हैंकोड: अगला कदम तय है
- टेस्ट स्टैक ट्रेस के साथ फेल; किस फ़ाइल में बदलाव चाहिए?मॉडल: एक नया फैसला
- नंबर से ऑर्डर मिला, अब उसका स्टेटस जवाब टेम्पलेट में डालेंकोड: टेम्पलेट भरें
- ग्राहक लिखता है "यह टूटा हुआ आया, अब क्या?"मॉडल: मुक्त टेक्स्ट पढ़ना
एक गार्ड इसे सुरक्षित बनाता है: नियम केवल सुखद रास्ते को कवर करता है। बिल्ड exit code 1 के साथ फेल? टेस्ट लाल? किसी टूल ने कुछ ऐसा लौटाया जिसकी नियम को उम्मीद नहीं थी? नियंत्रण मॉडल को वापस दें, बिल्कुल पहले जैसे। आप वे कॉल हटा रहे हैं जिनका केवल एक ही संभावित जवाब था, मॉडल को लूप से बाहर नहीं कर रहे।
3-कदम का लूप, अतिरिक्त कॉल के साथ और बिना#
"फेल हो रहा टेस्ट ठीक करें" लॉग पर संख्याएँ डालते हैं। मान्यताएँ, सब हमारी और आपकी से बदलने में आसान:
- सिस्टम प्रॉम्प्ट प्लस काम: 3,000 टोकन
- बिल्ड लॉग: 1,500 टोकन; टेस्ट लॉग: 2,000 टोकन
- केवल टूल माँगने वाला जवाब: 60 टोकन; अंतिम रिपोर्ट: 300 टोकन
संख्या का अनुमान लगाएँ
अगर टेस्ट रन कोड में चला जाए, तो लूप कितने मॉडल कॉल करता है?
आपका अनुमान
06
उत्तर दिखाएँ
उत्तर: 2
दो: एक बिल्ड शुरू करने के लिए, एक दोनों परिणाम पढ़कर रिपोर्ट लिखने के लिए। टेस्ट रन को अब किसी फैसले की ज़रूरत नहीं।
हर कदम पर मॉडल। कॉल 1 3,000 टोकन पढ़ता है। कॉल 2 3,000 + 60 + 1,500 = 4,560 पढ़ता है। कॉल 3 4,560 + 60 + 2,000 = 6,620 पढ़ता है। कुल इनपुट: 3,000 + 4,560 + 6,620 = 14,180 टोकन; आउटपुट: 60 + 60 + 300 = 420।
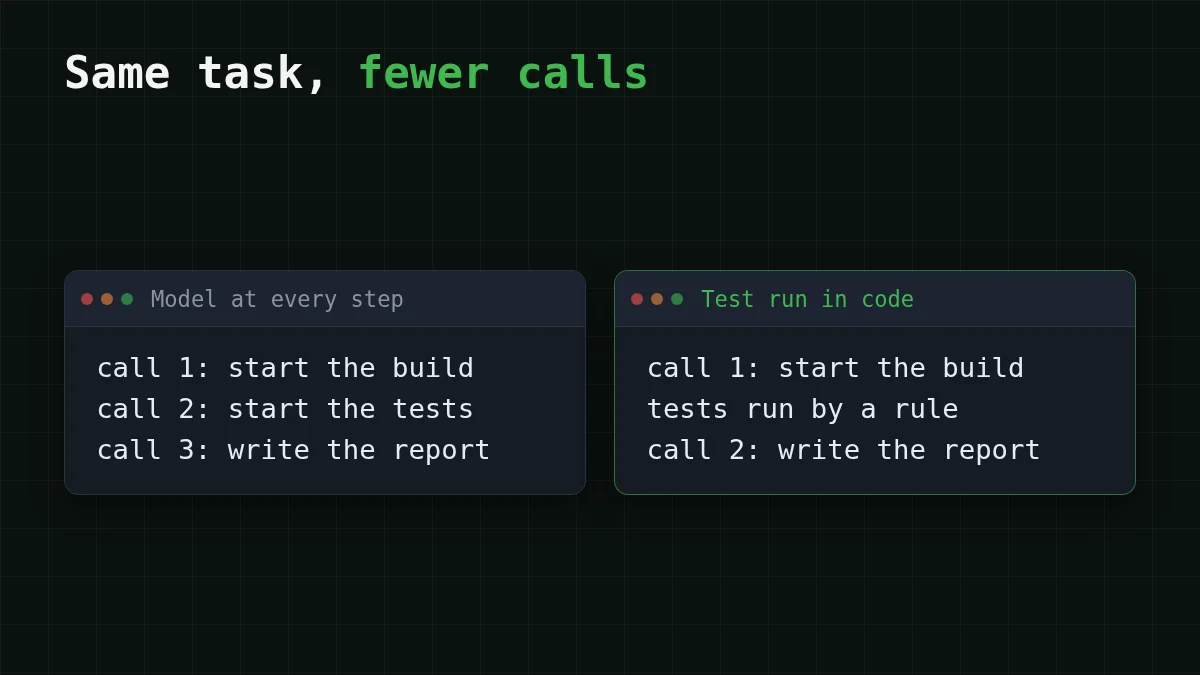
टेस्ट रन कोड में। कॉल 1 3,000 टोकन पढ़ता है। हार्नेस बिल्ड चलाता है, फिर नियम से टेस्ट, और कॉल 2 3,000 + 60 + 1,500 + 2,000 = 6,560 पढ़ता है। कुल इनपुट: 3,000 + 6,560 = 9,560 टोकन; आउटपुट: 60 + 300 = 360।
अंतर है 14,180 − 9,560 = 4,620 इनपुट टोकन, इनपुट का लगभग एक तिहाई, साथ में एक छोटा जवाब। DeepSeek-V4-Flash पर ऐसा एक काम पहले तरीके से $0.00025 और दूसरे से $0.00018 का पड़ता है। एक काम तो राउंडिंग एरर है। मान लें आपका एजेंट रोज़ 500 करता है (14,180 × 500 = 7,090,000 इनपुट टोकन, 420 × 500 = 210,000 आउटपुट टोकन बनाम 4,780,000 और 180,000):
अंतर कॉन्टेक्स्ट के साथ बढ़ता है: मॉडल जितने लंबे लॉग घसीटता है, छोड़ा गया दोबारा-पढ़ना उतना ही क़ीमती। यहाँ वही लूप साथ-साथ:
कोड में, नियम कुछ पंक्तियाँ है। यह स्यूडो-कोड है, हेल्पर नाम आपके:
result = run_tool(call)              # the model asked for: make build
messages.append(tool_message(result))

if call.name == "build" and result.exit_code == 0:
    tests = run_tool("make test")    # fixed rule, no model call
    messages.append(tool_message(tests))
# anything else (build failed, odd output) goes back to the model

reply = call_model(messages)         # the model reads everything once
HarnessMM के लेखक क्या बताते हैं#
यह विचार केवल हमारा नहीं है। HarnessMM arXiv पर एक प्रीप्रिंट है (arXiv:2610.32813, 23 अक्टूबर 2026 को सबमिट, 2 नवंबर 2026 को जाँचा) Yuhua Jiang, Chang Xu, Feifei Gao और Li Zhao द्वारा। उनका अवलोकन: एजेंट हार्नेस अक्सर टूल फ़ीडबैक के बाद मॉडल को फिर से कॉल करते हैं, भले ही पहले के किसी कॉल ने अगली क्रिया पहले ही तय कर दी हो। उनका समाधान, guarded decision reuse, उस फैसले को दोबारा चलाता है और मूल मॉडल पर तब लौटता है जब नया अर्थपूर्ण फैसला आए, साक्ष्य असमर्थित हो या सेलेक्टर अनुपस्थित रहे। ऊपर का if उसी विचार का हाथ से लिखा संस्करण है; उनका गार्ड कैसे तय करता है, वह पेपर में है।
लेखक HumanEval पर ये परिणाम बताते हैं:
- Codex हार्नेस: 66.72k → 47.02k टोकन प्रति काम (−29.54%), सफलता 90.82% पर अपरिवर्तित।
- DeepSeek Harness: 96.28k → 11.62k टोकन प्रति काम (−87.93%), सफलता 71.43% → 85.71%।
इन्हें सावधानी से पढ़ें। यह एक बेंचमार्क है, लेखकों का अपना हार्नेस, एक प्रीप्रिंट जो पीयर-रिव्यू नहीं हुआ, और arXiv पेज पर कोई कोड नहीं है। आपको दोबारा सुनाए जाने में "88%" दिख सकता है: वह केवल DeepSeek Harness का आँकड़ा है, Codex वाला लगभग 30% है। दोनों को दिशा मानें, अपने एजेंट के लिए वादा नहीं। आपका अपना लॉग आपको ज़्यादा बताता है।
अपने एजेंट को दस मिनट में जाँचें#
हर मॉडल कॉल का लॉग चालू करें, हर जवाब से usage संख्याओं के साथ (Python में एजेंट टोकन लागत ट्रैक करना एक तरीका दिखाता है)। फिर पिछले बीस रन पढ़ें और हर कॉल को चिह्नित करें: फैसला या तय। कोई कॉल उम्मीदवार है जब उन रनों में अगली क्रिया कभी नहीं बदली। आपका लॉग क्या दिखाता है?
अपना मामला चुनें
आपका लॉग क्या दिखाता है?
उत्तर देखने के लिए एक विकल्प चुनें
हर रन में कॉल की वही जोड़ी
वहाँ एक तय नियम छिपा है। इसे किसी स्पष्ट संकेत पर if के रूप में लिखें, जैसे exit code, और जब संकेत कुछ अप्रत्याशित हो तो मॉडल को फ़ॉलबैक रखें।
ऐसे कॉल जो केवल टूल आउटपुट को फिर से फ़ॉर्मेट या कॉपी करते हैं
उन्हें कोड में टेम्पलेट में ले जाएँ। अगर टेक्स्ट को सचमुच मॉडल चाहिए, तो वह सस्ते मॉडल का छोटा काम है, आपके सबसे बड़े का नहीं।
ऐसे कॉल जहाँ अगला कदम सामग्री के साथ बदलता है
मॉडल यहीं रखें। इसी के लिए वह है, और एक सस्ता मॉडल अक्सर सादा classify-and-pick कदम संभाल लेता है; देखें मॉडल रूटिंग: पहले सस्ता मॉडल।
हर कॉल एक बड़ा लॉग दोबारा पढ़ता है
जो बातचीत में वापस जाता है उसे छाँटें: टूल आउटपुट को कॉन्टेक्स्ट से बाहर रखें। कोई कॉल हटाए बिना वही काम सस्ता हो जाता है।
अगर आप इसे लंबे कॉन्टेक्स्ट वाले मॉडल पर आज़माना चाहते हैं, तो CheapTokens एजेंट लूप के लिए DeepSeek-V4-Flash (deepseek-) देता है: किसी भी घंटे एक कीमत, 380K कॉन्टेक्स्ट और प्रति जवाब 32,768 आउटपुट टोकन तक। जिन कदमों को अब भी फैसला चाहिए उनके लिए GLM-5.3-Flash (zai-) है, 390K कॉन्टेक्स्ट के साथ। दोनों https:/ पर OpenAI- और Anthropic-संगत API से काम करते हैं, सभी मॉडलों के लिए एक बैलेंस। सेटअप डॉक्स में है, कीमतें प्राइसिंग पेज पर हैं, और मॉडल पेज है सस्ता DeepSeek।


