AI สำหรับผู้เริ่มต้นคู่มือ
เอเจนต์ต้องใช้โมเดลในทุกขั้นตอนไหม? ใส่ขั้นตอนตายตัวลงในโค้ด
ทำไมผลลัพธ์เครื่องมือทุกครั้งจึงกระตุ้นการเรียกโมเดลอีกครั้ง ขั้นตอนไหนของเอเจนต์เป็นโค้ดธรรมดาได้ และลูป 3 ขั้นตอนมีค่าใช้จ่ายเท่าไรเมื่อมีและไม่มีการเรียกเพิ่ม
ในหน้านี้
เอเจนต์ของคุณรันไปสิบนาที แล้วบิลก็แพ้งานเสียอีก บ่อยครั้งเหตุผลมันน่าเบื่อมาก: หลังผลลัพธ์ของเครื่องมือทุกครั้ง harness จะเรียกโมเดลอีกครั้ง แม้ขั้นตอนถัดไปจะชัดเจนอยู่แล้ว
ดังนั้นไม่ เอเจนต์ไม่จำเป็นต้องใช้โมเดลในทุกขั้นตอน มันต้องใช้โมเดลในจุดที่ต้องมีอะไรบางอย่าง ถูกตัดสินใจ ขั้นตอนที่เหมือนเดิมเสมอ เช่นการรันเทสต์หลังบิลด์ที่ผ่านแล้ว สามารถเป็นกฎธรรมดาในโค้ดของคุณได้
มีเหตุผลด้านเงินที่ต้องใส่ใจ การเรียกเพิ่มแต่ละครั้งอ่าน context ทั้งหมดใหม่เป็น input tokens (บทความเรื่องแชทยาว อธิบายว่าทำไม) ดังนั้นการข้ามการเรียกหนึ่งครั้งประหยัดได้มากกว่าคำตอบสั้น ๆ ของมันเอง ถ้าลูปนี้ยังใหม่สำหรับคุณ เริ่มจาก เอเจนต์ AI ทำงานอย่างไร แล้วค่อยกลับมา
ทำไมผลลัพธ์เครื่องมือหนึ่งครั้งจึงหมายถึงการเรียกโมเดลอีกครั้ง#
โมเดลไม่เคยรันอะไรเลย มันเขียนว่า "กรุณารัน make build" harness ของคุณ (โปรแกรมที่ห่อหุ้มโมเดล) รันมัน วางผลลัพธ์ลงในบทสนทนา แล้วเรียกโมเดลอีกครั้งพร้อมทุกอย่างที่ผ่านมา นั่นคือลูปทั้งหมด โมเดลจะรู้ว่าครื่องมือคืนอะไรก็ต่อเมื่อคุณเรียกมัน
ลองนึกถึงเพื่อนร่วมงานใหม่ที่โทรหาผู้จัดการหลังทุกขั้นตอนเพื่อถามว่า "แล้วไงต่อ?" ทั้งที่เช็กลิสต์บอกว่า "หลังคอมไพล์ ให้รันเทสต์" ผู้จัดการตอบเหมือนเดิมทุกครั้ง และทุกการเรียกเสียเวลาหนึ่งนาทีในการอ่านเรื่องทั้งหมดตั้งแต่ต้น
นี่คือหน้าตาใน log ของเอเจนต์ สมมติว่างานคือ "แก้เทสต์ที่พัง":
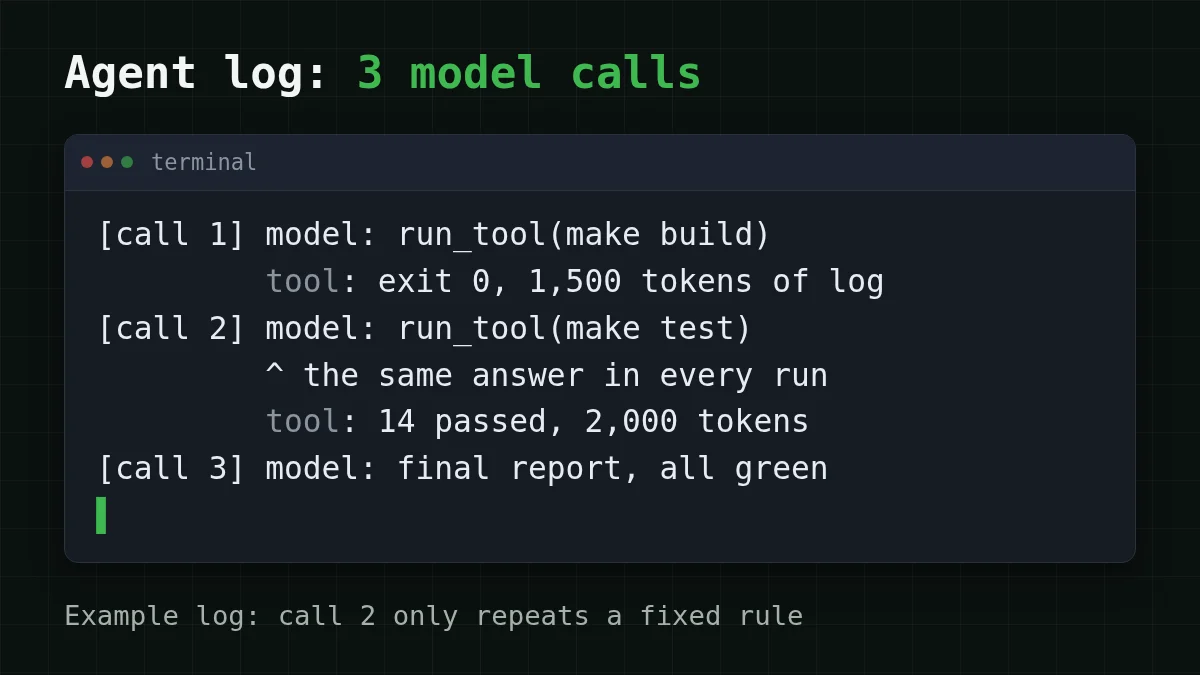
การเรียกครั้งที่ 2 คือจุดที่น่าสนใจ บิลด์ผ่าน ขั้นตอนถัดไปคือเทสต์เสมอ และโมเดลใช้การอ่าน context เต็มรอบเพื่อพูดว่า "รันเทสต์" การเรียกครั้งที่ 1 และ 3 ต่างออกไป: ครั้งที่ 1 เลือกวิธีเริ่ม ครั้งที่ 3 อ่านผลเทสต์และเขียนรายงาน นั่นคืองานจริง
ขั้นตอนไหนต้องตัดสินใจ และขั้นตอนไหนตายตัว#
สามคำถามคัดแยกขั้นตอนส่วนใหญ่ได้:
- การกระทำถัดไปถูกกำหนดโดยสัญญาณชัดเจน เช่น exit code, HTTP status หรือ "เจอ / ไม่เจอ" หรือไม่?
- เป็นการกระทำเดิมทุกครั้งที่สัญญาณนั้นปรากฏหรือไม่?
- การเดาผิดแก้ไขได้ถูกหรือไม่?
ตอบใช่ทั้งสามข้อ: เขียนเป็นกฎ ไม่อย่างนั้นโมเดลยังคงถือขั้นตอนนั้น
ตัวอย่างที่สอง นอกเหนือจากการเขียนโค้ด สมมติคุณรันสคริปต์ซัพพอร์ต: ลูกค้าเขียนเข้ามา สคริปต์ค้นหาคำสั่งซื้อ แล้วตอบ การค้นหาคำสั่งซื้อด้วยหมายเลขเป็นโค้ด การเติม "คำสั่งซื้อ {id} ของคุณคือ {status}" จากเทมเพลตก็เป็นโค้ดเช่นกัน การอ่าน "มันมาถึงแตก หาทำไงต่อ?" แล้วเลือกระหว่างคืนเงิน เปลี่ยนสินค้า หรือขอโทษ คือการตัดสินใจ ดังนั้นนั่นคือการเรียกโมเดลหนึ่งครั้ง ไม่ใช่สามครั้ง
จับคู่
ใครควรจัดการแต่ละขั้นตอน?
แตะรายการทางซ้าย แล้วแตะคู่ของมัน
- บิลด์เสร็จด้วย exit code 0 และขั้นตอนถัดไปคือเทสต์เสมอโค้ด: ขั้นตอนถัดไปตายตัว
- เทสต์ล้มเหลวพร้อม stack trace; ไฟล์ไหนต้องแก้?โมเดล: การตัดสินใจใหม่
- เจอคำสั่งซื้อด้วยหมายเลข ตอนนี้ใส่สถานะลงในเทมเพลตตอบกลับโค้ด: เติมเทมเพลต
- ลูกค้าเขียน "มันมาถึงแตก หาทำไงต่อ?"โมเดล: อ่านข้อความอิสระ
มีตัวป้องกันหนึ่งอย่างที่ทำให้ปลอดภัย: กฎครอบคลุมเฉพาะเส้นทางปกติ บิลด์ล้มเหลวด้วย exit code 1? เทสต์แดง? เครื่องมือคืนอะไรที่กฎไม่คาดคิด? ส่งคืนการควบคุมให้โมเดล เหมือนเดิมทุกประการ คุณกำลังลบการเรียกที่มีคำตอบเดียวที่เป็นไปได้ ไม่ใช่เอาโมเดลออกจากลูป
ลูป 3 ขั้นตอน มีและไม่มีการเรียกเพิ่ม#
มาใส่ตัวเลขให้ log "แก้เทสต์ที่พัง" กัน สมมติฐานทั้งหมดเป็นของเราและเปลี่ยนเป็นของคุณได้ง่าย:
- system prompt บวกงาน: 3,000 tokens
- build log: 1,500 tokens; test log: 2,000 tokens
- คำตอบที่แค่ขอเครื่องมือ: 60 tokens; รายงานสุดท้าย: 300 tokens
ทายตัวเลข
ถ้าการรันเทสต์ย้ายเข้าโค้ด ลูปจะเรียกโมเดลกี่ครั้ง?
คำตอบของคุณ
06
แสดงคำตอบ
คำตอบ: 2
สองครั้ง: ครั้งหนึ่งเพื่อเริ่มบิลด์ อีกครั้งเพื่ออ่านผลทั้งสองและเขียนรายงาน การรันเทสต์ไม่ต้องตัดสินใจอีกต่อไป
โมเดลในทุกขั้นตอน การเรียกครั้งที่ 1 อ่าน 3,000 tokens การเรียกครั้งที่ 2 อ่าน 3,000 + 60 + 1,500 = 4,560 การเรียกครั้งที่ 3 อ่าน 4,560 + 60 + 2,000 = 6,620 input รวม: 3,000 + 4,560 + 6,620 = 14,180 tokens; output: 60 + 60 + 300 = 420
รันเทสต์ในโค้ด การเรียกครั้งที่ 1 อ่าน 3,000 tokens harness รันบิลด์ แล้วรันเทสต์ตามกฎ และการเรียกครั้งที่ 2 อ่าน 3,000 + 60 + 1,500 + 2,000 = 6,560 input รวม: 3,000 + 6,560 = 9,560 tokens; output: 60 + 300 = 360
ผลต่างคือ 14,180 − 9,560 = 4,620 input tokens ประมาณหนึ่งในสามของ input บวกคำตอบเล็ก ๆ หนึ่งอัน บน DeepSeek-V4-Flash งานแบบนี้หนึ่งครั้งมีค่าใช้จ่าย $0.00025 วิธีแรก และ $0.00018 วิธีที่สอง งานหนึ่งชิ้นเป็นแค่ความคลาดเคลื่อนจากการปัดเศษ สมมติเอเจนต์ของคุณทำ 500 งานต่อวัน (14,180 × 500 = 7,090,000 input tokens, 420 × 500 = 210,000 output tokens เทียบกับ 4,780,000 และ 180,000):
ช่องว่างเพิ่มขึ้นตาม context: ยิ่ง log ยาวที่โมเดลลากตามมาเท่าไร การข้ามการอ่านซ้ำก็ยิ่งคุ้มค่ามากขึ้นเท่านั้น นี่คือลูปเดียวกันวางเทียบกัน:
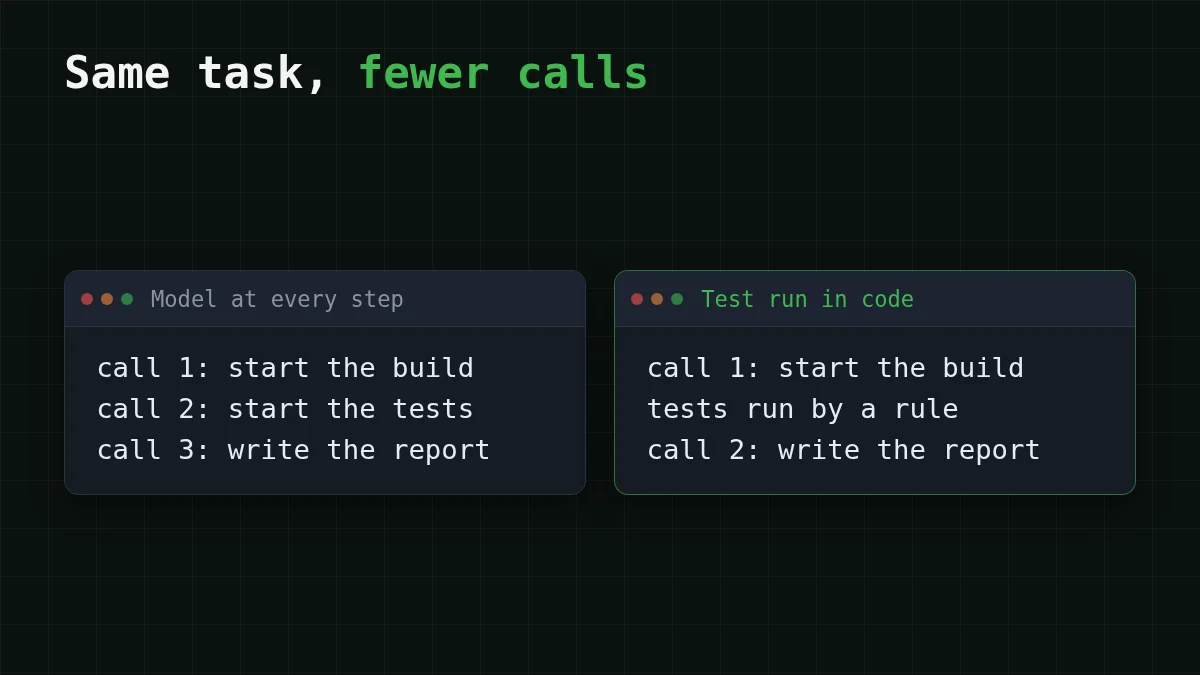
ในโค้ด กฎคือไม่กี่บรรทัด นี่คือ pseudo-code ชื่อ helper เป็นของคุณ:
result = run_tool(call)              # the model asked for: make build
messages.append(tool_message(result))

if call.name == "build" and result.exit_code == 0:
    tests = run_tool("make test")    # fixed rule, no model call
    messages.append(tool_message(tests))
# anything else (build failed, odd output) goes back to the model

reply = call_model(messages)         # the model reads everything once
ผู้เขียน HarnessMM รายงานอะไร#
แนวคิดนี้ไม่ใช่แค่ของเรา HarnessMM เป็น preprint บน arXiv (arXiv:2610.32813 ส่งเมื่อ 23 ตุลาคม 2026 ตรวจสอบเมื่อ 2 พฤศจิกายน 2026) โดย Yuhua Jiang, Chang Xu, Feifei Gao และ Li Zhao ข้อสังเกตของพวกเขา: harness ของเอเจนต์มักเรียกโมเดลอีกครั้งหลังผลตอบกลับจากเครื่องมือ แม้การเรียกก่อนหน้าจะกำหนดการกระทำถัดไปไว้แล้วก็ตาม วิธีแก้ของพวกเขา คือ guarded decision reuse จะเล่นการตัดสินใจนั้นซ้ำและถอยกลับไปใช้โมเดลเดิมเมื่อมีการตัดสินใจเชิงความหมายใหม่ปรากฏ หลักฐานไม่สนับสนุน หรือ selector ไม่เลือก if ข้างต้นคือเวอร์ชันที่เขียนด้วยมือของแนวคิดเดียวกัน ตัวป้องกันของพวกเขาตัดสินใจอย่างไรอยู่ในบทความ
ผู้เขียนรายงานผลลัพธ์เหล่านี้บน HumanEval:
- Codex harness: 66.72k → 47.02k tokens ต่องาน (−29.54%) ความสำเร็จคงเดิมที่ 90.82%
- DeepSeek Harness: 96.28k → 11.62k tokens ต่องาน (−87.93%) ความสำเร็จ 71.43% → 85.71%
อ่านอย่างระวัง มันเป็น benchmark เดียว harness ของผู้เขียนเอง preprint ที่ยังไม่ผ่าน peer review และหน้า arXiv ไม่ได้ระบุโค้ด คุณอาจเห็น "88%" ในบทความที่เล่าต่อ: นั่นคือตัวเลขของ DeepSeek Harness เท่านั้น ส่วน Codex อยู่ที่ประมาณ 30% มองทั้งสองเป็นทิศทาง ไม่ใช่คำสัญญาสำหรับเอเจนต์ของคุณ log ของคุณเองบอกได้มากกว่า
ตรวจเอเจนต์ของคุณเองในสิบนาที#
เปิด log ของทุกการเรียกโมเดล พร้อมตัวเลข usage จากแต่ละ response (การติดตามค่าใช้จ่าย token ของเอเจนต์ใน Python แสดงวิธีหนึ่ง) จากนั้นอ่านยี่สิบรันล่าสุดและทำเครื่องหมายแต่ละการเรียก: ตัดสินใจ หรือ ตายตัว การเรียกหนึ่งครั้งเป็นตัวเลือกเมื่อการกระทำถัดไปไม่เคยเปลี่ยนตลอดรันเหล่านั้น log ของคุณแสดงอะไร?
เลือกกรณีของคุณ
log ของคุณแสดงอะไร?
เลือกตัวเลือกเพื่อดูคำตอบ
การเรียกคู่เดิมในทุกการรัน
มีกฎตายตัวซ่อนอยู่ตรงนั้น เขียนมันเป็น if บนสัญญาณชัดเจน เช่น exit code และเก็บโมเดลไว้เป็น fallback เมื่อสัญญาณเป็นอะไรที่ไม่คาดคิด
การเรียกที่แค่จัดรูปแบบใหม่หรือคัดลอกผลลัพธ์เครื่องมือ
ย้ายมันเข้าเทมเพลตในโค้ด ถ้าข้อความต้องการโมเดลจริง ๆ มันเป็นงานเล็กสำหรับโมเดลราคาถูก ไม่ใช่โมเดลใหญ่สุดของคุณ
การเรียกที่ขั้นตอนถัดไปเปลี่ยนตามเนื้อหา
เก็บโมเดลไว้ตรงนี้ นี่คือสิ่งที่มันมีไว้ และโมเดลที่ถูกกว่ามักจัดการขั้นตอน classify-and-pick ธรรมดาได้ ดู model routing: โมเดลราคาถูกก่อน
ทุกการเรียกอ่าน log ขนาดใหญ่อีกครั้ง
ตัดสิ่งที่ส่งกลับเข้าบทสนทนา: เก็บผลลัพธ์เครื่องมือออกจาก context งานเดียวกันถูกลงโดยไม่ต้องลบการเรียกใด ๆ
ถ้าคุณอยากลองบนโมเดลที่มี context ยาว CheapTokens ให้บริการ DeepSeek-V4-Flash (deepseek-) สำหรับลูปเอเจนต์: ราคาเดียวทุกชั่วโมง context 380K และ output สูงสุด 32,768 tokens ต่อคำตอบ สำหรับขั้นตอนที่ยังต้องตัดสินใจมี GLM-5.3-Flash (zai-) พร้อม context 390K ทั้งคู่ทำงานผ่าน API ที่เข้ากันได้กับ OpenAI และ Anthropic ที่ https:/ ด้วยยอดเงินเดียวสำหรับทุกโมเดล การตั้งค่าอยู่ใน docs ราคาอยู่ที่ หน้าค่าบริการ และหน้าโมเดลคือ DeepSeek ราคาถูก


