IA pour débutantsGuide
Les agents ont-ils besoin du modèle à chaque étape ? Mettez les étapes fixes dans le code
Pourquoi chaque résultat d'outil déclenche un nouvel appel de modèle, quelles étapes d'agent peuvent être du code simple, et ce que coûte une boucle en 3 étapes avec et sans l'appel supplémentaire.
Sur cette page
Votre agent a tourné pendant dix minutes, et la facture dépasse la tâche. Très souvent, la raison est banale : après chaque résultat d'outil, le harnais rappelle le modèle, même quand l'étape suivante était évidente.
Donc non, un agent n'a pas besoin du modèle à chaque étape. Il a besoin du modèle là où quelque chose doit être décidé. Une étape qui est toujours la même, comme lancer les tests après un build réussi, peut être une simple règle dans votre code.
Il y a une raison financière de s'en soucier. Chaque appel supplémentaire relit tout le contexte en tokens d'entrée (l'article sur les longues conversations explique pourquoi), donc un appel évité économise plus que sa propre réponse courte. Si la boucle elle-même est nouvelle pour vous, commencez par comment fonctionne un agent IA et revenez.
Pourquoi un résultat d'outil signifie un appel de modèle de plus#
Le modèle n'exécute jamais rien. Il écrit « veuillez exécuter make build », votre harnais (le programme autour du modèle) l'exécute, colle la sortie dans la conversation et rappelle le modèle avec tout ce qui précède. C'est toute la boucle. Le modèle n'apprend ce qu'un outil a renvoyé que lorsque vous l'appelez.
Pensez à un nouveau collègue qui téléphone au manager après chaque étape pour demander « et maintenant ? », alors que la checklist dit « après compilation, lancer les tests ». Le manager répond la même chose à chaque fois, et chaque appel coûte une minute à relire toute l'histoire depuis le début.
Voici à quoi cela ressemble dans un journal d'agent. Disons que la tâche est « corriger le test qui échoue » :
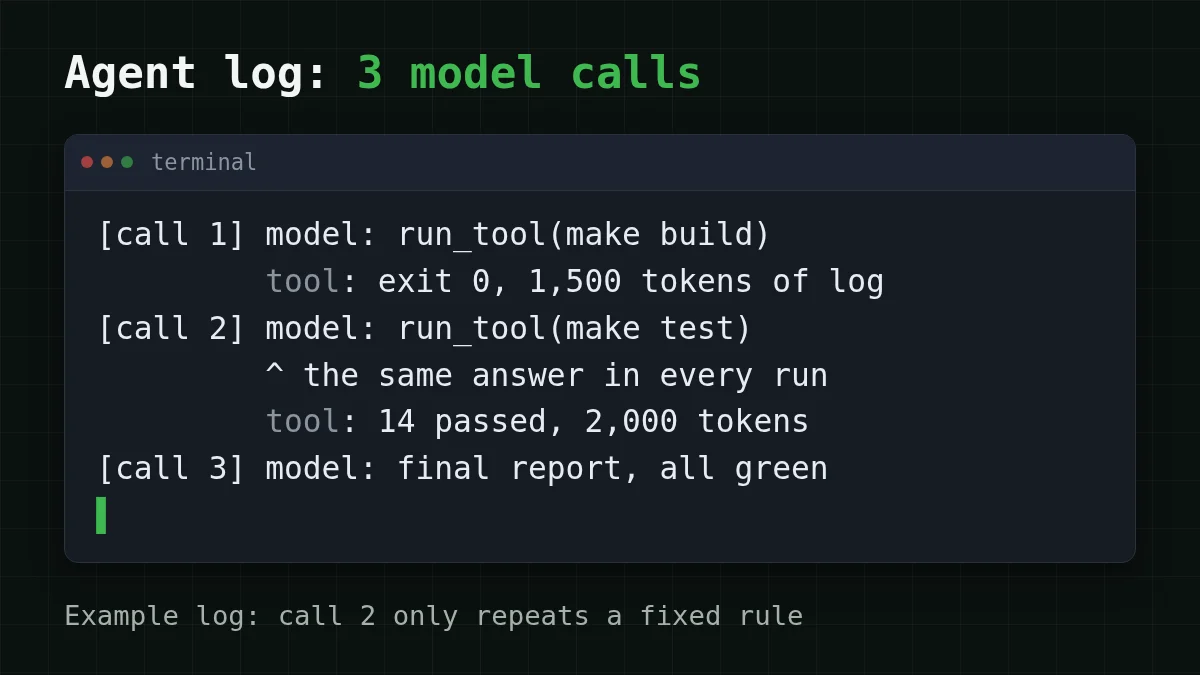
L'appel 2 est le plus intéressant. Le build a réussi, l'étape suivante est toujours les tests, et le modèle passe une lecture complète du contexte pour dire « lancer les tests ». Les appels 1 et 3 sont différents : l'appel 1 choisit comment démarrer, l'appel 3 lit les résultats des tests et rédige le rapport. C'est du vrai travail.
Quelles étapes nécessitent une décision et lesquelles sont fixes#
Trois questions trient la plupart des étapes :
- L'action suivante est-elle décidée par un signal clair, comme un code de sortie, un statut HTTP ou « trouvé / non trouvé » ?
- Est-ce la même action à chaque fois que ce signal apparaît ?
- Une mauvaise supposition est-elle peu coûteuse à annuler ?
Trois oui : écrivez-la comme une règle. Sinon, le modèle garde l'étape.
Un deuxième exemple, hors du code. Disons que vous avez un script de support : un client écrit, le script recherche la commande, puis répond. Rechercher la commande par son numéro, c'est du code. Remplir « Votre commande {id} est {status} » à partir d'un modèle, c'est aussi du code. Lire « il est arrivé cassé, et maintenant ? » et choisir entre un remboursement, un remplacement et des excuses est un jugement, donc c'est un appel de modèle, pas trois.
Associer les paires
Qui devrait gérer chaque étape ?
Touchez un élément à gauche, puis sa paire
- Le build s'est terminé avec le code de sortie 0, et l'étape suivante est toujours les testsCode : l'étape suivante est fixe
- Les tests ont échoué avec une trace de pile ; quel fichier doit être modifié ?Modèle : un nouveau jugement
- Commande trouvée par numéro, maintenant insérer son statut dans le modèle de réponseCode : remplir le modèle
- Le client écrit « il est arrivé cassé, et maintenant ? »Modèle : lire du texte libre
Une garde rend cela sûr : la règle ne couvre que le chemin heureux. Le build a échoué avec le code de sortie 1 ? Les tests sont rouges ? Un outil a renvoyé quelque chose que la règle n'attendait pas ? Rendez le contrôle au modèle, exactement comme avant. Vous supprimez des appels qui n'avaient qu'une seule réponse possible, pas le modèle de la boucle.
Une boucle en 3 étapes, avec et sans l'appel supplémentaire#
Mettons des chiffres sur le journal « corriger le test qui échoue ». Les hypothèses, toutes les nôtres et faciles à remplacer par les vôtres :
- prompt système plus tâche : 3 000 tokens
- journal de build : 1 500 tokens ; journal de tests : 2 000 tokens
- une réponse qui ne fait que demander un outil : 60 tokens ; le rapport final : 300 tokens
Devinez le nombre
Si l'exécution des tests passe dans le code, combien d'appels de modèle la boucle fait-elle ?
Votre estimation
06
Afficher la réponse
Réponse: 2
Deux : un pour démarrer le build, un pour lire les deux résultats et rédiger le rapport. L'exécution des tests ne nécessite plus de décision.
Modèle à chaque étape. L'appel 1 lit 3 000 tokens. L'appel 2 lit 3 000 + 60 + 1 500 = 4 560. L'appel 3 lit 4 560 + 60 + 2 000 = 6 620. Entrée au total : 3 000 + 4 560 + 6 620 = 14 180 tokens ; sortie : 60 + 60 + 300 = 420.
Exécution des tests dans le code. L'appel 1 lit 3 000 tokens. Le harnais lance le build, puis les tests par règle, et l'appel 2 lit 3 000 + 60 + 1 500 + 2 000 = 6 560. Entrée au total : 3 000 + 6 560 = 9 560 tokens ; sortie : 60 + 300 = 360.
La différence est de 14 180 − 9 560 = 4 620 tokens d'entrée, environ un tiers de l'entrée, plus une petite réponse. Sur DeepSeek-V4-Flash, une telle tâche coûte $0.00025 de la première façon et $0.00018 de la seconde. Une tâche est une erreur d'arrondi. Disons que votre agent en fait 500 par jour (14 180 × 500 = 7 090 000 tokens d'entrée, 420 × 500 = 210 000 tokens de sortie contre 4 780 000 et 180 000) :
L'écart grandit avec le contexte : plus les journaux que le modèle traîne sont longs, plus une relecture évitée vaut cher. Voici la même boucle côte à côte :
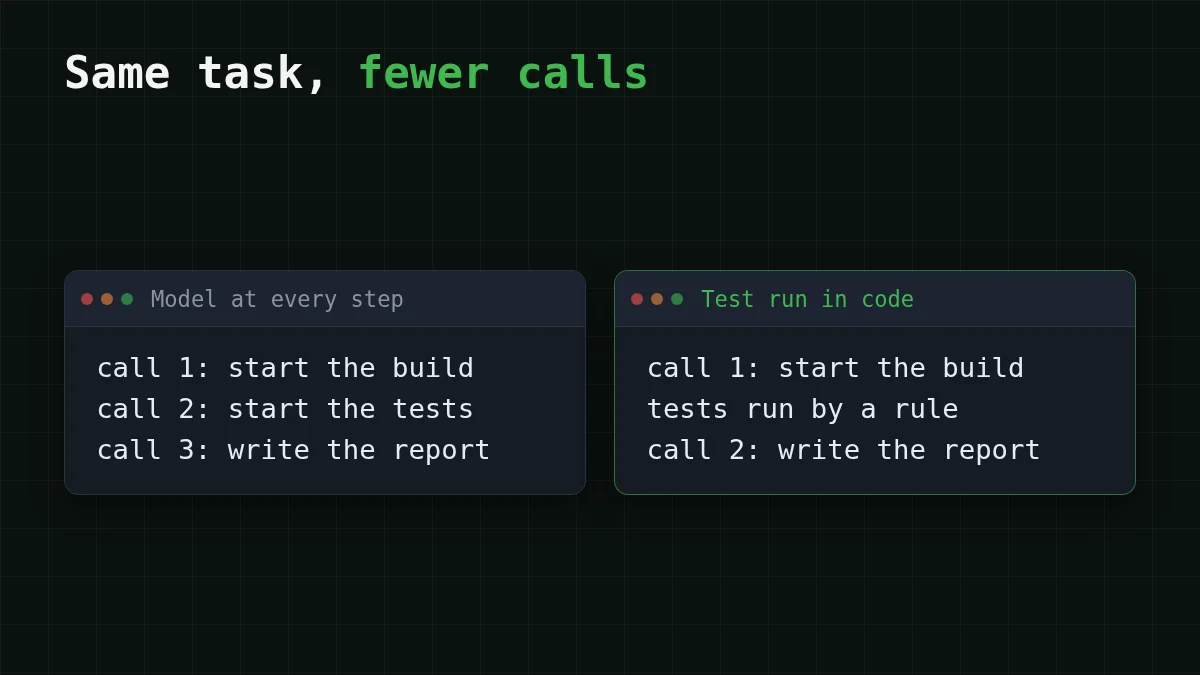
Dans le code, la règle tient en quelques lignes. Ceci est du pseudo-code, les noms des helpers sont les vôtres :
result = run_tool(call)              # the model asked for: make build
messages.append(tool_message(result))

if call.name == "build" and result.exit_code == 0:
    tests = run_tool("make test")    # fixed rule, no model call
    messages.append(tool_message(tests))
# anything else (build failed, odd output) goes back to the model

reply = call_model(messages)         # the model reads everything once
Ce que rapportent les auteurs de HarnessMM#
L'idée n'est pas seulement la nôtre. HarnessMM est une prépublication sur arXiv (arXiv:2610.32813, soumise le 23 octobre 2026, vérifiée le 2 novembre 2026) par Yuhua Jiang, Chang Xu, Feifei Gao et Li Zhao. Leur observation : les harnais d'agents rappellent souvent le modèle après le retour d'un outil, même quand un appel antérieur avait déjà déterminé l'action suivante. Leur correctif, la réutilisation gardée des décisions, rejoue cette décision et revient au modèle d'origine quand une nouvelle décision sémantique apparaît, que les preuves ne sont pas étayées ou que le sélecteur s'abstient. Le if ci-dessus est la version écrite à la main de la même idée ; la façon dont leur garde décide est dans l'article.
Les auteurs rapportent ces résultats sur HumanEval :
- Harnais Codex : 66,72k → 47,02k tokens par tâche (−29,54 %), succès inchangé à 90,82 %.
- DeepSeek Harness : 96,28k → 11,62k tokens par tâche (−87,93 %), succès 71,43 % → 85,71 %.
Lisez-les avec prudence. C'est un seul benchmark, le harnais des auteurs eux-mêmes, une prépublication non évaluée par les pairs, et la page arXiv ne liste aucun code. Vous verrez peut-être « 88 % » dans les reprises : c'est le chiffre de DeepSeek Harness uniquement, celui de Codex est d'environ 30 %. Traitez les deux comme une direction, pas comme une promesse pour votre agent. Votre propre journal vous en dit plus.
Vérifiez votre propre agent en dix minutes#
Activez un journal de chaque appel de modèle, avec les nombres usage de chaque réponse (suivre le coût en tokens d'un agent en Python en montre une façon). Ensuite, lisez les vingt dernières exécutions et marquez chaque appel : décision ou fixe. Un appel est candidat quand l'action suivante n'a jamais changé au fil de ces exécutions. Que montre votre journal ?
Choisissez votre cas
Que montre votre journal ?
Choisissez une option pour voir la réponse
La même paire d'appels à chaque exécution
Une règle fixe se cache là. Écrivez-la comme un if sur un signal clair, comme le code de sortie, et gardez le modèle comme repli quand le signal est inattendu.
Des appels qui ne font que reformater ou copier la sortie d'un outil
Déplacez-les dans un modèle en code. Si le texte a vraiment besoin d'un modèle, c'est un petit travail pour un modèle bon marché, pas pour votre plus gros.
Des appels où l'étape suivante change avec le contenu
Gardez le modèle ici. C'est fait pour ça, et un modèle moins cher gère souvent une simple étape de classification et de choix ; voir routage de modèles : modèle bon marché d'abord.
Chaque appel relit un énorme journal
Réduisez ce qui revient dans la conversation : garder la sortie des outils hors du contexte. La même tâche devient moins chère sans supprimer aucun appel.
Si vous voulez essayer cela sur un modèle à long contexte, CheapTokens sert DeepSeek-V4-Flash (deepseek-) pour les boucles d'agents : un prix à toute heure, 380K de contexte et jusqu'à 32 768 tokens de sortie par réponse. Pour les étapes qui nécessitent encore une décision, il y a GLM-5.3-Flash (zai-) avec un contexte de 390K. Les deux fonctionnent via l'API compatible OpenAI et Anthropic à https:/, avec un seul solde pour tous les modèles. La configuration est dans la documentation, les prix sont sur la page de tarification, et la page du modèle est DeepSeek pas cher.


