KI für EinsteigerAnleitung
Brauchen Agenten das Modell bei jedem Schritt? Feste Schritte in Code auslagern
Warum jedes Tool-Ergebnis einen weiteren Modellaufruf auslöst, welche Agent-Schritte einfacher Code sein können und was eine 3-Schritt-Schleife mit und ohne den zusätzlichen Aufruf kostet.
Auf dieser Seite
Dein Agent lief zehn Minuten, und die Rechnung ist größer als die Aufgabe. Sehr oft ist der Grund banal: Nach jedem Tool-Ergebnis ruft das Harness das Modell erneut auf, selbst wenn der nächste Schritt offensichtlich war.
Also nein, ein Agent braucht das Modell nicht bei jedem Schritt. Er braucht das Modell dort, wo etwas entschieden werden muss. Ein Schritt, der immer gleich ist, etwa das Ausführen der Tests nach einem erfolgreichen Build, kann eine einfache Regel in deinem Code sein.
Es gibt einen finanziellen Grund, sich darum zu kümmern. Jeder zusätzliche Aufruf liest den gesamten Kontext erneut als Input-Tokens (der Long-Chat-Artikel zeigt, warum), ein übersprungener Aufruf spart also mehr als nur seine eigene kurze Antwort. Wenn dir die Schleife selbst neu ist, beginne mit wie ein KI-Agent funktioniert und komm dann zurück.
Warum ein Tool-Ergebnis einen weiteren Modellaufruf bedeutet#
Das Modell führt nie etwas aus. Es schreibt „bitte führe make build aus“, dein Harness (das Programm um das Modell herum) führt es aus, fügt die Ausgabe in die Konversation ein und ruft das Modell erneut mit allem bisherigen auf. Das ist die ganze Schleife. Das Modell erfährt nur, was ein Tool zurückgegeben hat, wenn du es aufrufst.
Denk an einen neuen Kollegen, der nach jedem einzelnen Schritt den Manager anruft und fragt „und jetzt?“, obwohl die Checkliste sagt „nach dem Kompilieren die Tests ausführen“. Der Manager antwortet jedes Mal dasselbe, und jeder Anruf kostet eine Minute, um die ganze Geschichte von vorne zu lesen.
So sieht das in einem Agent-Log aus. Nehmen wir an, die Aufgabe lautet „den fehlschlagenden Test reparieren“:
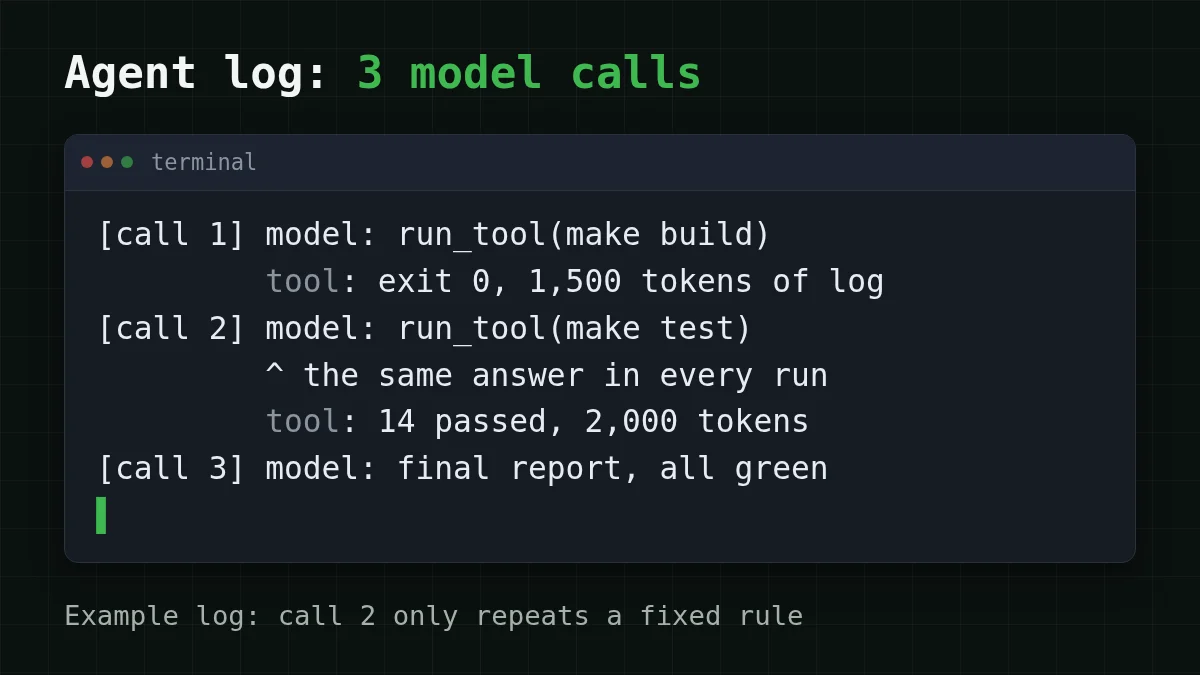
Aufruf 2 ist der interessante. Der Build war erfolgreich, der nächste Schritt sind immer die Tests, und das Modell verbringt ein vollständiges Lesen des Kontexts damit, „führe die Tests aus“ zu sagen. Aufruf 1 und Aufruf 3 sind anders: Aufruf 1 wählt, wie begonnen wird, Aufruf 3 liest die Testergebnisse und schreibt den Bericht. Das ist echte Arbeit.
Welche Schritte eine Entscheidung brauchen und welche fest sind#
Drei Fragen sortieren die meisten Schritte:
- Wird die nächste Aktion durch ein klares Signal entschieden, etwa einen Exit-Code, einen HTTP-Status oder „gefunden / nicht gefunden“?
- Ist es jedes Mal dieselbe Aktion, wenn dieses Signal erscheint?
- Ist eine falsche Vermutung günstig rückgängig zu machen?
Dreimal Ja: Schreib es als Regel. Andernfalls behält das Modell den Schritt.
Ein zweites Beispiel außerhalb des Programmierens. Nehmen wir an, du betreibst ein Support-Skript: Ein Kunde schreibt, das Skript schlägt die Bestellung nach und antwortet dann. Die Bestellung anhand ihrer Nummer nachzuschlagen ist Code. „Deine Bestellung {id} ist {status}“ aus einer Vorlage zu füllen ist ebenfalls Code. „Sie kam kaputt an, was jetzt?“ zu lesen und zwischen Erstattung, Ersatz und Entschuldigung zu wählen ist eine Beurteilung, also ein Modellaufruf, nicht drei.
Paare zuordnen
Wer sollte welchen Schritt übernehmen?
Tippe auf ein Element links, dann auf sein Paar
- Build mit Exit-Code 0 beendet, und der nächste Schritt sind immer die TestsCode: der nächste Schritt ist fest
- Tests mit einem Stack Trace fehlgeschlagen; welche Datei muss geändert werden?Modell: eine neue Beurteilung
- Bestellung anhand der Nummer gefunden, jetzt ihren Status in die Antwortvorlage einsetzenCode: die Vorlage füllen
- Kunde schreibt „Sie kam kaputt an, was jetzt?“Modell: Freitext lesen
Eine Absicherung macht das sicher: Die Regel deckt nur den Happy Path ab. Build mit Exit-Code 1 fehlgeschlagen? Tests rot? Ein Tool hat etwas zurückgegeben, das die Regel nicht erwartet hat? Gib die Kontrolle genau wie zuvor an das Modell zurück. Du entfernst Aufrufe, die nur eine mögliche Antwort hatten, nicht das Modell aus der Schleife.
Eine 3-Schritt-Schleife, mit und ohne den zusätzlichen Aufruf#
Setzen wir Zahlen auf das Log „den fehlschlagenden Test reparieren“. Die Annahmen, alle von uns und leicht durch deine zu ersetzen:
- System-Prompt plus Aufgabe: 3.000 Tokens
- Build-Log: 1.500 Tokens; Test-Log: 2.000 Tokens
- eine Antwort, die nur ein Tool anfordert: 60 Tokens; der Abschlussbericht: 300 Tokens
Zahl erraten
Wenn der Testlauf in den Code wandert, wie viele Modellaufrufe macht die Schleife?
Deine Schätzung
06
Antwort anzeigen
Antwort: 2
Zwei: einer, um den Build zu starten, einer, um beide Ergebnisse zu lesen und den Bericht zu schreiben. Der Testlauf braucht keine Entscheidung mehr.
Modell bei jedem Schritt. Aufruf 1 liest 3.000 Tokens. Aufruf 2 liest 3.000 + 60 + 1.500 = 4.560. Aufruf 3 liest 4.560 + 60 + 2.000 = 6.620. Input insgesamt: 3.000 + 4.560 + 6.620 = 14.180 Tokens; Output: 60 + 60 + 300 = 420.
Testlauf im Code. Aufruf 1 liest 3.000 Tokens. Das Harness führt den Build aus, dann per Regel die Tests, und Aufruf 2 liest 3.000 + 60 + 1.500 + 2.000 = 6.560. Input insgesamt: 3.000 + 6.560 = 9.560 Tokens; Output: 60 + 300 = 360.
Der Unterschied beträgt 14.180 − 9.560 = 4.620 Input-Tokens, etwa ein Drittel des Inputs, plus eine kleine Antwort. Auf DeepSeek-V4-Flash kostet eine solche Aufgabe auf die erste Art $0.00025 und auf die zweite $0.00018. Eine Aufgabe ist ein Rundungsfehler. Nehmen wir an, dein Agent erledigt 500 davon pro Tag (14.180 × 500 = 7.090.000 Input-Tokens, 420 × 500 = 210.000 Output-Tokens gegenüber 4.780.000 und 180.000):
Die Lücke wächst mit dem Kontext: Je länger die Logs sind, die das Modell mitschleppt, desto mehr ist ein übersprungenes erneutes Lesen wert. Hier ist dieselbe Schleife nebeneinander:
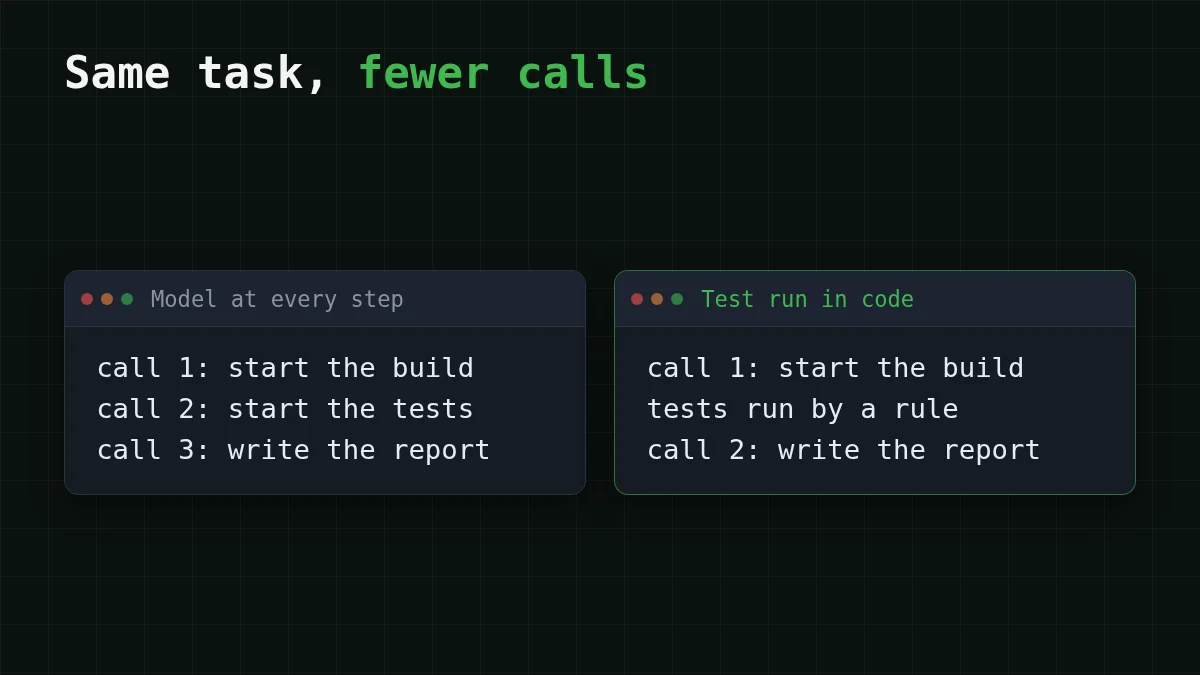
Im Code ist die Regel ein paar Zeilen. Das ist Pseudo-Code, die Helper-Namen sind deine:
result = run_tool(call)              # the model asked for: make build
messages.append(tool_message(result))

if call.name == "build" and result.exit_code == 0:
    tests = run_tool("make test")    # fixed rule, no model call
    messages.append(tool_message(tests))
# anything else (build failed, odd output) goes back to the model

reply = call_model(messages)         # the model reads everything once
Was die Autoren von HarnessMM berichten#
Die Idee ist nicht nur unsere. HarnessMM ist ein Preprint auf arXiv (arXiv:2610.32813, eingereicht am 23. Oktober 2026, geprüft am 2. November 2026) von Yuhua Jiang, Chang Xu, Feifei Gao und Li Zhao. Ihre Beobachtung: Agent-Harnesses rufen das Modell oft nach Tool-Feedback erneut auf, selbst wenn ein früherer Aufruf die nächste Aktion bereits bestimmt hat. Ihr Fix, Guarded Decision Reuse, spielt diese Entscheidung erneut ab und fällt auf das ursprüngliche Modell zurück, wenn eine neue semantische Entscheidung auftaucht, die Evidenz nicht gestützt wird oder der Selektor sich enthält. Das if oben ist die handgeschriebene Version derselben Idee; wie ihre Absicherung entscheidet, steht im Paper.
Die Autoren berichten diese Ergebnisse auf HumanEval:
- Codex-Harness: 66,72k → 47,02k Tokens pro Aufgabe (−29,54 %), Erfolg unverändert bei 90,82 %.
- DeepSeek Harness: 96,28k → 11,62k Tokens pro Aufgabe (−87,93 %), Erfolg 71,43 % → 85,71 %.
Lies sie mit Vorsicht. Es ist ein Benchmark, das eigene Harness der Autoren, ein Preprint, der nicht peer-reviewed ist, und die arXiv-Seite listet keinen Code. In Nacherzählungen siehst du vielleicht „88 %“: Das ist nur der Wert des DeepSeek Harness, der von Codex liegt bei etwa 30 %. Behandle beides als Richtung, nicht als Versprechen für deinen Agenten. Dein eigenes Log sagt dir mehr.
Prüfe deinen eigenen Agenten in zehn Minuten#
Aktiviere ein Log jedes Modellaufrufs mit den usage-Zahlen aus jeder Antwort (Token-Kosten von Agenten in Python verfolgen zeigt einen Weg). Lies dann die letzten zwanzig Läufe und markiere jeden Aufruf: Entscheidung oder fest. Ein Aufruf ist ein Kandidat, wenn sich die nächste Aktion über diese Läufe hinweg nie geändert hat. Was zeigt dein Log?
Wähle deinen Fall
Was zeigt dein Log?
Wähle eine Option, um die Antwort zu sehen
Dasselbe Aufrufpaar in jedem Lauf
Dort versteckt sich eine feste Regel. Schreib sie als if auf ein klares Signal, etwa den Exit-Code, und behalte das Modell als Fallback, wenn das Signal irgendetwas Unerwartetes ist.
Aufrufe, die nur Tool-Ausgaben umformatieren oder kopieren
Verschiebe sie in eine Vorlage im Code. Wenn der Text wirklich ein Modell braucht, ist es eine kleine Aufgabe für ein günstiges Modell, nicht für dein größtes.
Aufrufe, bei denen sich der nächste Schritt mit dem Inhalt ändert
Behalte das Modell hier. Dafür ist es da, und ein günstigeres Modell übernimmt oft einen einfachen Klassifizieren-und-Auswählen-Schritt; siehe Modell-Routing: günstiges Modell zuerst.
Jeder Aufruf liest ein riesiges Log erneut
Kürze, was zurück in die Konversation geht: Tool-Ausgaben aus dem Kontext heraushalten. Dieselbe Aufgabe wird günstiger, ohne einen Aufruf zu entfernen.
Wenn du das mit einem Modell mit langem Kontext ausprobieren willst, bietet CheapTokens DeepSeek-V4-Flash (deepseek-) für Agent-Schleifen an: ein Preis zu jeder Stunde, 380K Kontext und bis zu 32.768 Output-Tokens pro Antwort. Für die Schritte, die noch eine Entscheidung brauchen, gibt es GLM-5.3-Flash (zai-) mit einem 390K-Kontext. Beide laufen über die OpenAI- und Anthropic-kompatible API unter https:/, mit einem Guthaben für alle Modelle. Die Einrichtung steht in der Dokumentation, die Preise auf der Preisseite, und die Modellseite ist günstiges DeepSeek.


