AI 입문가이드
에이전트는 매 단계 모델이 필요할까? 고정 단계는 코드로
모든 도구 결과가 또 다른 모델 호출을 부르는 이유, 어떤 에이전트 단계가 단순 코드가 될 수 있는지, 그리고 3단계 루프가 추가 호출이 있을 때와 없을 때 얼마나 드는지.
이 페이지의 내용
에이전트가 10분 동안 실행됐는데, 청구서가 작업보다 큽니다. 이유는 대개 시시합니다. 모든 도구 결과 뒤에 하네스가 모델을 다시 호출하기 때문입니다. 다음 단계가 뻔한 경우에도요.
그래서 아닙니다, 에이전트가 모든 단계에서 모델을 필요로 하지는 않습니다. 모델이 필요한 곳은 무언가를 결정해야 하는 지점입니다. 통과한 빌드 후에 테스트를 실행하는 것처럼 항상 같은 단계는 코드의 단순한 규칙이 될 수 있습니다.
신경 쓸 금전적 이유가 있습니다. 추가 호출마다 전체 컨텍스트를 입력 토큰으로 다시 읽으므로(긴 대화 글에서 이유를 설명합니다), 건너뛴 호출은 자기 짧은 답변보다 더 많이 절약합니다. 루프 자체가 처음이라면 AI 에이전트의 작동 방식부터 읽고 돌아오세요.
도구 결과 하나가 모델 호출 하나를 더 부르는 이유#
모델은 아무것도 실행하지 않습니다. 모델은 "make build 실행해 주세요"라고 쓰고, 하네스(모델을 둘러싼 프로그램)가 그것을 실행해 출력을 대화에 붙여넣은 뒤 지금까지의 모든 내용과 함께 모델을 다시 호출합니다. 이것이 루프의 전부입니다. 모델은 호출할 때만 도구가 무엇을 반환했는지 알게 됩니다.
체크리스트에 "컴파일 후 테스트 실행"이라고 적혀 있는데도 매 단계마다 관리자에게 전화해 "이제 뭐 하죠?"라고 묻는 신입 동료를 생각해 보세요. 관리자는 매번 같은 대답을 하고, 매 호출은 처음부터 전체 이야기를 읽는 1분을 소모합니다.
에이전트 로그에서 보면 이렇습니다. 작업이 "실패하는 테스트 수정"이라고 해봅시다:
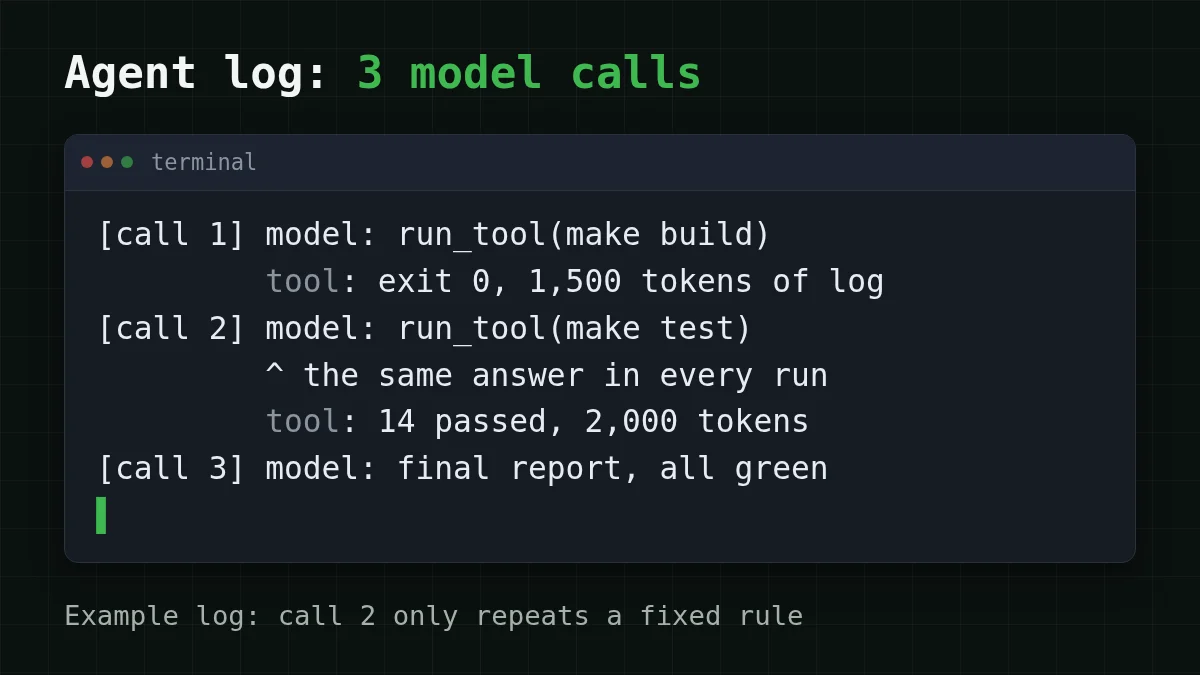
호출 2가 흥미롭습니다. 빌드가 통과했고 다음 단계는 항상 테스트이며, 모델은 "테스트를 실행하세요"라고 말하기 위해 컨텍스트를 통째로 읽는 데 비용을 씁니다. 호출 1과 호출 3은 다릅니다. 호출 1은 어떻게 시작할지 고르고, 호출 3은 테스트 결과를 읽고 보고서를 작성합니다. 이것들은 실제 작업입니다.
어떤 단계는 결정이 필요하고 어떤 단계는 고정인가#
세 가지 질문이 대부분의 단계를 분류합니다:
- 다음 행동이 종료 코드, HTTP 상태, 또는 "찾음 / 못 찾음" 같은 명확한 신호로 결정되는가?
- 그 신호가 나타날 때마다 항상 같은 행동인가?
- 잘못 추측해도 되돌리는 비용이 저렴한가?
세 가지 모두 예라면 규칙으로 작성하세요. 그렇지 않으면 모델이 그 단계를 맡습니다.
코딩 밖의 두 번째 예시입니다. 지원 스크립트를 운영한다고 해봅시다. 고객이 글을 남기면 스크립트가 주문을 조회한 뒤 답변합니다. 주문 번호로 주문을 조회하는 것은 코드입니다. 템플릿에서 "주문 {id}은(는) {status}입니다"를 채우는 것도 코드입니다. "깨진 채로 도착했는데 이제 어떻게 하죠?"를 읽고 환불, 교체, 사과 중에서 고르는 것은 판단이므로 모델 호출 한 번이지 세 번이 아닙니다.
짝 맞추기
각 단계를 누가 처리해야 할까?
왼쪽 항목을 탭한 다음 짝을 탭하세요
- 빌드가 종료 코드 0으로 끝났고 다음 단계는 항상 테스트코드: 다음 단계가 고정됨
- 테스트가 스택 트레이스와 함께 실패함; 어느 파일을 고쳐야 하나?모델: 새로운 판단
- 번호로 주문을 찾았으니 이제 그 상태를 답변 템플릿에 넣기코드: 템플릿 채우기
- 고객이 "깨진 채로 도착했는데 이제 어떻게 하죠?"라고 씀모델: 자유 텍스트 읽기
이를 안전하게 만드는 가드가 하나 있습니다. 규칙은 정상 경로만 다룹니다. 빌드가 종료 코드 1로 실패했나요? 테스트가 빨간불인가요? 도구가 규칙이 예상하지 못한 것을 반환했나요? 그렇다면 이전과 똑같이 제어를 모델에 돌려주세요. 답이 하나뿐이었던 호출을 제거하는 것이지, 모델을 루프에서 빼는 것이 아닙니다.
3단계 루프, 추가 호출이 있을 때와 없을 때#
"실패하는 테스트 수정" 로그에 숫자를 붙여봅시다. 가정은 모두 우리 것이고 여러분의 것으로 쉽게 바꿀 수 있습니다:
- 시스템 프롬프트 + 작업: 3,000 토큰
- 빌드 로그: 1,500 토큰; 테스트 로그: 2,000 토큰
- 도구만 요청하는 답변: 60 토큰; 최종 보고서: 300 토큰
숫자 맞히기
테스트 실행이 코드로 옮겨지면 루프는 모델을 몇 번 호출할까?
내 추측
06
정답 보기
정답: 2
두 번: 한 번은 빌드를 시작하고, 한 번은 두 결과를 모두 읽고 보고서를 작성합니다. 테스트 실행은 더 이상 결정이 필요 없습니다.
매 단계 모델. 호출 1은 3,000 토큰을 읽습니다. 호출 2는 3,000 + 60 + 1,500 = 4,560을 읽습니다. 호출 3은 4,560 + 60 + 2,000 = 6,620을 읽습니다. 총 입력: 3,000 + 4,560 + 6,620 = 14,180 토큰; 출력: 60 + 60 + 300 = 420.
테스트 실행을 코드로. 호출 1은 3,000 토큰을 읽습니다. 하네스가 빌드를 실행한 뒤 규칙에 따라 테스트를 실행하고, 호출 2는 3,000 + 60 + 1,500 + 2,000 = 6,560을 읽습니다. 총 입력: 3,000 + 6,560 = 9,560 토큰; 출력: 60 + 300 = 360.
차이는 14,180 − 9,560 = 4,620 입력 토큰으로 입력의 약 3분의 1에 작은 답변 하나를 더한 것입니다. DeepSeek-V4-Flash에서 이런 작업 하나는 첫 번째 방식으로 $0.00025, 두 번째 방식으로 $0.00018입니다. 작업 하나는 반올림 오차입니다. 에이전트가 하루에 500개를 한다고 해봅시다(14,180 × 500 = 7,090,000 입력 토큰, 420 × 500 = 210,000 출력 토큰 대 4,780,000과 180,000):
격차는 컨텍스트와 함께 커집니다. 모델이 끌고 다니는 로그가 길수록 건너뛴 재읽기의 가치가 커집니다. 같은 루프를 나란히 보면 이렇습니다:
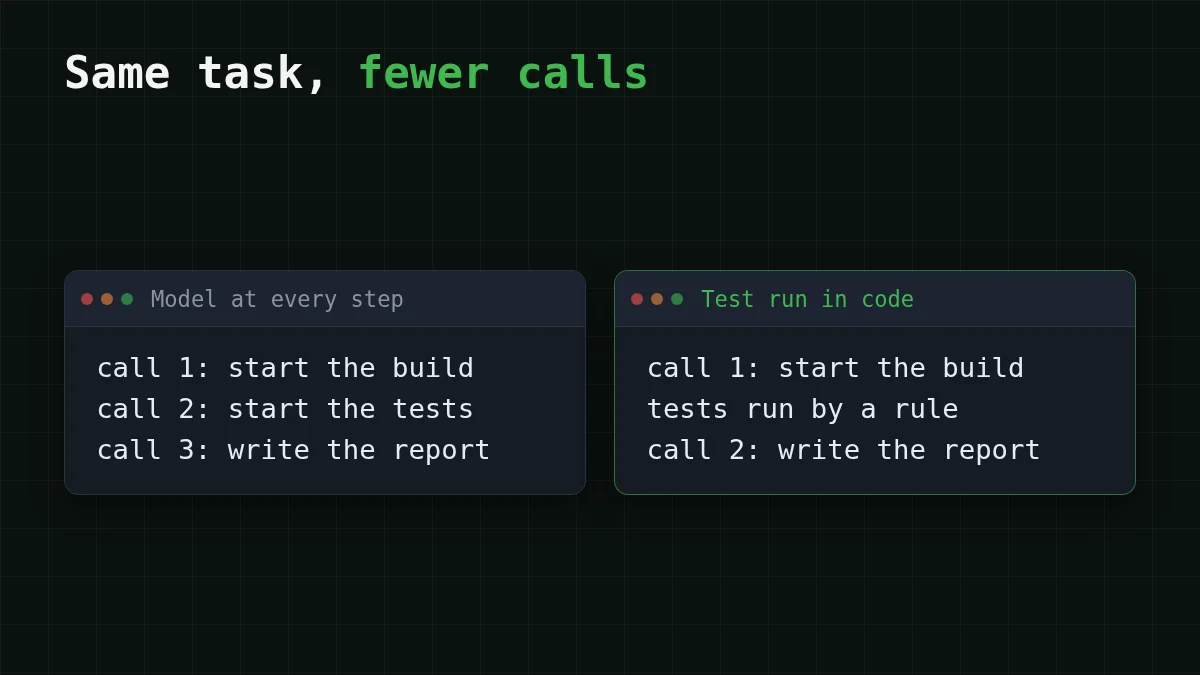
코드에서 규칙은 몇 줄입니다. 의사 코드이며, 헬퍼 이름은 여러분의 것입니다:
result = run_tool(call)              # the model asked for: make build
messages.append(tool_message(result))

if call.name == "build" and result.exit_code == 0:
    tests = run_tool("make test")    # fixed rule, no model call
    messages.append(tool_message(tests))
# anything else (build failed, odd output) goes back to the model

reply = call_model(messages)         # the model reads everything once
HarnessMM 저자들이 보고한 것#
이 아이디어는 우리만의 것이 아닙니다. HarnessMM은 arXiv 프리프린트(arXiv:2610.32813, 2026년 10월 23일 제출, 2026년 11월 2일 확인)로 Yuhua Jiang, Chang Xu, Feifei Gao, Li Zhao가 작성했습니다. 그들의 관찰: 에이전트 하네스는 이전 호출이 이미 다음 행동을 결정했는데도 도구 피드백 후에 모델을 다시 호출하는 경우가 많습니다. 그들의 해결책인 가드된 결정 재사용은 그 결정을 재생하고, 새로운 의미적 결정이 나타나거나 증거가 뒷받침되지 않거나 선택기가 기권하면 원래 모델로 폴백합니다. 위의 if은 같은 아이디어의 수작업 버전이며, 그들의 가드가 어떻게 결정하는지는 논문에 있습니다.
저자들은 HumanEval에서 다음 결과를 보고합니다:
- Codex 하네스: 작업당 66.72k → 47.02k 토큰(−29.54%), 성공률 90.82%로 동일.
- DeepSeek Harness: 작업당 96.28k → 11.62k 토큰(−87.93%), 성공률 71.43% → 85.71%.
주의해서 읽으세요. 벤치마크 하나, 저자들 자신의 하네스, 동료 검토를 거치지 않은 프리프린트이며, arXiv 페이지에는 코드가 없습니다. 재전언에서 "88%"를 볼 수 있는데, 그것은 DeepSeek Harness 수치일 뿐이고 Codex 수치는 약 30%입니다. 둘 다 방향으로 취급하세요, 여러분의 에이전트에 대한 약속이 아닙니다. 여러분의 로그가 더 많은 것을 알려줍니다.
10분 만에 여러분의 에이전트 점검하기#
모든 모델 호출의 로그를 켜고, 각 응답의 usage 숫자를 기록하세요(Python에서 에이전트 토큰 비용 추적에서 한 가지 방법을 보여줍니다). 그런 다음 최근 20회 실행을 읽고 각 호출을 표시하세요: 결정 또는 고정. 그 실행들에서 다음 행동이 한 번도 바뀌지 않았다면 그 호출은 후보입니다. 여러분의 로그는 무엇을 보여주나요?
사례 선택하기
여러분의 로그는 무엇을 보여주나요?
답을 보려면 옵션을 선택하세요
모든 실행에서 같은 호출 쌍
고정 규칙이 거기 숨어 있습니다. 종료 코드 같은 명확한 신호에 대한 if로 작성하고, 신호가 예상 밖이면 모델을 폴백으로 유지하세요.
도구 출력을 재포맷하거나 복사만 하는 호출
코드의 템플릿으로 옮기세요. 텍스트에 정말 모델이 필요하다면, 가장 큰 모델이 아니라 저렴한 모델에게 작은 작업입니다.
내용에 따라 다음 단계가 바뀌는 호출
여기서는 모델을 유지하세요. 이것이 모델의 용도이며, 저렴한 모델이 단순한 분류 후 선택 단계를 처리하는 경우가 많습니다. 모델 라우팅: 저렴한 모델 먼저를 참고하세요.
모든 호출이 거대한 로그를 다시 읽음
대화로 돌아가는 내용을 줄이세요: 도구 출력을 컨텍스트 밖으로 유지. 호출을 제거하지 않고도 같은 작업이 더 저렴해집니다.
긴 컨텍스트를 가진 모델에서 이것을 시도하고 싶다면, CheapTokens는 에이전트 루프용으로 DeepSeek-V4-Flash(deepseek-)를 제공합니다: 시간대와 무관한 단일 가격, 380K 컨텍스트, 답변당 최대 32,768 출력 토큰. 여전히 결정이 필요한 단계를 위해 390K 컨텍스트의 GLM-5.3-Flash(zai-)가 있습니다. 둘 다 https:/의 OpenAI 및 Anthropic 호환 API를 통해 작동하며, 모든 모델에 하나의 잔액을 씁니다. 설정은 문서에, 가격은 가격 페이지에, 모델 페이지는 저렴한 DeepSeek에 있습니다.


