비용 최적화분석
긴 에이전트 프로젝트 예산: 컴퓨트 vs 토큰 (RSA-260 사례)
$400k RSA-260 헤드라인은 GPU 임대료이지 모델 토큰이 아닙니다. 긴 에이전트 프로젝트를 세 가지 예산 항목으로 나누고 세션 × 단계 × 토큰으로 토큰 부분을 산정하세요.
이 페이지의 내용
Cognition의 RSA-260 인수분해에서 나온 약 $400k라는 수치는 GPU 임대료이지 모델 청구서가 아닙니다. 보고서는 에이전트 측 비용을 전혀 산정하지 않았으므로, 긴 에이전트 프로젝트를 계획한다면 토큰 비용은 직접 추정해야 합니다: 세션 × 단계 × 단계당 토큰, 실시간 가격 기준으로요. 이 페이지의 나머지가 바로 그 작업입니다.
출처는 Cognition의 엔지니어 Eric Lu가 쓴 Cognition의 글입니다 (Factoring RSA-260, 2026년 9월 9일 게시, 2026년 11월 6일 확인). 이 글이 헤드라인에 달러 수치를 달고 다시 공유되고 있는데, 그 수치는 오해하기 쉽습니다.
$400k가 실제로 지불하는 것#
저자는 GPU에서 실행되는 대폭 수정된 CADO-NFS를 사용해 GNFS로 260자리 수를 인수분해했습니다. 보고서는 각 단계의 GPU 시간을 제시합니다:
- 다항식 선택: 643 GPU-일
- 체질(sieving): 3,813 GPU-일
- 선형 방정식 풀이: 467 GPU-일
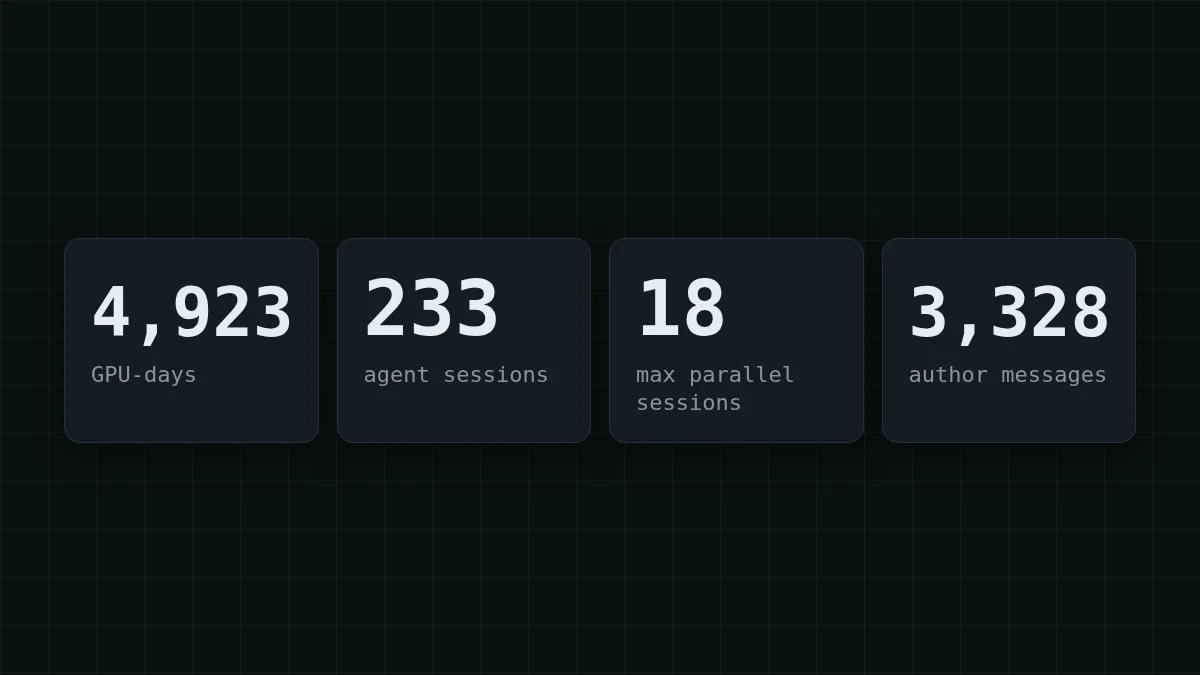
합계는 643 + 3,813 + 467 = 4,923 GPU-일이며, 보고서는 이를 ~4,900으로 반올림합니다. 보고서가 가정한 GPU-시간당 $3.50 기준으로:
4,923 × 24 × 3.50 = 413,532
이는 부록의 $414k GPU 수치와 일치합니다. 즉 헤드라인은 몇 주 동안 수치 연산 작업을 돌린 임대 하드웨어입니다. 그 합계에는 모델 토큰이 전혀 없습니다.
빠른 확인
RSA-260 보고서의 ~$400k 수치는 무엇인가?
정답 보기
정답: 인수분해 작업을 위한 GPU의 시장가 임대료
GPU-일 × GPU-시간당 $3.50에서 나옵니다. 보고서는 모델을 명시하지 않고 에이전트 부분의 토큰 수치도 제시하지 않습니다.
에이전트가 한 일, 그리고 보고서가 말하지 않는 것#
에이전트 측은 비용이 아니라 활동으로 설명됩니다. 첫 프롬프트는 2026년 8월 13일에 나갔고, 작업은 약 3주가 걸렸으며, 수치는 다음과 같습니다:
- 인수분해를 위한 233개의 Devin 세션, 평균 3개 병렬 실행, 최대 18개
- 그중 192개는 저자로부터 메시지를 받았고, 36개는 인간 개입 없이 전혀 실행됨
- 101개의 자식 세션이 다른 세션에 의해 시작됨
- Devin 자체 집계: 14,450 ACU (Devin의 단위이며 토큰이 아님)
세션은 측정, 클러스터 운영, 튜닝, 디버깅을 처리했습니다. 인간은 우선순위를 정하고 벤치마크를 구축했습니다. 저자가 밝힌 두 가지 솔직한 디테일: CADO-NFS 주변의 분해는 사람이 설계했으며 필수적이었고, 코드가 업스트림에서 멀어질수록 에이전트는 더 혼란스러워졌습니다.
빠진 것은 정확히 예산에 필요한 것입니다: 어떤 모델, 얼마나 많은 토큰. 그러니 14,450 ACU에서 토큰 청구서를 역산하려 하지 마세요. 그렇게 하는 온라인 글은 모두 추측입니다.
세 번째 항목: 인간의 조종#
저자는 3,328개의 메시지, 총 82,702 단어를 보냈습니다. 이는 82,702 ÷ 3,328 ≈ 메시지당 25 단어로, 에세이가 아닌 짧은 넛지입니다. 그 단어들은 토큰으로는 거의 비용이 들지 않습니다. 비용은 주의력입니다: 누군가 에이전트가 한 일을 읽고 다음을 결정해야 합니다. 에이전트 프로젝트를 예산화할 때, 그것을 API 사용료가 아닌 시간 단위로 별도 항목에 넣으세요.
따라서 긴 에이전트 프로젝트에는 세 가지 항목이 있습니다:
표를 오른쪽으로 스크롤하세요 →
| 항목 | RSA-260 보고서에서 | 당신에게 이를 결정하는 것 |
|---|---|---|
| 컴퓨트 | GPU-시간당 $3.50로 책정된 ~$414k의 GPU 시간 | 당신의 작업 자체: 빌드, 테스트, 학습, 시뮬레이션 |
| 모델 토큰 | 보고되지 않음 | 세션 × 단계 × 단계당 토큰 |
| 인간의 조종 | 약 3주 동안 3,328 메시지 | 얼마나 자주 검토하고 방향을 바꾸는지 |
토큰 항목 추정하기#
공식은 다음과 같으며, 사람들이 잊는 한 가지: 모든 단계는 히스토리를 다시 보냅니다. 에이전트는 세션을 기억하지 않습니다; 각 호출은 작업, 읽은 파일, 지금까지의 도구 출력을 함께 전달합니다. 그래서 입력 토큰이 보통 출력 토큰을 압도합니다 (AI 에이전트가 왜 그렇게 많은 토큰을 쓰는지에서 더 다룹니다).
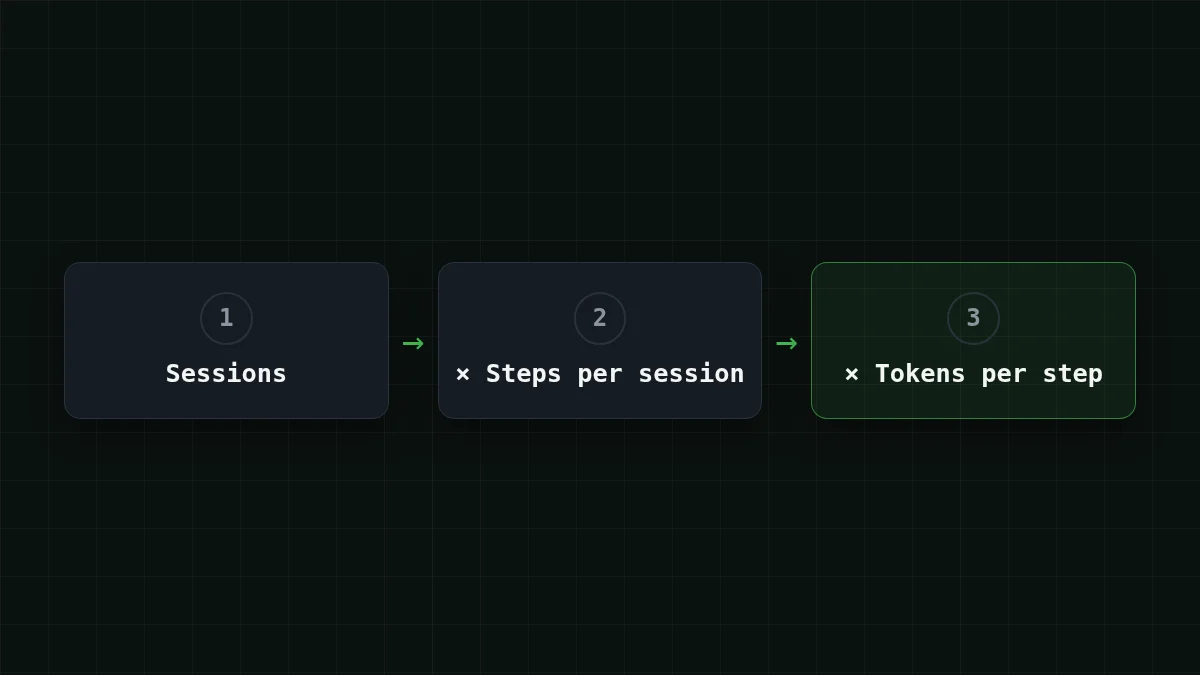
Cognition 규모의 프로젝트, 233 세션을 계획하고 세션당 60단계를 가정한다고 합시다. 이 두 수치는 이 페이지의 가정이며 Cognition 데이터가 아닙니다. 그러면:
233 × 60 = 13,980
즉 13,980번의 모델 호출입니다. 이제 한 번의 호출 크기. 평균 단계가 60,000 토큰을 입력으로 보내고(작업, 히스토리, 파일 한두 개) 1,500 토큰을 돌려받는다고(명령 또는 패치) 가정합니다. 합계:
60,000 × 13,980 = 838,800,000
1,500 × 13,980 = 20,970,000
즉 약 839M 입력 토큰과 21M 출력 토큰입니다. 입력은 출력의 마흔 배이며, 예산이 사는 곳이 바로 그쪽입니다. DeepSeek-V4-Flash에서 이 프로젝트는 $14.68이고, 60단계의 한 세션은 $0.063입니다. 다음은 모든 모델에 동일한 부하를 적용한 것이며, 옆에 OpenRouter 참조가 있습니다:
| 모델 | 입력 $/1M | 출력 $/1M | 요청당 | 13,980회 요청 | OpenRouter, 13,980회 요청 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0013 | $17.61 | $29.84 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0011 | $14.68 | $61.65 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0032 | $45.09 | $541.03 |
요청당 입력 60,000개 및 출력 1,500개 토큰입니다. 100만 토큰당 가격은 현재 기준이며 당사 요금제에 따라 함께 변경됩니다. OpenRouter 열은 동일한 작업량에 대한 참고 가격을 보여줍니다.
입력과 출력을 합친 총계로 보면, 이 부하에서 우리 모델 각각이 OpenRouter보다 저렴합니다. 가격은 가격 페이지에서 실시간으로 가져오므로, 요금이 바뀌면 표도 움직입니다.
직접 해보기시도해 보세요: 60단계 세션이 평균 60,000 토큰을 입력으로 보냅니다. 1단계가 60단계만큼 많이 보내나요?정답 보기
아니요. 1단계는 적게 보내고(작업과 몇 개 파일), 60단계는 그동안 모은 모든 것을 다시 보냅니다. 60,000을 평균으로 잡는 것은 세션이 작게 시작해 100K 이상에서 끝난다고 가정하는 것입니다. 세션이 예를 들어 120K에서 끝난다는 것을 안다면 평균은 그 절반 정도이므로, 평균만이 아니라 가장 큰 요청을 측정하세요.
10분 만에 자신의 수치 얻기#
가정은 시작점일 뿐입니다. 저렴한 모델에서 실제 작업 세션 하나를 실행하고 API가 모든 응답에서 반환하는 usage 객체를 읽으세요. OpenAI 호환 엔드포인트는 호출당 prompt_tokens과 completion_을 보고합니다:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "max_tokens": 1500, "messages": [{"role": "user", "content": "Summarize this test failure and propose a fix: ..."}]}'
세션 전체에 걸쳐 usage을 합산하고 호출 수로 나눈 뒤, 위의 60,000과 1,500을 당신의 평균으로 바꾸세요. 설정 세부 사항은 CheapTokens 문서에, 코드에서 단계별 추적은 Python에서 AI 에이전트 토큰 비용 추적에 있습니다. 단일 50단계 세션에 대한 동일한 계산은 GLM, DeepSeek 또는 MiniMax에서의 에이전트 세션 비용을 참조하세요.
긴 루프의 경우, DeepSeek-V4-Flash는 380K 컨텍스트 윈도우와 답변당 최대 32,768 출력 토큰을 가지며, 어느 시간대든 단일 가격입니다. GLM-5.3-Flash는 390K 윈도우, MiniMax-M2.7은 180K이므로, 가장 큰 요청이 맞는지 확인하세요.
사례 선택하기
어떤 프로젝트가 당신과 비슷한가요?
답을 보려면 옵션을 선택하세요
많은 짧은 세션
작은 작업, 각각 새로 시작: 호출당 입력이 낮게 유지됩니다. 세션에 단계를 곱하면, 총계는 호출 크기가 아니라 호출 수에 의해 지배될 것입니다.
몇 개의 매우 긴 세션
히스토리가 세션을 통해 커지므로, 마지막 단계들이 비쌉니다. 가장 큰 요청으로 추정하고, 작업을 짧은 브리프가 있는 자식 세션으로 나누면 입력이 눈덩이처럼 불어나지 않습니다.
무거운 컴퓨트와 에이전트
RSA-260처럼: 작업 자체에 하드웨어가 필요합니다. 하드웨어를 제공자로부터 시간당 가격으로 책정하고, 토큰 항목은 별도 추정으로 유지하세요. 머릿속에서는 더해지지 않고, 스프레드시트에서만 더해집니다.
예산을 늘리기 전에 작업을 좁히세요#
보고서에는 예산에 맞는 또 하나의 교훈이 있습니다: 코드가 업스트림에서 멀어질수록 에이전트는 더 혼란스러워졌습니다. 혼란스러운 에이전트는 더 많은 단계를 밟습니다. 추정치가 너무 높아 보이면, 먼저 세션당 단계를 줄이세요: 더 명확한 브리프, 더 작은 코드 영역, 고정 단계를 스크립트로 이동 (에이전트가 매 단계마다 모델이 필요한가 참조). 단계를 절반으로 줄이면 토큰 항목도 절반이 됩니다; 그것이 당신이 가진 가장 쉬운 지렛대입니다.


