খরচ অপ্টিমাইজেশনবিশ্লেষণ
একটি দীর্ঘ এজেন্ট প্রকল্পের বাজেট: কম্পিউট বনাম টোকেন (RSA-260 কেস)
$400k RSA-260 শিরোনামটি GPU ভাড়া, মডেল টোকেন নয়। একটি দীর্ঘ এজেন্ট প্রকল্পকে তিনটি বাজেট লাইনে ভাগ করুন এবং সেশন × ধাপ × টোকেন দিয়ে টোকেন অংশের আকার নির্ধারণ করুন।
এই পৃষ্ঠায়
Cognition-এর RSA-260 ফ্যাক্টরিং থেকে পাওয়া ~$400k সংখ্যাটি GPU ভাড়া, মডেল বিল নয়। রিপোর্টে এজেন্টের দিকের কোনো মূল্যই দেওয়া নেই, তাই আপনি যদি দীর্ঘ এজেন্ট প্রকল্পের পরিকল্পনা করেন, তাহলে টোকেন লাইনটি নিজেই অনুমান করুন: সেশন × ধাপ × প্রতি ধাপে টোকেন, লাইভ দামে। এই পৃষ্ঠার বাকি অংশ ঠিক সেটাই করে।
সূত্র হলো Cognition-এর ইঞ্জিনিয়ার এরিক লু-এর লেখা (Factoring RSA-260, প্রকাশিত ৯ সেপ্টেম্বর ২০২৬, যাচাইকৃত ৬ নভেম্বর ২০২৬)। শিরোনামে ডলারের অঙ্কটি নিয়ে এটি পুনরায় শেয়ার করা হচ্ছে, এবং অঙ্কটি সহজেই ভুল বোঝা যায়।
$400k আসলে কীসের জন্য#
লেখক GNFS ব্যবহার করে একটি ২৬০-সংখ্যার সংখ্যা ফ্যাক্টর করেছেন, একটি ভারী পরিবর্তিত CADO-NFS দিয়ে যা GPU-তে চলে। রিপোর্টে প্রতিটি ধাপের GPU সময় দেওয়া আছে:
- বহুপদী নির্বাচন: ৬৪৩ GPU-দিন
- সিভিং: ৩,৮১৩ GPU-দিন
- রৈখিক সিস্টেম সমাধান: ৪৬৭ GPU-দিন
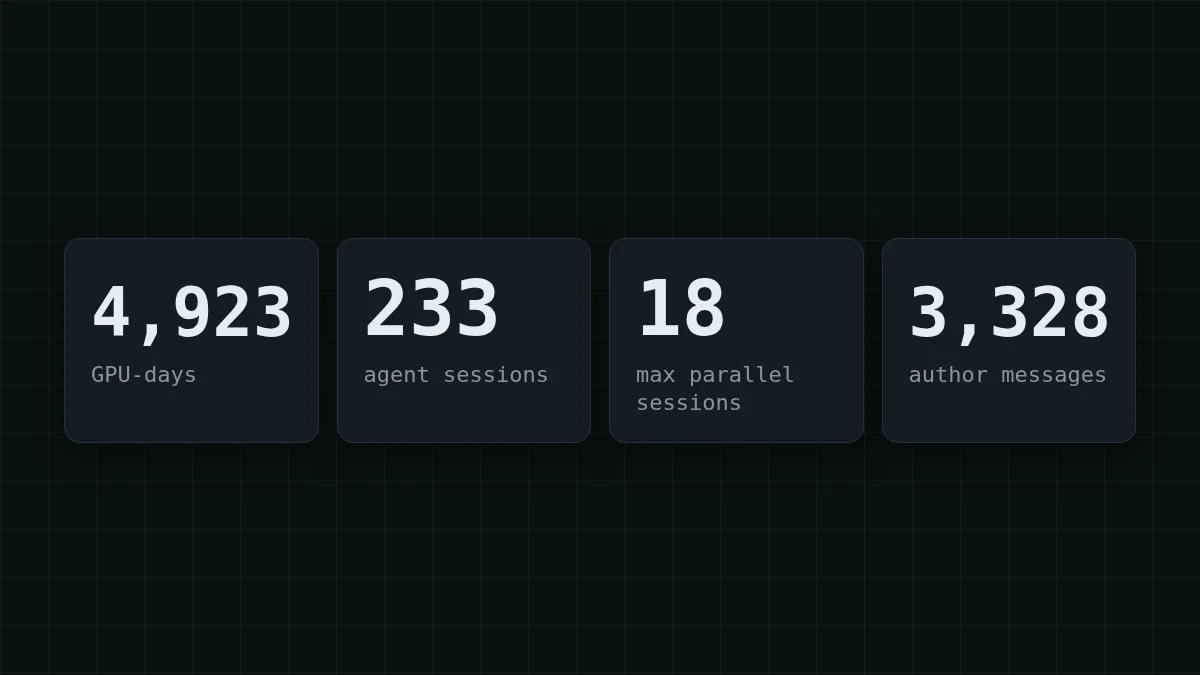
সেটা হলো ৬৪৩ + ৩,৮১৩ + ৪৬৭ = ৪,৯২৩ GPU-দিন, যা রিপোর্টে ~৪,৯০০-তে রাউন্ড করা হয়েছে। রিপোর্টের অনুমিত $৩.৫০ প্রতি GPU-ঘণ্টায়:
৪,৯২৩ × ২৪ × ৩.৫০ = ৪১৩,৫৩২
এটি এর পরিশিষ্টে থাকা $৪১৪k GPU অঙ্কের সাথে মেলে। তাই শিরোনামটি হলো সপ্তাহের পর সপ্তাহ ধরে সংখ্যা-ক্রাঞ্চিং কাজ চালানো ভাড়া করা হার্ডওয়্যার। সেই যোগফলে কোনো মডেল টোকেন নেই।
দ্রুত যাচাই
RSA-260 রিপোর্টে ~$400k অঙ্কটি কী?
উত্তর দেখান
উত্তর: ফ্যাক্টরিং রানের জন্য GPU-এর বাজার-হারে ভাড়া
এটি GPU-দিন × $৩.৫০ প্রতি GPU-ঘণ্টা থেকে আসে। রিপোর্টে কোনো মডেলের নাম নেই এবং এজেন্ট অংশের জন্য কোনো টোকেন গণনাও নেই।
এজেন্টরা কী করেছে, এবং রিপোর্টে কী নেই#
এজেন্টের দিকটি খরচ দিয়ে নয়, কার্যকলাপ দিয়ে বর্ণনা করা হয়েছে। প্রথম প্রম্পট গিয়েছিল ১৩ আগস্ট ২০২৬-এ, কাজটি প্রায় তিন সপ্তাহ লেগেছিল, এবং সংখ্যাগুলি হলো:
- ফ্যাক্টরিংয়ের জন্য ২৩৩টি Devin সেশন, গড়ে ৩টি সমান্তরালে চলছে এবং সর্বোচ্চ ১৮টি
- তাদের মধ্যে ১৯২টি লেখকের কাছ থেকে বার্তা পেয়েছে, ৩৬টি কোনো মানব হস্তক্ষেপ ছাড়াই চলেছে
- ১০১টি চাইল্ড সেশন অন্য সেশন দ্বারা শুরু হয়েছে
- Devin-এর নিজস্ব হিসাব: ১৪,৪৫০ ACU (এটি Devin-এর একক, টোকেন নয়)
সেশনগুলি পরিমাপ, ক্লাস্টার অপারেশন, টিউনিং এবং ডিবাগিং সামলেছে। মানুষ অগ্রাধিকার নির্ধারণ করেছে এবং বেঞ্চমার্ক তৈরি করেছে। লেখকের দুটি সৎ বিবরণ: CADO-NFS-এর চারপাশের ডিকম্পোজিশন একজন মানুষ ডিজাইন করেছেন এবং এটি অপরিহার্য ছিল, এবং কোড আপস্ট্রিম থেকে যত দূরে সরে গেছে, এজেন্টরা তত বেশি বিভ্রান্ত হয়েছে।
যা নেই তা ঠিক যা একটি বাজেটের প্রয়োজন: কোন মডেল, কত টোকেন। তাই ১৪,৪৫০ ACU থেকে টোকেন বিল বের করার চেষ্টা করবেন না। অনলাইনে যা পড়বেন যা তা করে, তা অনুমান।
তৃতীয় লাইন: মানব পরিচালনা#
লেখক ৩,৩২৮টি বার্তা পাঠিয়েছেন, মোট ৮২,৭০২ শব্দ। সেটা হলো ৮২,৭০২ ÷ ৩,৩২৮ ≈ ২৫ শব্দ প্রতি বার্তায়, প্রবন্ধের বদলে ছোট খোঁচা। সেই শব্দগুলির টোকেনে খরচ প্রায় শূন্য। তারা মনোযোগ খরচ করে: কাউকে পড়তে হবে এজেন্টরা কী করেছে এবং পরবর্তী কী তা সিদ্ধান্ত নিতে হবে। যখন আপনি একটি এজেন্ট প্রকল্পের বাজেট করেন, সেটি ঘণ্টায় নিজের লাইনে রাখুন, API ব্যবহারের ডলারে নয়।
তাই একটি দীর্ঘ এজেন্ট প্রকল্পে তিনটি লাইন থাকে:
টেবিলটি ডানদিকে স্ক্রোল করুন →
| লাইন | RSA-260 রিপোর্টে | আপনার জন্য এটি কী নির্ধারণ করে |
|---|---|---|
| কম্পিউট | ~$৪১৪k GPU সময়, $৩.৫০ প্রতি GPU-ঘণ্টায় মূল্যায়িত | আপনার কাজ নিজেই: বিল্ড, টেস্ট, ট্রেনিং, সিমুলেশন |
| মডেল টোকেন | রিপোর্ট করা হয়নি | সেশন × ধাপ × প্রতি ধাপে টোকেন |
| মানব পরিচালনা | ~৩ সপ্তাহে ৩,৩২৮ বার্তা | আপনি কতবার পর্যালোচনা ও পুনর্নির্দেশ করেন |
আপনার টোকেন লাইন অনুমান করুন#
এখানে সূত্রটি, এবং একটি জিনিস যা মানুষ ভুলে যায়: প্রতিটি ধাপ ইতিহাস পুনরায় পাঠায়। একটি এজেন্ট সেশন মনে রাখে না; প্রতিটি কল টাস্ক, এটি যে ফাইলগুলি পড়েছে এবং এখন পর্যন্ত টুল আউটপুট বহন করে। এজন্যই ইনপুট টোকেন সাধারণত আউটপুট টোকেনকে বামন করে (আরও জানতে কেন AI এজেন্টরা এত টোকেন ব্যবহার করে)।
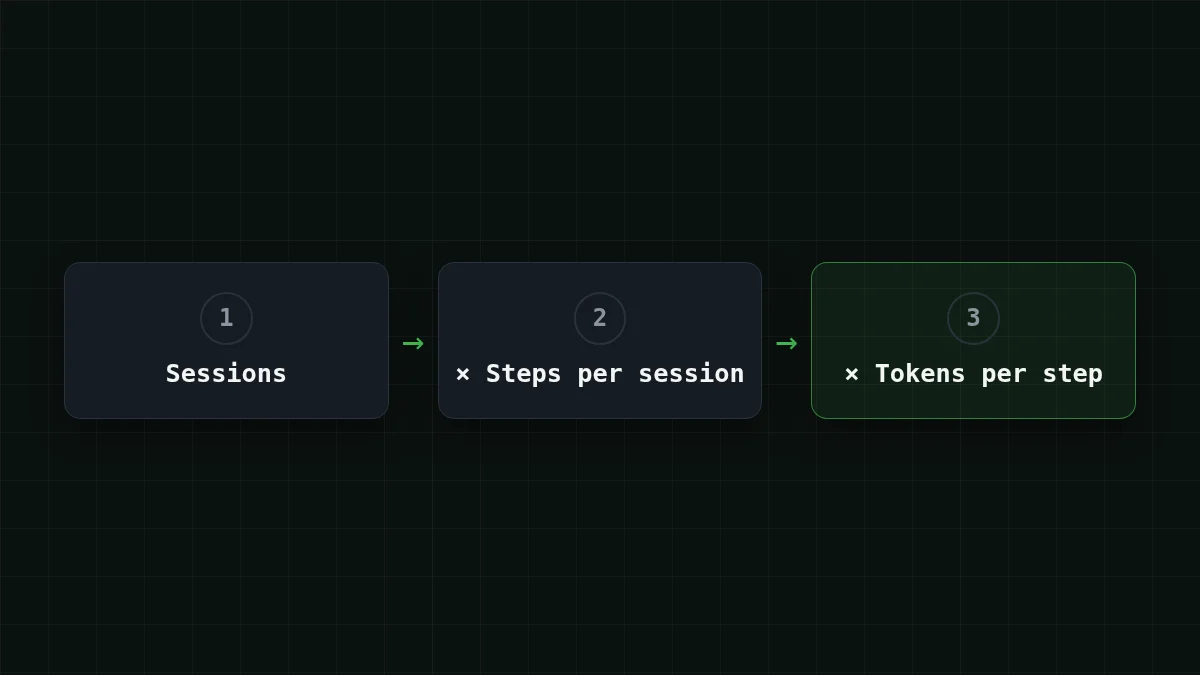
ধরুন আপনি Cognition-এর আকারের একটি প্রকল্প পরিকল্পনা করছেন, ২৩৩ সেশন, এবং আপনি প্রতি সেশনে ৬০ ধাপ ধরে নিচ্ছেন। এই দুটি সংখ্যা এই পৃষ্ঠার অনুমান, Cognition ডেটা নয়। তারপর:
২৩৩ × ৬০ = ১৩,৯৮০
সেটা হলো ১৩,৯৮০ মডেল কল। এখন একটি কলের আকার। ধরুন একটি গড় ধাপ ৬০,০০০ টোকেন পাঠায় (টাস্ক, ইতিহাস, এক-দুটি ফাইল) এবং ১,৫০০ টোকেন ফেরত পায় (একটি কমান্ড বা একটি প্যাচ)। মোট:
৬০,০০০ × ১৩,৯৮০ = ৮৩৮,৮০০,০০০
১,৫০০ × ১৩,৯৮০ = ২০,৯৭০,০০০
তাই প্রায় ৮৩৯M ইনপুট টোকেন এবং ২১M আউটপুট টোকেন। ইনপুট আউটপুটের চল্লিশ গুণ, এবং এটাই সেই দিক যেখানে আপনার বাজেট থাকে। DeepSeek-V4-Flash-এ সেই প্রকল্পের খরচ $14.68, এবং ৬০ ধাপের একটি সেশনের খরচ $0.063। এখানে প্রতিটি মডেলে একই লোড, পাশে OpenRouter রেফারেন্স সহ:
| মডেল | ইনপুট $/১ মিলিয়ন | আউটপুট $/১ মিলিয়ন | প্রতি অনুরোধে | ১৩,৯৮০টি অনুরোধ | OpenRouter, ১৩,৯৮০টি অনুরোধ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0013 | $17.61 | $29.84 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0011 | $14.68 | $61.65 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0032 | $45.09 | $541.03 |
প্রতি অনুরোধে ৬০,০০০ ইনপুট এবং ১,৫০০ আউটপুট টোকেন। প্রতি 1M টোকেনের দাম বর্তমান এবং আমাদের ট্যারিফের সাথে পরিবর্তিত হয়; OpenRouter কলামটি একই ওয়ার্কলোডের জন্য রেফারেন্স মূল্য দেখায়।
মোট হিসাবে, ইনপুট ও আউটপুট একসাথে, এই লোডের জন্য আমাদের প্রতিটি মডেল OpenRouter-এর চেয়ে সস্তা আসে। দাম প্রাইসিং পেজ থেকে লাইভ, তাই ট্যারিফ পরিবর্তনের সাথে টেবিলটি সরে যায়।
নিজে চেষ্টা করুনচেষ্টা করুন: ৬০-ধাপের সেশন গড়ে ৬০,০০০ টোকেন পাঠায়। ধাপ ১ কি ধাপ ৬০-এর মতোই পাঠায়?উত্তর দেখান
না। ধাপ ১ অল্প পাঠায় (টাস্ক এবং কয়েকটি ফাইল), ধাপ ৬০ পথে সংগ্রহ করা সবকিছু পুনরায় পাঠায়। ৬০,০০০-কে গড় ধরে নিলে ধরে নেওয়া হয় সেশনটি ছোট শুরু হয় এবং ১০০K বা তার বেশি কাছাকাছি শেষ হয়। আপনি যদি জানেন আপনার সেশনগুলি ১২০K-এ শেষ হয়, গড়টি তার প্রায় অর্ধেক, তাই সবচেয়ে বড় অনুরোধ পরিমাপ করুন, শুধু গড় নয়।
দশ মিনিটে আপনার নিজের সংখ্যা পান#
অনুমান শুধু একটি সূচনা বিন্দু। একটি সস্তা মডেলে আপনার কাজের একটি বাস্তব সেশন চালান এবং প্রতিটি প্রতিক্রিয়ায় API যে usage অবজেক্ট ফেরত দেয় তা পড়ুন। OpenAI-সামঞ্জস্যপূর্ণ এন্ডপয়েন্টগুলি প্রতি কলে prompt_tokens এবং completion_ রিপোর্ট করে:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "max_tokens": 1500, "messages": [{"role": "user", "content": "Summarize this test failure and propose a fix: ..."}]}'
পুরো সেশন জুড়ে usage যোগ করুন, কলের সংখ্যা দিয়ে ভাগ করুন, এবং উপরের ৬০,০০০ এবং ১,৫০০-কে আপনার গড় দিয়ে প্রতিস্থাপন করুন। সেটআপের বিবরণ CheapTokens ডক্স-এ; কোডে প্রতি-ধাপ ট্র্যাকিং Python-এ AI এজেন্ট টোকেন খরচ ট্র্যাক করুন-এ। একটি একক ৫০-ধাপের সেশনে একই গণিতের জন্য, দেখুন GLM, DeepSeek বা MiniMax-এ এজেন্ট সেশন খরচ।
দীর্ঘ লুপের জন্য, DeepSeek-V4-Flash-এ ৩৮০K কনটেক্সট উইন্ডো এবং প্রতি উত্তরে সর্বোচ্চ ৩২,৭৬৮ আউটপুট টোকেন, যেকোনো সময়ে এক দাম। GLM-5.3-Flash-এ ৩৯০K উইন্ডো এবং MiniMax-M2.7-এ ১৮০K, তাই আপনার সবচেয়ে বড় অনুরোধ ফিট করে কিনা যাচাই করুন।
আপনার কেস বেছে নিন
কোন প্রকল্পটি আপনার মতো দেখায়?
উত্তর দেখতে একটি বিকল্প বেছে নিন
অনেক ছোট সেশন
ছোট কাজ, প্রতিটি নতুন করে শুরু: প্রতি কলে ইনপুট কম থাকে। সেশনকে ধাপ দিয়ে গুণ করুন, এবং আশা করুন মোটটি কলের সংখ্যা দ্বারা প্রভাবিত হবে, তাদের আকার দ্বারা নয়।
কয়েকটি খুব দীর্ঘ সেশন
সেশন জুড়ে ইতিহাস বাড়ে, তাই শেষ ধাপগুলি ব্যয়বহুল। সবচেয়ে বড় অনুরোধ দিয়ে অনুমান করুন, কাজটিকে ছোট ব্রিফ সহ চাইল্ড সেশনগুলিতে ভাগ করুন, এবং ইনপুট আর তুষারপাত হবে না।
ভারী কম্পিউট প্লাস এজেন্ট
RSA-260-এর মতো: কাজটির নিজেই হার্ডওয়্যার প্রয়োজন। আপনার প্রদানকারীর কাছ থেকে প্রতি ঘণ্টায় হার্ডওয়্যারের দাম করুন, এবং টোকেন লাইনটি আলাদা অনুমান হিসেবে রাখুন। তারা আপনার মাথায় যোগ হয় না, শুধু স্প্রেডশিটে।
বাজেট বাড়ানোর আগে কাজটি সংকীর্ণ করুন#
রিপোর্টে আরও একটি শিক্ষা আছে যা বাজেটের সাথে খাপ খায়: কোড আপস্ট্রিম থেকে যত দূরে সরে গেছে, এজেন্টরা তত বেশি বিভ্রান্ত হয়েছে। বিভ্রান্ত এজেন্টরা বেশি ধাপ নেয়। আপনার অনুমান যদি খুব বেশি মনে হয়, প্রথমে প্রতি সেশনে ধাপ কমিয়ে দিন: একটি পরিষ্কার ব্রিফ, কোডের ছোট এলাকা, নির্দিষ্ট ধাপ স্ক্রিপ্টে সরান (দেখুন এজেন্টদের কি প্রতিটি ধাপে মডেল দরকার)। ধাপ অর্ধেক করলে টোকেন লাইন অর্ধেক হয়; এটাই আপনার সবচেয়ে সহজ লিভার।


