コスト最適化詳細解説
長期エージェントプロジェクトの予算:コンピュート対トークン(RSA-260の事例)
RSA-260の40万ドルという見出しはGPUレンタル費用であり、モデルトークンではありません。長期エージェントプロジェクトを3つの予算行に分け、トークン部分をセッション数 × ステップ数 × トークン数で見積もります。
このページの内容
CognitionのRSA-260因数分解における約40万ドルという数字は、GPUレンタル費用であり、モデル利用料金ではありません。レポートはエージェント側のコストを一切見積もっていないため、長期のエージェントプロジェクトを計画する場合は、トークン費用の行を自分で見積もる必要があります。セッション数 × ステップ数 × ステップあたりのトークン数、これを実際の価格で計算します。このページの残りの部分では、まさにそれを行います。
出典はCognitionのエンジニアEric Luによる記事(Factoring RSA-260、2026年9月9日公開、2026年11月6日確認)です。見出しにドルの数字が入った形で再共有されていますが、この数字は誤読されやすいものです。
40万ドルは実際に何に支払われたのか#
著者はGNFSを用いて260桁の数を因数分解しました。GPU上で動作する大幅に改造されたCADO-NFSを使用しています。レポートには各フェーズのGPU時間が記載されています:
- 多項式選択:643 GPU日
- ふるい分け:3,813 GPU日
- 線形方程式系の求解:467 GPU日
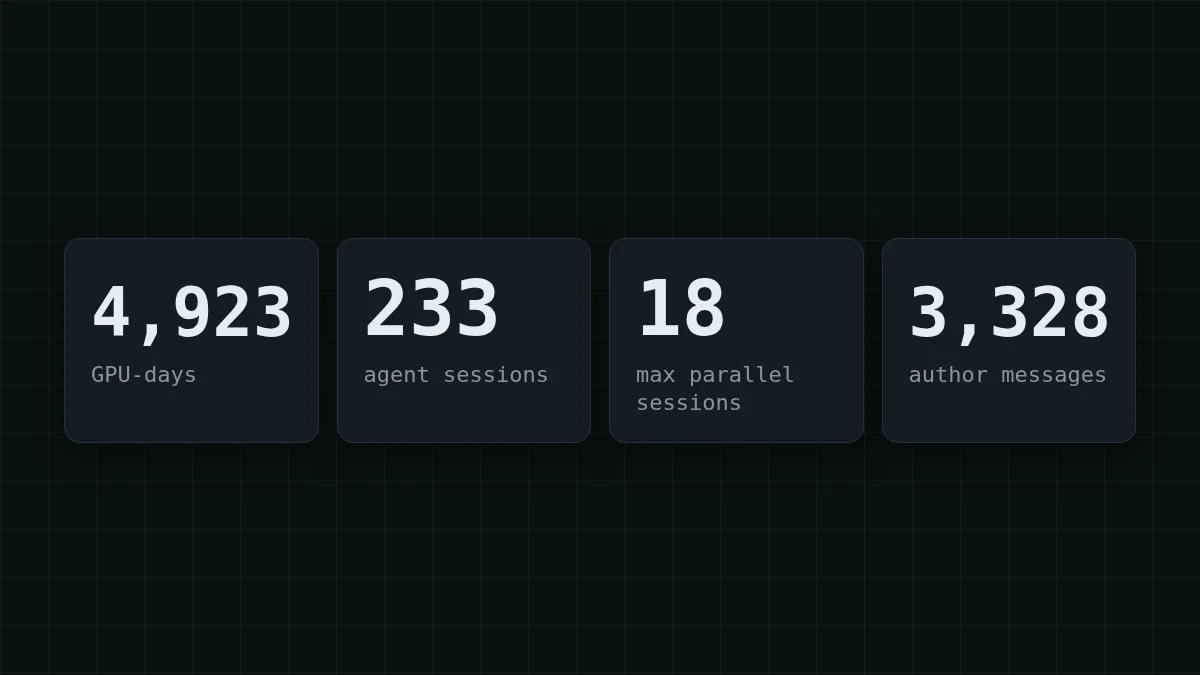
合計は643 + 3,813 + 467 = 4,923 GPU日で、レポートでは約4,900に丸められています。レポートが想定するGPU時間あたり3.50ドルで計算すると:
4,923 × 24 × 3.50 = 413,532
これは付録にある41万4千ドルのGPU費用と一致します。つまり見出しの数字は、何週間にもわたる数値計算ジョブを実行するためにレンタルされたハードウェアの費用です。この合計にモデルのトークンは含まれていません。
クイックチェック
RSA-260レポートの約40万ドルという数字は何ですか?
答えを表示
答え: 因数分解実行のための市場価格でのGPUレンタル
GPU日 × GPU時間あたり3.50ドルから算出されています。レポートにはモデル名も、エージェント部分のトークン数も記載されていません。
エージェントが行ったこと、そしてレポートが語らないこと#
エージェント側はコストではなく活動によって説明されています。最初のプロンプトは2026年8月13日に送信され、作業には約3週間かかりました。数値は以下の通りです:
- 因数分解のための233のDevinセッション。平均3並列、ピーク時18並列
- そのうち192セッションは著者からのメッセージを受け取り、36セッションは人間の介入なしで実行された
- 101の子セッションが他のセッションによって開始された
- Devin自身の集計:14,450 ACU(これはDevinの単位であり、トークンではありません)
セッションは計測、クラスタ運用、チューニング、デバッグを担当しました。人間は優先順位を設定し、ベンチマークを構築しました。著者による2つの正直な指摘:CADO-NFS周りの分解は人間が設計したものであり、それが不可欠だったこと、そしてコードが上流から乖離するほどエージェントは混乱したということです。
欠けているのは、まさに予算に必要な情報です:どのモデルを、何トークン使ったか。ですから14,450 ACUからトークン料金を逆算しようとしないでください。オンラインでそうしているものはすべて推測です。
3つ目の行:人間による舵取り#
著者は3,328メッセージ、合計82,702語を送信しました。これは82,702 ÷ 3,328 ≈ メッセージあたり25語で、エッセイではなく短い促しです。これらの言葉はトークンとしてはほとんどコストがかかりません。かかるのは注意力です:エージェントが何をしたかを読み、次に何をするかを決める人が必要です。エージェントプロジェクトの予算を立てる際は、これをAPI利用料のドルではなく、時間として別の行に計上してください。
したがって、長期のエージェントプロジェクトには3つの行があります:
テーブルを右にスクロールしてください →
| 行 | RSA-260レポートの場合 | あなたの場合に決めるもの |
|---|---|---|
| コンピュート | GPU時間で約41万4千ドル、GPU時間あたり3.50ドルで計算 | ジョブ自体:ビルド、テスト、トレーニング、シミュレーション |
| モデルトークン | 報告なし | セッション数 × ステップ数 × ステップあたりのトークン数 |
| 人間による舵取り | 約3週間で3,328メッセージ | どのくらいの頻度でレビューし、方向転換するか |
トークン費用の行を見積もる#
公式はこちらです。そして人々が忘れがちな点が1つあります:各ステップは履歴を再送信します。 エージェントはセッションを記憶しません。各呼び出しはタスク、読み取ったファイル、これまでのツール出力を運びます。だからこそ入力トークンが通常は出力トークンをはるかに上回ります(詳細はAIエージェントがなぜこれほど多くのトークンを使うのかをご覧ください)。
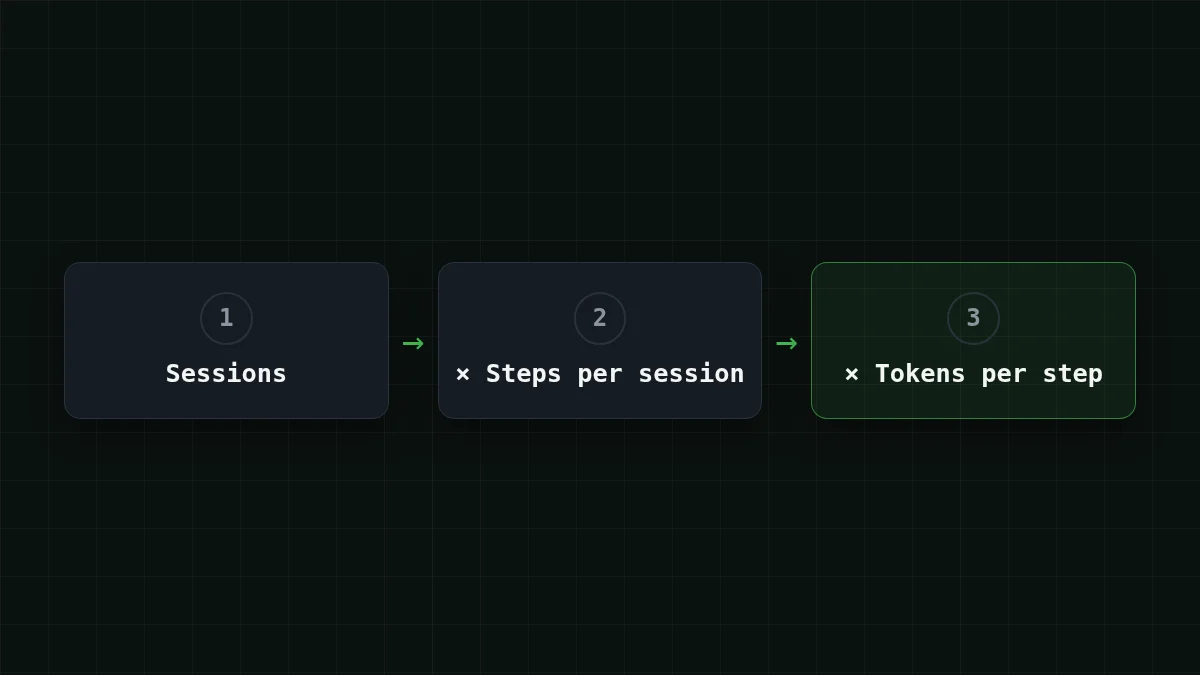
Cognitionのプロジェクトと同じ規模、233セッションを計画し、セッションあたり60ステップと仮定します。この2つの数値はこのページの仮定であり、Cognitionのデータではありません。すると:
233 × 60 = 13,980
つまり13,980回のモデル呼び出しです。次に1回の呼び出しのサイズです。平均的なステップが60,000トークンを入力し(タスク、履歴、ファイル1〜2個)、1,500トークンを返す(コマンドまたはパッチ)とします。合計は:
60,000 × 13,980 = 838,800,000
1,500 × 13,980 = 20,970,000
つまり約8億3,900万入力トークンと2,100万出力トークンです。入力は出力の40倍であり、予算の大部分はこちら側にあります。DeepSeek-V4-Flashでは、このプロジェクトのコストは$14.68、60ステップの1セッションは$0.063です。以下は同じ負荷を全モデルで計算し、OpenRouterの参考価格を並べたものです:
| モデル | 入力 $/1M | 出力 $/1M | リクエストあたり | 13,980 リクエスト | OpenRouter、13,980 リクエスト |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0013 | $17.61 | $29.84 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0011 | $14.68 | $61.65 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0032 | $45.09 | $541.03 |
リクエストあたり 60,000 入力トークンと 1,500 出力トークン。100万トークンあたりの価格は現行のもので、当社の料金体系に合わせて変動します。OpenRouter 列は同じワークロードの参考価格を示しています。
入力と出力を合わせた合計で見ると、この負荷では当社の各モデルはすべてOpenRouterより安くなります。価格は料金ページからリアルタイムで取得しているため、料金が変われば表も変わります。
自分で試す考えてみましょう:60ステップのセッションは平均60,000トークンを入力します。ステップ1はステップ60と同じだけ送信するでしょうか?答えを表示
いいえ。ステップ1は少しだけ(タスクと少数のファイル)を送信し、ステップ60は途中で集めたすべてを再送信します。60,000を平均とすると、セッションは小さく始まり、100K以上で終わることを想定しています。セッションが例えば120Kで終わるとわかっている場合、平均はその約半分になるので、平均だけでなく最大リクエストを測定してください。
10分で自分の数値を得る#
仮定は出発点に過ぎません。自分のタスクの実際のセッションを1回、安価なモデルで実行し、APIがすべてのレスポンスで返すusageオブジェクトを読み取ってください。OpenAI互換エンドポイントは呼び出しごとにprompt_tokensとcompletion_を報告します:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
-d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "max_tokens": 1500, "messages": [{"role": "user", "content": "Summarize this test failure and propose a fix: ..."}]}'セッション全体でusageを合計し、呼び出し回数で割り、上記の60,000と1,500を自分の平均値に置き換えてください。セットアップの詳細はCheapTokensドキュメントに、コードでのステップごとの追跡はPythonでAIエージェントのトークンコストを追跡するにあります。単一の50ステップセッションで同じ計算をするには、GLM、DeepSeek、MiniMaxでのエージェントセッションコストをご覧ください。
長いループの場合、DeepSeek-V4-Flashは380Kのコンテキストウィンドウと回答あたり最大32,768出力トークンを持ち、時間帯に関係なく一律価格です。GLM-5.3-Flashは390Kのウィンドウ、MiniMax-M2.7は180Kなので、最大リクエストが収まるか確認してください。
ケースを選ぶ
あなたのプロジェクトはどれに似ていますか?
オプションを選択して答えを表示
短いセッションが多い
小さなタスクがそれぞれ新規に始まる:呼び出しあたりの入力は低く抑えられます。セッション数にステップ数を掛けると、合計は呼び出しのサイズではなく回数に支配されると予想されます。
非常に長いセッションが少数
履歴がセッションを通じて増えるため、最後のステップが高くつきます。最大リクエストで見積もり、作業を短いブリーフを持つ子セッションに分割すれば、入力の雪だるま式増加は止まります。
重いコンピュートとエージェント
RSA-260のように:ジョブ自体にハードウェアが必要です。ハードウェアはプロバイダーから時間単位で価格を取得し、トークン行は別の見積もりとして保持してください。頭の中では合計せず、スプレッドシートでのみ合計しましょう。
予算を増やす前にタスクを絞る#
レポートには予算に合うもう1つの教訓があります:コードが上流から乖離するほど、エージェントは混乱しました。混乱したエージェントはより多くのステップを要します。見積もりが高すぎるように見えるなら、まずセッションあたりのステップ数を減らしてください:より明確なブリーフ、より小さなコード領域、固定ステップをスクリプトに移す(エージェントは毎ステップモデルを必要とするかをご覧ください)。ステップを半分にすればトークン行も半分になります。それがあなたが持つ最も簡単なレバーです。


