AIニュースアップデート
Meta Muse Ember API価格: $0.10 / $0.50、1Mコンテキスト
MetaのMuse Ember: 価格帯、1Mコンテキスト、512K出力、そして50ステップのエージェントセッションのコスト、安価なサブタスクの代替案。
Metaの新しいMuse Emberは、エージェント内で繰り返される安価なステップのために作られた小型モデルで、Metaの発表によると、200Kトークンまでのプロンプトで入力$0.10、出力$0.50(100万トークンあたり)です。200Kを超えると価格は3倍になります。1ステップあたり入力20Kトークン、出力500トークンの50ステップのエージェントセッションは、Emberでは約$0.11になり、同じ役割はCheapTokensのDeepSeek-V4-Flashでも利用できます。
このモデルは2026年11月9日にMetaの研究ブログ(research.meta.ai/blog/muse-ember)で発表されました。投稿には日付はありますが時刻はありません。私たちは2026年11月10日にブログとdev.meta.aiのモデルページを確認しました。
Metaが発表した内容#
Muse Ember(モデルID muse-ember-1.0)はMetaのMuseラインで最小かつ最も効率的なモデルで、エージェントのサブタスク(ツール呼び出し、抽出、ルーティング、長い文書の解析)を対象としています。Muse Code、Meta Model API(Standardモードのみ)、Google Cloud、Oracle Cloudから利用できます。Metaはオープンウェイトを発表していないため、APIとMuse Codeが利用経路です。リージョンは明記されていません。
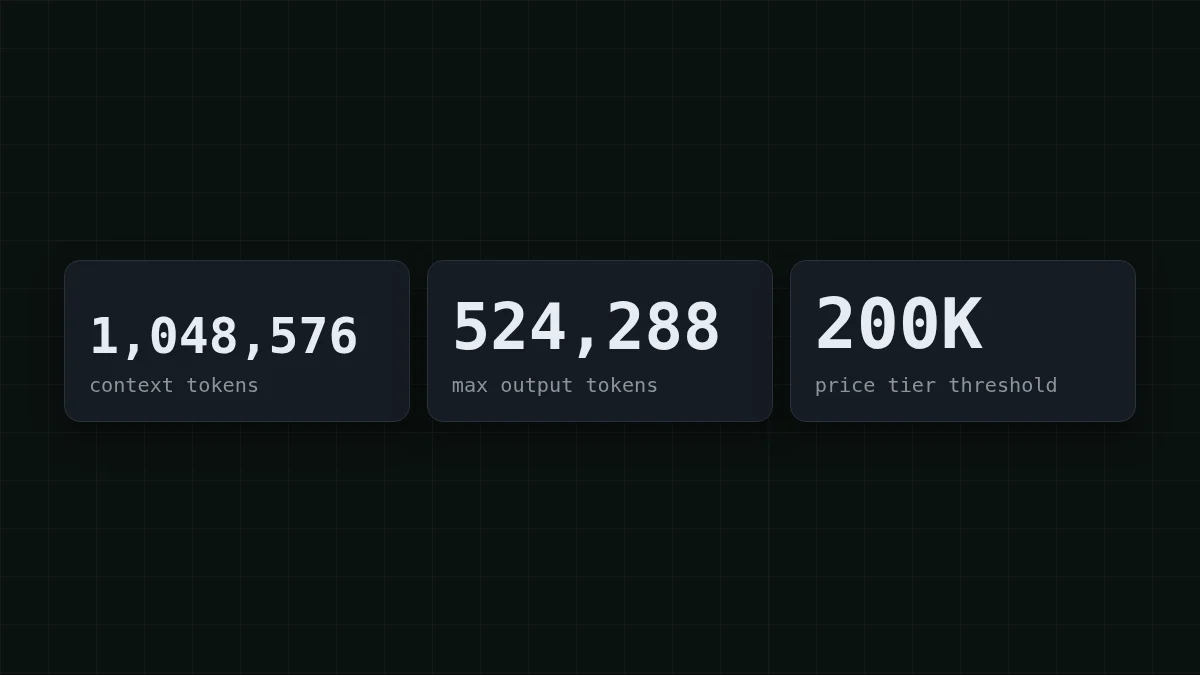
入力としてテキスト、画像、動画、音声、PDFを受け取り、テキストを返します。Responses、Chat Completions、Messagesエンドポイント経由で呼び出せ、ツール呼び出し、構造化出力、コンピュータ使用、画像理解、検索グラウンディングを備えます。推論の強度はminimalからmaxまで設定でき、デフォルトはmaxです。ストリーミングについてはページに記載がないため、断言しません。
Metaはベンチマーク数値も公開しており、それらはMetaによるもので、主にmax推論時のものです。Terminal-Bench 4.0は40.9%でHaiku 5.5の39.2%に対して、AutomationBench-AAは37.8%でMetaが挙げる他の2モデルの13.9%と20.2%に対して、FrontierCode 2.0-AAは27.2%でHaiku 5.5の34.9%に劣ります。Artificial Analysis Intelligence Indexでは36で、Muse Spark 1.3の37に対してです。独自のケースで実行するまでは、ベンダーの主張として扱ってください。
Emberでの50ステップセッションのコスト#
Metaの発表による価格表(モデルページ自体は数値のない価格ページを指しています):
テーブルを右にスクロールしてください →
| プロンプトサイズ | 入力 | キャッシュ入力 | 出力 |
|---|---|---|---|
| 200Kトークンまで | $0.10 | $0.004 | $0.50 |
| 200Kトークン超 | $0.30 | $0.012 | $1.50 |
価格は100万トークンあたりで、2026年11月10日確認。200K超のルールについては二次情報源が異なる説明をしているため、予算を組む前にMetaの価格ページで確認してください。
ではセッションを考えます。エージェントが50ステップ実行し、各ステップで約20Kトークン(増え続ける履歴とツール結果)を送り、約500トークンを受け取るとします。合計で入力1Mトークン、出力25Kトークンです。Emberでは: 1 × $0.10 + 0.025 × $0.50 = $0.1125(トークン数は百万単位)。入力側が請求額のほぼ全体を占めるため、エージェントが同じプレフィックスを保持する場合、キャッシュ入力価格の$0.004が重要になります。
数字を当てる
高い料金がプロンプト全体に適用されるとします(Metaの文言はそう読めます)。Emberで250Kトークンのプロンプトの入力は何セントかかりますか?
あなたの予想
020
答えを表示
答え: 7.5
高い料金がプロンプト全体に適用される場合: 250,000 × $0.30 / 1M = $0.075、つまり入力だけで7.5セントです。そのようなステップが50回なら入力は$3.75になります。
なぜ長いプロンプトなのでしょうか?エージェントは各ステップで履歴を再送するからです。それが初めてなら、なぜエージェントは履歴全体を再読するのかが小さな例で説明しています。
プロンプトはどの価格帯か?#
200Kのラインが要注意です。Metaは長いプロンプトに対して3倍の料金を記載しています: 入力$0.30、キャッシュ入力$0.012、出力$1.50です。
ケースを選ぶ
エージェントの最大リクエストはどこに位置しますか?
オプションを選択して答えを表示
200Kトークン未満
低い価格帯にとどまります。入力$0.10 / 出力$0.50で予算を組み、推論強度をデフォルトのままにする場合は出力側に注意してください。
200Kから1Mトークンの間
高い価格帯が適用されますが、Emberの1,048,576トークンのウィンドウにはまだ収まります。古いツール出力を200Kを超える前に削るか、ジョブを分割して1ステップだけが完全な文書を運ぶようにしてください。
1Mトークン超
1リクエストには収まりません。入力をチャンク化し、プランナーに結果をマージさせてください。
CheapTokensでの同じ安価なサブタスクの役割#
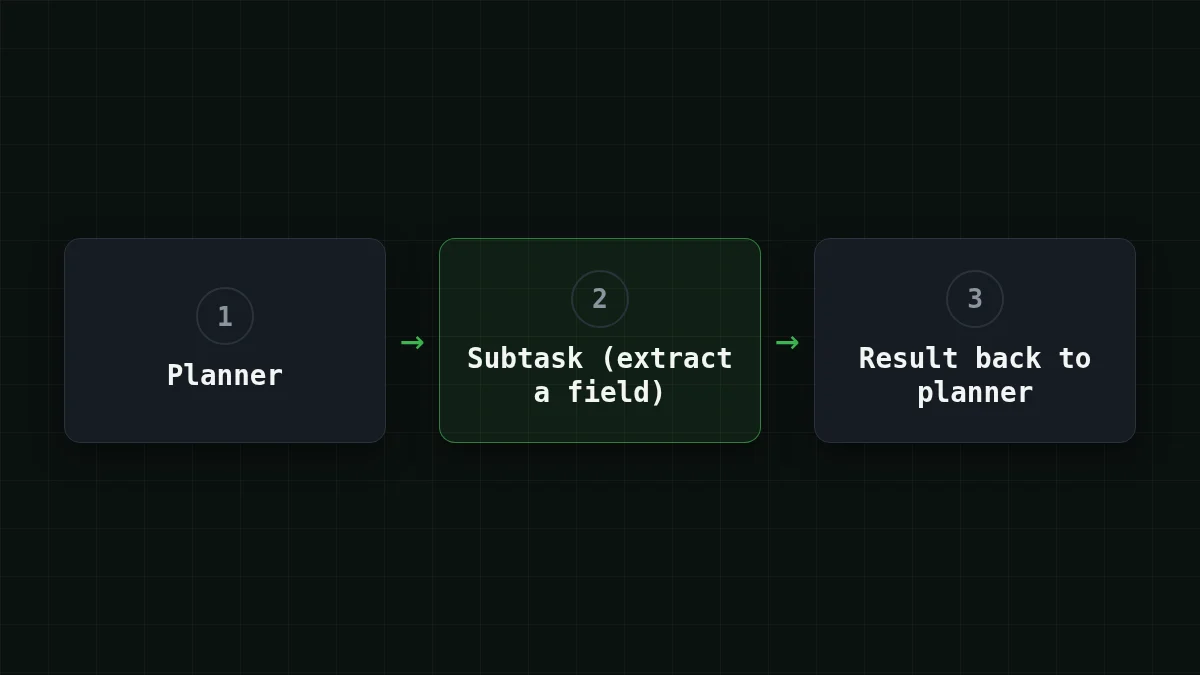
一般的なエージェント構成では、計画には大きなモデルを残し、繰り返されるサブタスクは安価なモデルに送ります。その2番目の席には、CheapTokensのDeepSeek-V4-Flashがあります: 380Kコンテキスト、回答あたり最大32,768出力トークン、ピーク時間なしでいつでも同一価格、OpenAIおよびAnthropic互換API、すべてのモデルで1つの残高。GLM-5.3-Flashはツール呼び出しループと長文書解析のもう1つの選択肢で、390Kコンテキストと最大8,192出力トークンです。DeepSeek-V4-Flashで自分のサブタスクを20個実行し、usageフィールドで結果を比較してください。
同じ50ステップのセッション(1ステップあたり入力20Kトークン、出力500トークン)をライブ価格で示します:
| モデル | 入力 $/1M | 出力 $/1M | リクエストあたり | 50 リクエスト | OpenRouter、50 リクエスト |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00042 | $0.021 | $0.0356 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00035 | $0.0175 | $0.0735 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0011 | $0.0538 | $0.645 |
リクエストあたり 20,000 入力トークンと 500 出力トークン。100万トークンあたりの価格は現行のもので、当社の料金体系に合わせて変動します。OpenRouter 列は同じワークロードの参考価格を示しています。
セッション全体のDeepSeek-V4-Flashの行は$0.0175です。入力と出力を合計すると、同じモデルのOpenRouterの参照価格より安くなります。このページの価格は自動で更新されます。
試すのに必要なのは1リクエストだけです。キーは環境変数に入れ、モデルIDはドキュメントの完全なものです(ドキュメントにリストがあり、価格は現在の料金です):
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Extract the order number from: Order #48213 shipped today."}],
    "max_tokens": 100
}'返信には通常のusageオブジェクトが含まれるので、サブタスクの実際の入力トークンと出力トークンを読み取り、上の表に当てはめられます。ルーティングパターン自体については、モデルルーティング: まず安価なモデル、エスカレーションを、モデルの詳細についてはCheapTokensのDeepSeekをご覧ください。
出力側に注意#
Emberのデフォルトの推論強度はmaxで、Meta自身のベンチマーク数値は主にその設定で実行されています。文書からフィールドを引き出すだけのサブタスクには不要であり、推論強度を上げると出力トークンが増える可能性があり、出力は高価な側です。Metaのページには推論トークンの計上方法が記載されていないため、推測せずにusageを読んでください。
自分で試す試してみましょう: 1つのサブタスクが実際にいくら使うかをどうやって調べますか?答えを表示
実際のサブタスクを20個、最低の強度設定で送信し、次にデフォルトで送信し、各返信のusageを読み取ります。平均入力と出力に1日あたりのステップ数を掛け、上の表のEmberの価格でコストを計算します。あなたのケースで回答が一致するなら、安い設定を維持するべきです。なぜそれが機能するかは推論強度と思考トークンにあります。
ビルダー向けの実用的な読み方: Emberはエージェントの安価な席向けに価格設定されており、200Kのラインが設計の基準となる数値であり、それを決める唯一の数字はあなた自身のusageフィールドから得られるものです。


