AI 뉴스업데이트
Meta Muse Ember API 가격: $0.10 / $0.50, 1M 컨텍스트
Meta의 Muse Ember: 가격 구간, 1M 컨텍스트, 512K 출력, 그리고 50단계 에이전트 세션 비용과 저렴한 하위 작업 대안.
이 페이지의 내용
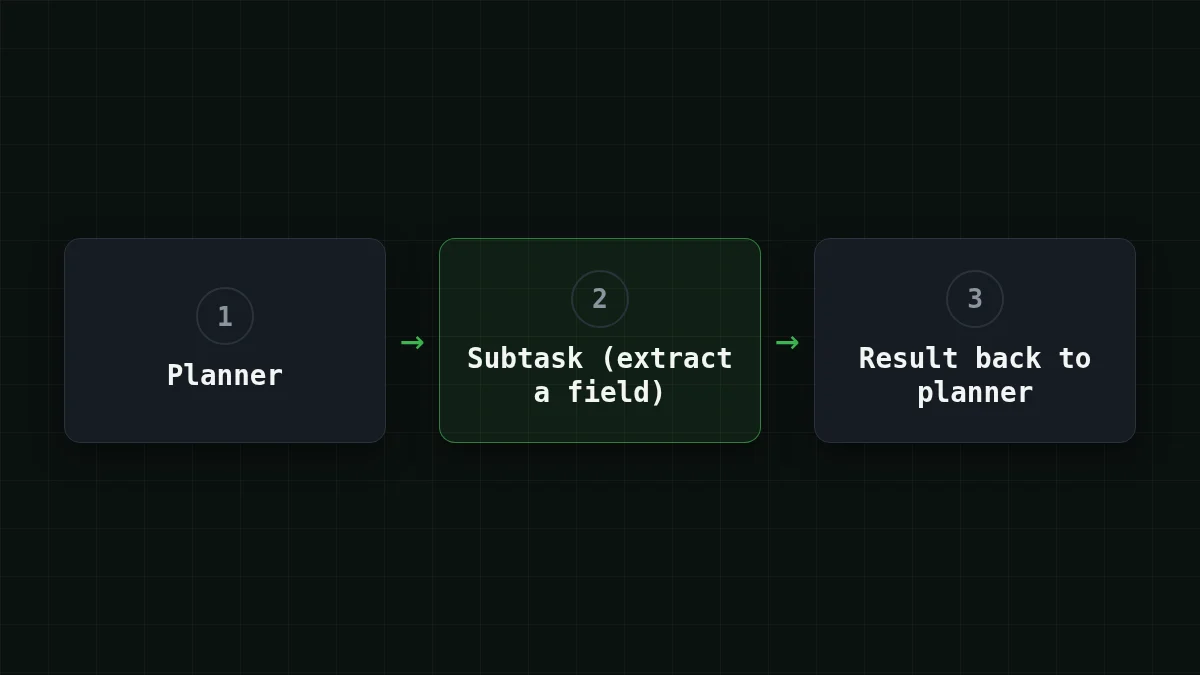
Meta의 새로운 Muse Ember는 에이전트 내부의 저렴하고 반복적인 단계를 위해 만들어진 소형 모델이며, Meta의 발표에 따르면 200K 토큰 이하 프롬프트에서 입력 100만 토큰당 $0.10, 출력 100만 토큰당 $0.50입니다. 200K를 넘으면 가격이 세 배가 됩니다. 단계당 입력 20K 토큰, 출력 500 토큰인 50단계 에이전트 세션은 Ember에서 약 $0.11이며, 같은 역할을 CheapTokens에서 DeepSeek-V4-Flash로 맡길 수 있습니다.
이 모델은 2026년 11월 9일 Meta의 연구 블로그(research.meta.ai/blog/muse-ember)에서 발표되었으며, 게시물에는 날짜만 있고 시각은 없습니다. 우리는 2026년 11월 10일에 블로그와 dev.meta.ai의 모델 페이지를 확인했습니다.
Meta가 발표한 내용#
Muse Ember(모델 id muse-ember-1.0)는 Meta의 Muse 라인에서 가장 작고 효율적인 모델로, 도구 호출, 추출, 라우팅, 긴 문서 파싱 같은 에이전트 하위 작업을 겨냥합니다. Muse Code, Meta Model API(Standard 모드 전용), Google Cloud, Oracle Cloud에서 사용할 수 있습니다. Meta는 오픈 가중치를 발표하지 않으므로 API와 Muse Code가 진입 경로입니다. 리전은 명시되지 않았습니다.
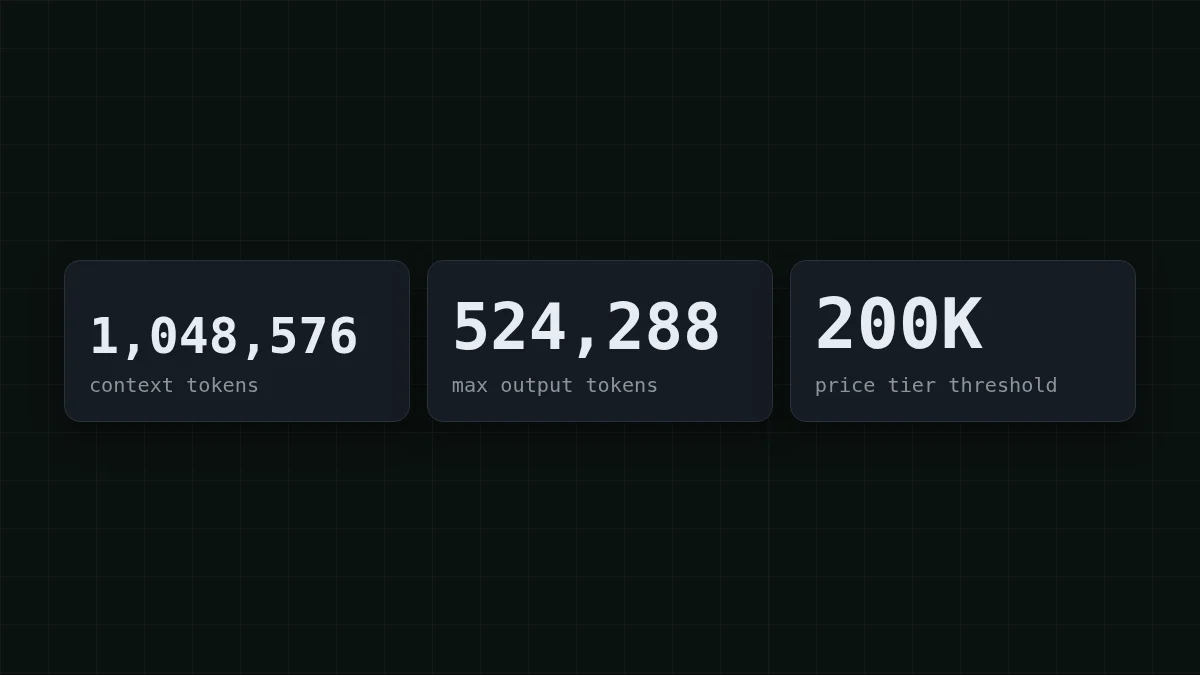
Meta의 모델 페이지(dev.meta.ai/docs/muse-ember, 페이지에 날짜 없음)에 나온 한도는 다음과 같습니다. 컨텍스트 윈도우 1,048,576 토큰, 최대 출력 524,288 토큰, 그리고 더 높은 가격 구간은 프롬프트가 200K 토큰을 넘을 때 시작됩니다.
입력으로 텍스트, 이미지, 비디오, 오디오, PDF를 받고 텍스트를 반환합니다. Responses, Chat Completions, Messages 엔드포인트를 통해 호출할 수 있으며, 도구 호출, 구조화된 출력, 컴퓨터 사용, 이미지 이해, 검색 그라운딩을 지원합니다. 추론 강도는 minimal부터 max까지이며 기본값은 max입니다. 스트리밍은 페이지에 언급되지 않았으므로 우리는 주장하지 않겠습니다.
Meta는 벤치마크 수치도 공개했는데, 이는 Meta의 것이며 대부분 max 추론 기준입니다. Terminal-Bench 4.0은 40.9%로 Haiku 5.5의 39.2%를 앞섰고, AutomationBench-AA는 37.8%로 Meta가 나열한 다른 두 모델의 13.9%와 20.2%를 앞섰으며, FrontierCode 2.0-AA는 27.2%로 Haiku 5.5의 34.9%에 뒤졌습니다. Artificial Analysis Intelligence Index에서는 36점으로 Muse Spark 1.3의 37점에 못 미칩니다. 직접 사례를 돌려보기 전까지는 벤더의 주장으로 취급하세요.
Ember에서 50단계 세션의 비용#
Meta 발표에 따른 가격표(모델 페이지 자체는 수치 없이 가격 페이지를 가리킴):
표를 오른쪽으로 스크롤하세요 →
| 프롬프트 크기 | 입력 | 캐시된 입력 | 출력 |
|---|---|---|---|
| 200K 토큰 이하 | $0.10 | $0.004 | $0.50 |
| 200K 토큰 초과 | $0.30 | $0.012 | $1.50 |
가격은 100만 토큰당이며 2026년 11월 10일 확인했습니다. 200K 초과 규칙에 대해 2차 출처들이 다르게 설명하므로, 예산을 잡기 전에 Meta의 가격 페이지에서 확인하세요.
이제 세션을 봅시다. 에이전트가 50단계를 수행하고, 각 단계에서 약 20K 토큰(늘어나는 이력과 도구 결과)을 보내고 약 500 토큰을 돌려받는다고 가정합니다. 총 입력 1M 토큰, 출력 25K 토큰입니다. Ember 기준: 1 × $0.10 + 0.025 × $0.50 = $0.1125(토큰 수는 백만 단위). 입력 쪽이 청구서의 거의 전부이므로, 에이전트가 같은 접두사를 유지한다면 캐시된 입력 가격 $0.004가 중요합니다.
숫자 맞히기
더 높은 요율이 전체 프롬프트에 적용된다고 가정합니다(Meta의 문구가 그렇게 읽힙니다). Ember에서 250K 토큰 프롬프트의 입력 비용은 몇 센트입니까?
내 추측
020
정답 보기
정답: 7.5
더 높은 요율이 전체 프롬프트에 적용된다면: 250,000 × $0.30/1M = $0.075이므로 입력만 7.5센트입니다. 그런 단계가 50개라면 입력 비용은 $3.75입니다.
왜 긴 프롬프트가 필요할까요? 에이전트는 매 단계마다 이력을 다시 보내기 때문입니다. 이게 처음이라면 에이전트가 전체 이력을 다시 읽는 이유에서 작은 예시로 설명합니다.
당신의 프롬프트는 어느 구간에 있나요?#
200K 선이 주목할 지점입니다. Meta는 더 긴 프롬프트에 대해 세 배 높은 요율을 나열합니다: 입력 $0.30, 캐시된 입력 $0.012, 출력 $1.50.
사례 선택하기
에이전트의 가장 큰 요청은 어디에 있나요?
답을 보려면 옵션을 선택하세요
200K 토큰 이하
낮은 구간에 머뭅니다. 입력 $0.10 / 출력 $0.50으로 예산을 잡고, 추론 강도를 기본값으로 유지한다면 출력 쪽을 주시하세요.
200K에서 1M 토큰 사이
더 높은 구간이 적용되며, Ember의 1,048,576 토큰 윈도우에 여전히 들어갑니다. 200K를 넘기 전에 오래된 도구 출력을 잘라내거나, 한 단계만 전체 문서를 담도록 작업을 나누세요.
1M 토큰 초과
한 요청에 들어가지 않습니다. 입력을 청크로 나누고 플래너가 결과를 병합하게 하세요.
CheapTokens에서 같은 저렴한 하위 작업 역할#
흔한 에이전트 구성은 계획에는 더 큰 모델을 두고 반복적인 하위 작업은 저렴한 모델로 보냅니다. 그 두 번째 자리에 CheapTokens는 DeepSeek-V4-Flash를 제공합니다: 380K 컨텍스트, 답변당 최대 32,768 출력 토큰, 피크 시간 없는 하루 종일 단일 가격, OpenAI 및 Anthropic 호환 API, 모든 모델에 걸친 단일 잔액. GLM-5.3-Flash는 도구 호출 루프와 긴 문서 파싱을 위한 또 다른 선택지로, 390K 컨텍스트와 최대 8,192 출력 토큰을 제공합니다. DeepSeek-V4-Flash에서 직접 하위 작업 20개를 돌리고 usage 필드로 결과를 비교해 보세요.
다음은 동일한 50단계 세션(단계당 입력 20K 토큰, 출력 500 토큰)을 실시간 가격으로 계산한 것입니다:
| 모델 | 입력 $/1M | 출력 $/1M | 요청당 | 50회 요청 | OpenRouter, 50회 요청 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00042 | $0.021 | $0.0356 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00035 | $0.0175 | $0.0735 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0011 | $0.0538 | $0.645 |
요청당 입력 20,000개 및 출력 500개 토큰입니다. 100만 토큰당 가격은 현재 기준이며 당사 요금제에 따라 함께 변경됩니다. OpenRouter 열은 동일한 작업량에 대한 참고 가격을 보여줍니다.
전체 세션에 대한 DeepSeek-V4-Flash 라인은 $0.0175이며, 입력과 출력을 합산하면 같은 모델에 대한 OpenRouter의 참조 가격보다 저렴합니다. 이 페이지의 가격은 자동으로 업데이트됩니다.
시험해 보는 데 요청 하나면 됩니다. 키는 환경 변수에 넣고, 모델 id는 문서의 전체 id를 사용하세요(문서에 목록이 있고 가격은 현재 요율입니다):
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Extract the order number from: Order #48213 shipped today."}],
    "max_tokens": 100
  }'
응답에는 일반적인 usage 객체가 있으므로 하위 작업의 실제 입력 및 출력 토큰을 읽어 위 표에 대입할 수 있습니다. 라우팅 패턴 자체는 모델 라우팅: 저렴한 모델 먼저, 에스컬레이션을, 모델에 대한 더 많은 내용은 CheapTokens의 DeepSeek을 참고하세요.
출력 쪽을 주시하세요#
Ember의 기본 추론 강도는 max이며, Meta 자체 벤치마크 수치도 대부분 그렇게 실행되었습니다. 문서에서 필드 하나만 뽑아내면 되는 하위 작업에는 필요 없으며, 추론 강도가 높을수록 더 비싼 쪽인 출력 토큰이 늘어날 수 있습니다. Meta의 페이지는 추론 토큰이 어떻게 계산되는지 말하지 않으므로, 추정하지 말고 usage를 읽으세요.
직접 해보기시험해 보기: 하위 작업 하나가 실제로 얼마를 쓰는지 어떻게 알 수 있나요?정답 보기
실제 하위 작업 20개를 가장 낮은 강도 설정으로 보낸 다음 기본값으로 보내고, 각 응답에서 usage를 읽으세요. 평균 입력과 출력에 하루 단계 수를 곱하고 위 표의 Ember 가격으로 비용을 계산하세요. 당신의 사례에서 답이 같다면 더 저렴한 설정을 유지하면 됩니다. 그 이유는 추론 강도와 사고 토큰에 있습니다.
빌더를 위한 실용적 해석: Ember는 에이전트의 저렴한 자리를 위해 가격이 책정되었고, 200K 선이 설계 기준이 되는 수치이며, 이를 확정하는 유일한 수치는 당신 자신의 usage 필드에서 나옵니다.


