Noticias de IAActualización
Precio de la API de Meta Muse Ember: $0.10 / $0.50, contexto de 1M
Muse Ember de Meta: tramos de precio, contexto de 1M, salida de 512K y lo que cuesta una sesión de agente de 50 pasos, con una alternativa barata para subtareas.
En esta página
El nuevo Muse Ember de Meta es un modelo pequeño pensado para los pasos baratos y repetidos dentro de un agente, y según el anuncio de Meta cuesta $0.10 por entrada y $0.50 por salida por 1M de tokens en prompts de hasta 200K tokens. Por encima de 200K el precio se triplica. Una sesión de agente de 50 pasos con 20K tokens de entrada y 500 de salida por paso sale a unos $0.11 en Ember, y ese mismo rol lo tienes disponible en CheapTokens con DeepSeek-V4-Flash.
El modelo se anunció el 9 de noviembre de 2026 en el blog de investigación de Meta (research.meta.ai/blog/muse-ember); la entrada muestra fecha pero no hora. Consultamos el blog y la página del modelo en dev.meta.ai el 10 de noviembre de 2026.
Qué anunció Meta#
Muse Ember (id de modelo muse-ember-1.0) es el modelo más pequeño y eficiente de la línea Muse de Meta, orientado a subtareas de agentes: llamadas a herramientas, extracción, enrutamiento, análisis de documentos largos. Puedes acceder a él en Muse Code, la Meta Model API (solo en modo Standard), Google Cloud y Oracle Cloud. Meta no anuncia pesos abiertos, así que la API y Muse Code son la vía de entrada. No se indican regiones.
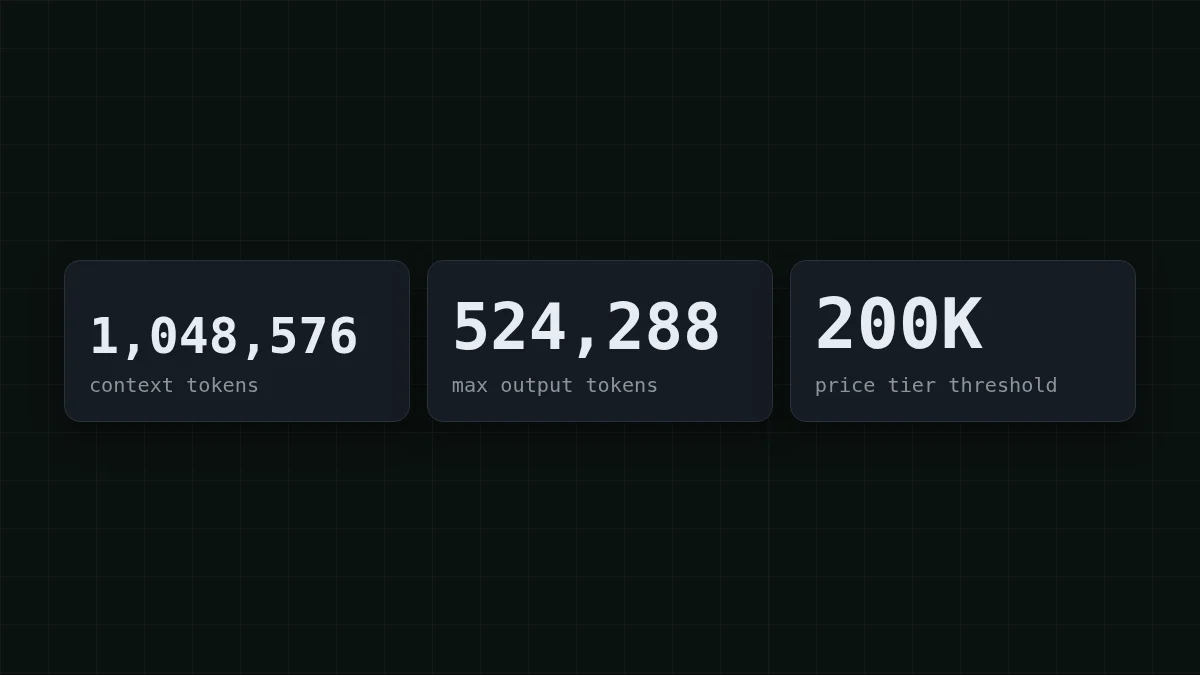
Los límites de la página del modelo de Meta (dev.meta.ai/docs/muse-ember, sin fecha en la página). Ventana de contexto — 1.048.576 tokens, salida máxima — 524.288 tokens, y el tramo de precio superior empieza por encima de 200K tokens de prompt.
Acepta texto, imagen, vídeo, audio y PDF como entrada y devuelve texto. Puedes llamarlo a través de los endpoints Responses, Chat Completions o Messages, con llamadas a herramientas, salida estructurada, uso de ordenador, comprensión de imágenes y grounding con búsqueda. El esfuerzo de razonamiento va de mínimo a máximo, y el valor por defecto es máximo. La página no menciona streaming, así que no lo afirmamos.
Meta también publicó cifras de benchmarks, y son de Meta, en su mayoría con razonamiento máximo: Terminal-Bench 4.0 al 40,9% frente al 39,2% de Haiku 5.5, AutomationBench-AA al 37,8% frente al 13,9% y 20,2% de los otros dos que Meta enumera, y FrontierCode 2.0-AA al 27,2%, por detrás de Haiku 5.5 con 34,9%. En el Artificial Analysis Intelligence Index obtiene 36 frente a 37 de Muse Spark 1.3. Tómalas como afirmación del proveedor hasta que pruebes tus propios casos.
Cuánto cuesta una sesión de 50 pasos en Ember#
La tabla de precios, según el anuncio de Meta (la propia página del modelo remite a una página de precios sin cifras):
Desplaza la tabla hacia la derecha →
| Tamaño del prompt | Entrada | Entrada en caché | Salida |
|---|---|---|---|
| hasta 200K tokens | $0.10 | $0.004 | $0.50 |
| más de 200K tokens | $0.30 | $0.012 | $1.50 |
Los precios son por 1M de tokens, consultados el 10 de noviembre de 2026. Las fuentes secundarias describen de forma distinta la regla de más de 200K, así que confírmala en la página de precios de Meta antes de presupuestar en torno a ella.
Ahora una sesión. Supón que tu agente hace 50 pasos, y cada paso envía unos 20K tokens (el historial creciente más los resultados de herramientas) y recibe unos 500 tokens de vuelta. Eso son 1M de tokens de entrada y 25K de salida en total. En Ember: 1 × $0.10 + 0.025 × $0.50 = $0.1125 (recuentos de tokens en millones). El lado de entrada es casi toda la factura, por eso importa el precio de entrada en caché de $0.004 si tu agente mantiene el mismo prefijo.
Adivina el número
Supón que la tarifa superior se aplica a todo el prompt (así se lee la redacción de Meta). ¿Cuántos céntimos cuesta la entrada de un prompt de 250K tokens en Ember?
Tu respuesta
020
Mostrar respuesta
Respuesta: 7,5
Si la tarifa superior se aplica a todo el prompt: 250.000 × $0.30 por 1M = $0.075, es decir, 7,5 céntimos solo por la entrada. Cincuenta pasos así serían $3.75 de entrada.
¿Por qué prompts largos? Porque los agentes reenvían el historial en cada paso; si es nuevo para ti, por qué un agente relee todo su historial lo explica con un ejemplo pequeño.
¿En qué tramo está tu prompt?#
La línea de 200K es la que hay que vigilar. Meta indica tarifas tres veces más altas para prompts más largos: $0.30 por entrada, $0.012 por entrada en caché y $1.50 por salida.
Elige tu caso
¿Dónde se sitúa la petición más grande de tu agente?
Elige una opción para ver la respuesta
Menos de 200K tokens
Te quedas en el tramo inferior. Presupuesta con $0.10 de entrada / $0.50 de salida y vigila el lado de salida si mantienes el esfuerzo de razonamiento en el valor por defecto.
Entre 200K y 1M tokens
Se aplica el tramo superior, y la ventana de 1.048.576 tokens de Ember todavía te cubre. Recorta la salida antigua de herramientas antes de que cruce los 200K, o divide el trabajo para que solo un paso lleve el documento completo.
Más de 1M tokens
No cabe en una sola petición. Trocea la entrada y deja que un planificador combine los resultados.
El mismo rol de subtarea barata en CheapTokens#
Un diseño habitual de agente reserva un modelo más grande para planificar y envía las subtareas repetidas a uno barato. Para ese segundo asiento, CheapTokens tiene DeepSeek-V4-Flash: 380K de contexto, hasta 32.768 tokens de salida por respuesta, un único precio a cualquier hora del día sin horas punta, una API compatible con OpenAI y Anthropic, y un solo saldo para todos los modelos. GLM-5.3-Flash es la otra opción para bucles de llamadas a herramientas y análisis de documentos largos, con 390K de contexto y hasta 8.192 tokens de salida. Ejecuta 20 de tus propias subtareas en DeepSeek-V4-Flash y compara los resultados por el campo usage.
Aquí está la misma sesión de 50 pasos, 20K tokens de entrada y 500 de salida por paso, con precio en vivo:
| Modelo | Entrada $/1M | Salida $/1M | Por solicitud | 50 solicitudes | OpenRouter, 50 solicitudes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00042 | $0.021 | $0.0356 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00035 | $0.0175 | $0.0735 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0011 | $0.0538 | $0.645 |
20.000 tokens de entrada y 500 tokens de salida por solicitud. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
La línea de DeepSeek-V4-Flash para toda la sesión es $0.0175; en total, contando entrada y salida juntas, sale más barata que el precio de referencia de OpenRouter para el mismo modelo. Los precios de esta página se actualizan solos.
Probarlo requiere una petición. La clave va en una variable de entorno, y el id de modelo es el completo de la documentación (la documentación tiene la lista; precios las tarifas actuales):
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Extract the order number from: Order #48213 shipped today."}],
    "max_tokens": 100
  }'
La respuesta tiene el objeto usage habitual, así que puedes leer los tokens reales de entrada y salida de tu subtarea y meterlos en la tabla de arriba. Para el patrón de enrutamiento en sí, consulta enrutamiento de modelos: primero el barato, escalar después y, para más sobre el modelo, DeepSeek en CheapTokens.
Vigila el lado de la salida#
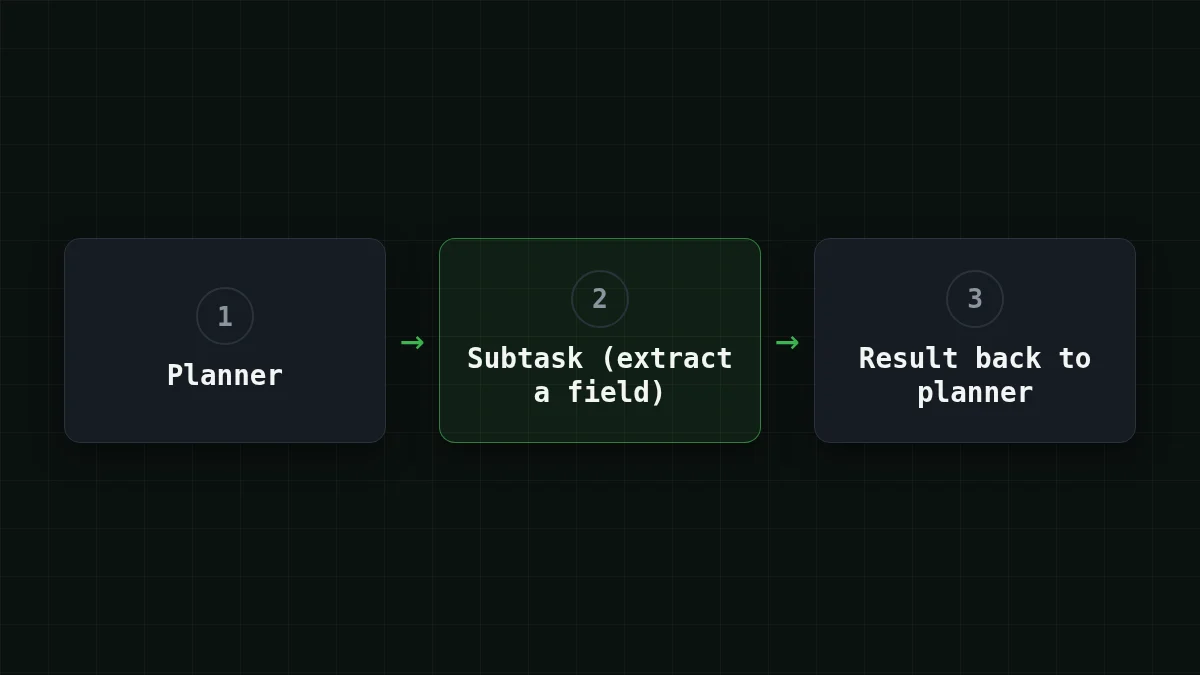
El esfuerzo de razonamiento por defecto de Ember es máximo, y las propias cifras de benchmarks de Meta se ejecutaron en su mayoría así. Una subtarea que solo tiene que extraer un campo de un documento no lo necesita, y un mayor esfuerzo de razonamiento puede significar más tokens de salida, el lado más caro. Las páginas de Meta no dicen cómo se cuentan los tokens de razonamiento, así que lee usage en lugar de suponerlo.
Pruébalo tú mismoPruébalo: ¿cómo averiguas lo que gasta realmente una subtarea?Mostrar respuesta
Envía 20 subtareas reales con el ajuste de esfuerzo más bajo, luego con el valor por defecto, y lee usage en cada respuesta. Multiplica la media de entrada y salida por tus pasos al día y calcula el coste con los precios de Ember de la tabla de arriba. Si las respuestas coinciden en tus casos, el ajuste más barato es el que conviene mantener. Por qué funciona está en esfuerzo de razonamiento y tokens de pensamiento.
La lectura práctica para quienes construyen: Ember tiene precio para el asiento barato de un agente, la línea de 200K es la cifra en torno a la que diseñar, y la única cifra que lo decide es la de tu propio campo usage.


