AI 新闻更新
Meta Muse Ember API 价格:$0.10 / $0.50,1M 上下文
Meta 的 Muse Ember:价格档位、1M 上下文、512K 输出,以及一个 50 步智能体会话的成本,并附有廉价子任务替代方案。
Meta 的新模型 Muse Ember 是一个小模型,专为智能体内部廉价、重复的步骤而构建。根据 Meta 的公告,在提示词不超过 200K token 时,每 1M token 的输入价格为 $0.10,输出价格为 $0.50。超过 200K 后,价格变为三倍。一个 50 步的智能体会话,每步输入 20K token、输出 500 token,在 Ember 上大约花费 $0.11;而在 CheapTokens 上,DeepSeek-V4-Flash 也能承担同样的角色。
该模型于 2026 年 11 月 9 日在 Meta 的研究博客(research.meta.ai/blog/muse-ember)上发布;帖子显示了日期,但没有时间。我们于 2026 年 11 月 10 日查看了该博客以及 dev.meta.ai 上的模型页面。
Meta 公布了什么#
Muse Ember(模型 ID muse-ember-1.0)是 Meta Muse 系列中最小、最高效的模型,面向智能体子任务:工具调用、信息提取、路由、解析长文档。你可以通过 Muse Code、Meta Model API(仅 Standard 模式)、Google Cloud 和 Oracle Cloud 访问它。Meta 没有公布开放权重,因此 API 和 Muse Code 是唯一的接入方式。区域未说明。
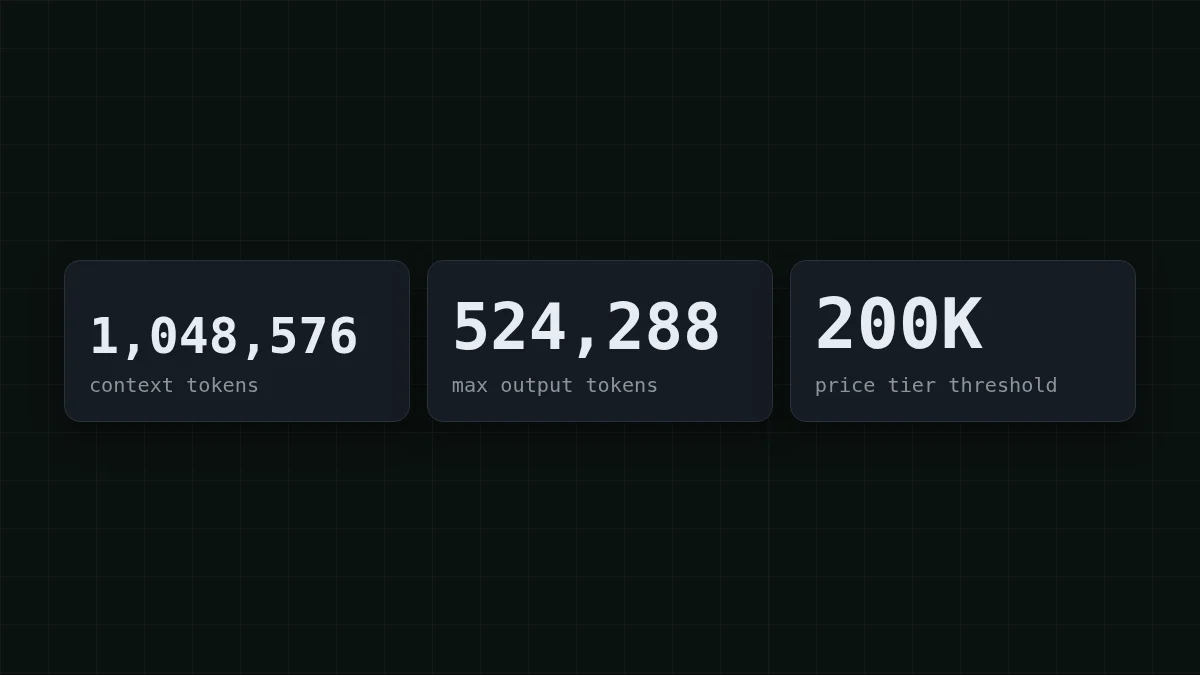
来自 Meta 模型页面(dev.meta.ai/docs/muse-ember,页面上没有日期)的限制:上下文窗口为 1,048,576 token,最大输出为 524,288 token,更高的价格档位从提示词超过 200K token 开始。
它接受文本、图像、视频、音频和 PDF 作为输入,并返回文本。你可以通过 Responses、Chat Completions 或 Messages 端点调用它,支持工具调用、结构化输出、计算机使用、图像理解和搜索接地。推理强度从 minimal 到 max,默认值为 max。页面上没有提到流式传输,因此我们不会声称支持。
Meta 还公布了基准测试数据,这些数据来自 Meta,大多在 max 推理强度下运行:Terminal-Bench 4.0 为 40.9%,而 Haiku 5.5 为 39.2%;AutomationBench-AA 为 37.8%,而 Meta 列出的另外两个模型分别为 13.9% 和 20.2%;FrontierCode 2.0-AA 为 27.2%,落后于 Haiku 5.5 的 34.9%。在 Artificial Analysis Intelligence Index 上,它得分为 36,而 Muse Spark 1.3 为 37。在你运行自己的用例之前,请将这些视为厂商的声明。
在 Ember 上,一个 50 步会话的成本#
价格表,依据 Meta 的公告(模型页面本身指向一个没有数字的定价页面):
向右滚动表格 →
| 提示词大小 | 输入 | 缓存输入 | 输出 |
|---|---|---|---|
| 不超过 200K token | $0.10 | $0.004 | $0.50 |
| 超过 200K token | $0.30 | $0.012 | $1.50 |
价格按每 1M token 计算,查看于 2026 年 11 月 10 日。二手来源对超过 200K 的规则描述不同,因此在围绕它做预算之前,请在 Meta 的定价页面上确认。
现在来看一个会话。假设你的智能体执行 50 步,每步发送约 20K token(不断增长的历史记录加上工具结果),并收到约 500 token 的返回。总计输入 1M token,输出 25K token。在 Ember 上:1 × $0.10 + 0.025 × $0.50 = $0.1125(token 数量以百万计)。输入侧几乎占了全部账单,这就是为什么如果你的智能体保持相同前缀,$0.004 的缓存输入价格很重要。
猜数字
假设更高费率适用于整个提示词(Meta 的措辞读起来是这样)。在 Ember 上,一个 250K token 提示词的输入需要多少美分?
你的猜测
020
显示答案
答案: 7.5
如果更高费率适用于整个提示词:250,000 × 每 1M $0.30 = $0.075,因此仅输入就需要 7.5 美分。五十个这样的步骤将产生 $3.75 的输入费用。
为什么需要长提示词?因为智能体在每一步都会重新发送历史记录;如果这对你来说是新概念,为什么智能体会重新读取其完整历史记录用一个小例子解释了这一点。
你的提示词属于哪个档位?#
200K 这条线是需要关注的。Meta 列出的更长提示词费率是三倍:输入 $0.30,缓存输入 $0.012,输出 $1.50。
选择你的情况
你的智能体最大的请求位于哪里?
选择一个选项以查看答案
低于 200K token
你处于较低档位。按输入 $0.10 / 输出 $0.50 做预算,如果你保持默认推理强度,请关注输出侧。
在 200K 到 1M token 之间
适用更高档位,而 Ember 的 1,048,576 token 窗口仍然适合你。在旧工具输出超过 200K 之前将其裁剪,或者拆分任务,使只有一步携带完整文档。
超过 1M token
它无法放入单个请求。将输入分块,并让规划器合并结果。
CheapTokens 上的同样廉价子任务角色#
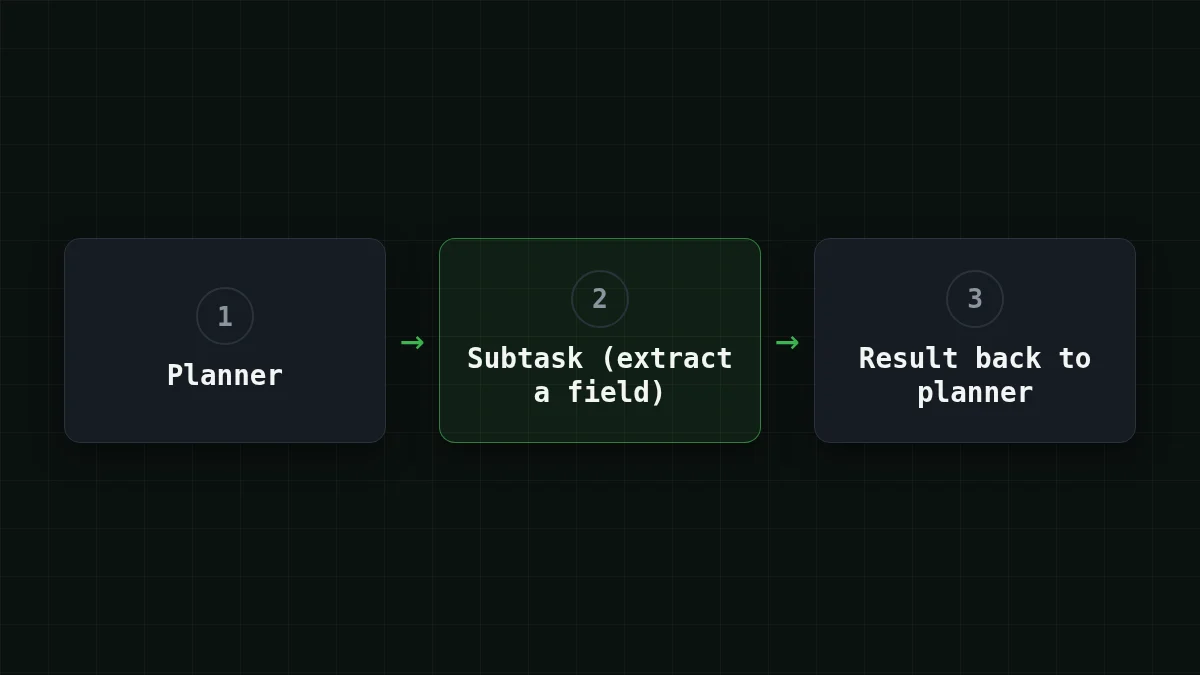
一种常见的智能体布局是保留一个更大的模型用于规划,并将重复的子任务发送给一个廉价模型。对于第二个位置,CheapTokens 提供 DeepSeek-V4-Flash:380K 上下文,每次回答最多 32,768 输出 token,全天统一价格,没有高峰时段,提供 OpenAI 和 Anthropic 兼容的 API,并且所有模型共用一个余额。GLM-5.3-Flash 是工具调用循环和长文档解析的另一个选择,具有 390K 上下文和最多 8,192 输出 token。在 DeepSeek-V4-Flash 上运行 20 个你自己的子任务,并按 usage 字段比较结果。
以下是同样的 50 步会话,每步输入 20K token、输出 500 token,实时定价:
| 模型 | 输入 $/1M | 输出 $/1M | 每次请求 | 50 次请求 | OpenRouter,50 次请求 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00042 | $0.021 | $0.0356 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00035 | $0.0175 | $0.0735 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0011 | $0.0538 | $0.645 |
每次请求 20,000 个输入 token 和 500 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
整个会话的 DeepSeek-V4-Flash 费用为 $0.0175;总计,将输入和输出加在一起,它比 OpenRouter 对同一模型的参考价格更便宜。此页面上的价格会自动更新。
尝试它只需要一个请求。密钥放在环境变量中,模型 ID 是文档中的完整 ID(文档中有列表;定价是当前费率):
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Extract the order number from: Order #48213 shipped today."}],
    "max_tokens": 100
  }'
回复包含通常的 usage 对象,因此你可以读取子任务的真实输入和输出 token,并将它们代入上面的表格。关于路由模式本身,请参阅模型路由:先使用廉价模型,再升级,以及关于该模型的更多信息,请参阅CheapTokens 上的 DeepSeek。
关注输出侧#
Ember 的默认推理强度是 max,而 Meta 自己的基准测试数据大多是以这种方式运行的。一个只需要从文档中提取字段的子任务不需要它,而更高的推理强度可能意味着更多的输出 token,也就是更贵的一侧。Meta 的页面没有说明推理 token 如何计数,因此请阅读 usage 而不是假设。
自己试试试一试:你如何找出一个子任务真正花费多少?显示答案
在最低推理强度设置下发送 20 个真实子任务,然后在默认设置下发送,并读取每个回复中的 usage。将平均输入和输出乘以你每天的步数,并根据上面表格中的 Ember 价格计算成本。如果在你自己的用例上答案一致,那么更便宜的设置就是应该保留的设置。为什么这有效,请参阅推理强度与思考 token。
对构建者的实用解读:Ember 的定价适合智能体中的廉价位置,200K 这条线是设计时需要围绕的数字,而唯一能确定它的数字来自你自己的 usage 字段。


