Balitang AIUpdate
Presyo ng Meta Muse Ember API: $0.10 / $0.50, 1M context
Meta's Muse Ember: mga tier ng presyo, 1M context, 512K output, at magkano ang isang 50-hakbang na sesyon ng agent, kasama ang isang murang-subtask na alternatibo.
Sa pahinang ito
Ang bagong Muse Ember ng Meta ay isang maliit na modelo na ginawa para sa mura at paulit-ulit na mga hakbang sa loob ng isang agent, at ayon sa anunsyo ng Meta, nagkakahalaga ito ng $0.10 para sa input at $0.50 para sa output kada 1M token sa mga prompt na hanggang 200K token. Sa ibabaw ng 200K, triple ang presyo. Ang isang 50-hakbang na sesyon ng agent na 20K token ang input at 500 ang output kada hakbang ay umaabot sa humigit-kumulang $0.11 sa Ember, at ang parehong papel ay bukas sa iyo sa CheapTokens gamit ang DeepSeek-V4-Flash.
Inanunsyo ang modelo noong Nobyembre 9, 2026 sa research blog ng Meta (research.meta.ai/blog/muse-ember); may petsa ang post ngunit walang oras. Sinuri namin ang blog at ang pahina ng modelo sa dev.meta.ai noong Nobyembre 10, 2026.
Ano ang inanunsyo ng Meta#
Ang Muse Ember (model id muse-ember-1.0) ay ang pinakamaliit at pinakaepektibong modelo sa linya ng Muse ng Meta, na nakatuon sa mga subtask ng agent: mga tool call, extraction, routing, pag-parse ng mahahabang dokumento. Maaari mo itong maabot sa Muse Code, sa Meta Model API (Standard mode lamang), Google Cloud at Oracle Cloud. Hindi inaanunsyo ng Meta ang open weights, kaya API at Muse Code ang paraan ng pagpasok. Hindi nakasaad ang mga rehiyon.
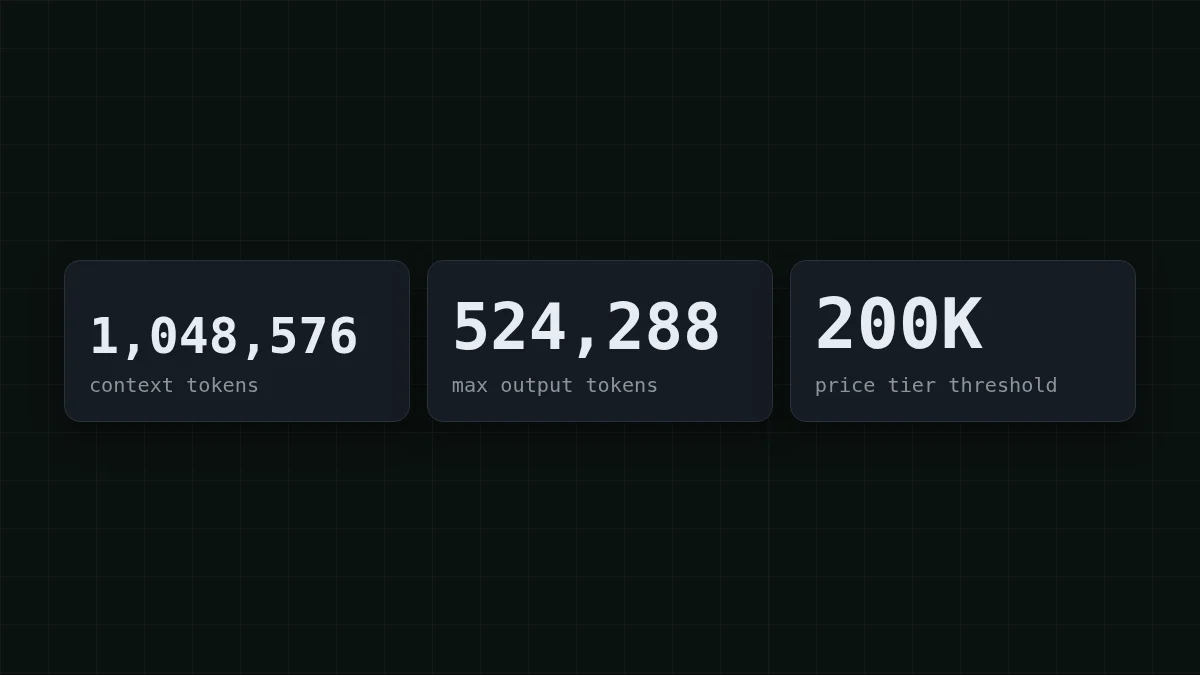
Ang mga limitasyon mula sa pahina ng modelo ng Meta (dev.meta.ai/docs/muse-ember, walang petsa sa pahina). Context window — 1,048,576 token, maximum na output — 524,288 token, at ang mas mataas na tier ng presyo ay nagsisimula sa ibabaw ng 200K token ng prompt.
Tumatanggap ito ng text, image, video, audio at PDF bilang input at nagbabalik ng text. Maaari mo itong tawagan sa pamamagitan ng Responses, Chat Completions o Messages endpoints, na may tool calling, structured output, computer use, image understanding at search grounding. Ang reasoning effort ay mula minimal hanggang max, at ang default ay max. Hindi binanggit ang streaming sa pahina, kaya hindi namin ito i-aangkin.
Naglathala rin ang Meta ng mga benchmark na numero, at sila ng Meta, karamihan ay nasa max reasoning: Terminal-Bench 4.0 sa 40.9% laban sa 39.2% para sa Haiku 5.5, AutomationBench-AA sa 37.8% laban sa 13.9% at 20.2% para sa dalawa pang nakalista ng Meta, at FrontierCode 2.0-AA sa 27.2%, nasa likod ng Haiku 5.5 sa 34.9%. Sa Artificial Analysis Intelligence Index, nakakuha ito ng 36 laban sa 37 para sa Muse Spark 1.3. Ituring ang mga ito bilang claim ng vendor hanggang sa magpatakbo ka ng sarili mong mga kaso.
Magkano ang isang 50-hakbang na sesyon sa Ember#
Ang talahanayan ng presyo, ayon sa anunsyo ng Meta (ang pahina ng modelo mismo ay tumuturo sa isang pricing page na walang numero):
I-scroll ang table pakanan →
| Prompt size | Input | Cached input | Output |
|---|---|---|---|
| up to 200K tokens | $0.10 | $0.004 | $0.50 |
| over 200K tokens | $0.30 | $0.012 | $1.50 |
Ang mga presyo ay kada 1M token, sinuri noong Nobyembre 10, 2026. Iba-iba ang paglalarawan ng mga sekondaryang source sa over-200K na panuntunan, kaya kumpirmahin ito sa pricing page ng Meta bago ka mag-budget dito.
Ngayon, isang sesyon. Sabihin nating ang iyong agent ay gumagawa ng 50 hakbang, at ang bawat hakbang ay nagpapadala ng humigit-kumulang 20K token (ang lumalaking history kasama ang mga tool result) at nakakakuha ng humigit-kumulang 500 token pabalik. Iyon ay 1M token ang input at 25K ang output sa kabuuan. Sa Ember: 1 × $0.10 + 0.025 × $0.50 = $0.1125 (ang mga token count ay nasa milyon). Ang input side ang halos buong bill, kaya mahalaga ang cached-input na presyo na $0.004 kung ang iyong agent ay nagpapanatili ng parehong prefix.
Hulaan ang numero
Sabihin nating ang mas mataas na rate ay nalalapat sa buong prompt (ganito ang basa sa pananalita ng Meta). Ilang sentimo ang input ng isang 250K-token na prompt sa Ember?
Ang iyong hula
020
Ipakita ang sagot
Sagot: 7.5
Kung ang mas mataas na rate ay nalalapat sa buong prompt: 250,000 × $0.30 kada 1M = $0.075, kaya 7.5 sentimo para sa input lamang. Limampung ganoong hakbang ay $3.75 na input.
Bakit mahahabang prompt? Dahil ipinapadala muli ng mga agent ang history sa bawat hakbang; kung bago ito sa iyo, ipinapaliwanag ng bakit binabasa muli ng isang agent ang buong history nito ito gamit ang isang maliit na halimbawa.
Sa aling tier naroroon ang iyong prompt?#
Ang 200K na linya ang dapat bantayan. Naglilista ang Meta ng tatlong beses na mas mataas na rate para sa mas mahahabang prompt: $0.30 para sa input, $0.012 para sa cached input at $1.50 para sa output.
Piliin ang iyong kaso
Saan naroroon ang pinakamalaking request ng iyong agent?
Pumili ng opsyon upang makita ang sagot
Wala pang 200K token
Nananatili ka sa mas mababang tier. Mag-budget gamit ang $0.10 in / $0.50 out at bantayan ang output side kung pinapanatili mo ang reasoning effort sa default.
Sa pagitan ng 200K at 1M token
Nalalapat ang mas mataas na tier, at kasya ka pa rin sa 1,048,576-token na window ng Ember. Bawasan ang lumang tool output bago ito lumampas sa 200K, o hatiin ang trabaho para isang hakbang lang ang may buong dokumento.
Mahigit 1M token
Hindi ito kasya sa isang request. Hatiin ang input at hayaang ang isang planner ang mag-merge ng mga resulta.
Ang parehong murang-subtask na papel sa CheapTokens#
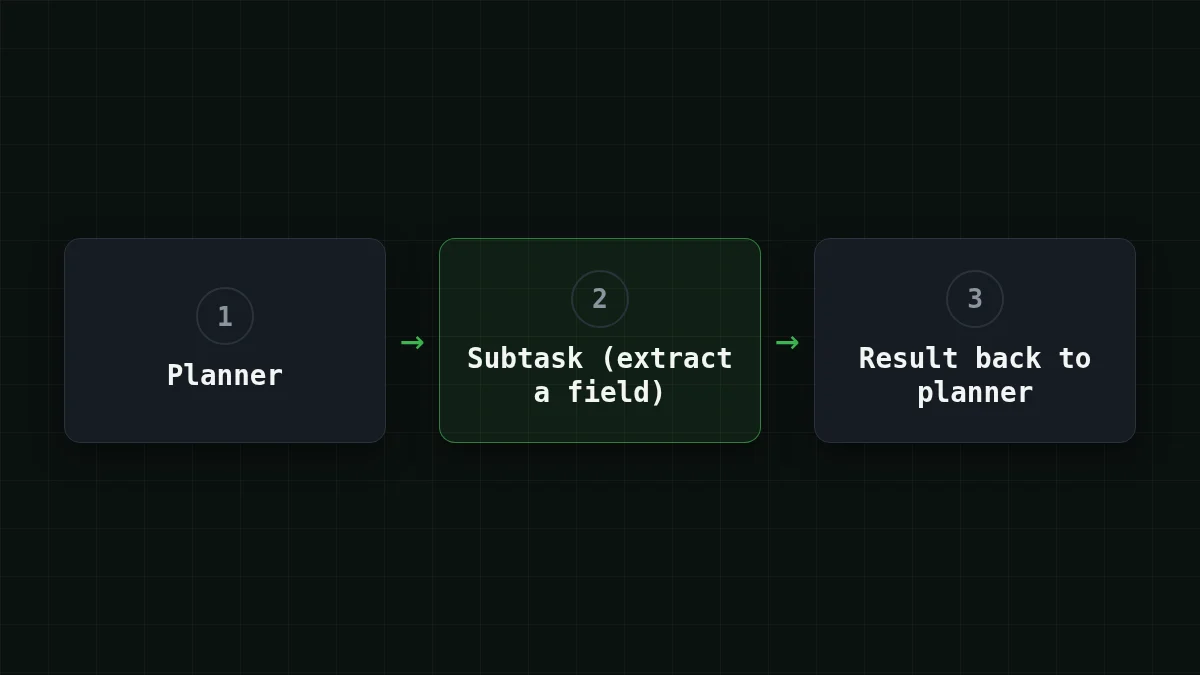
Ang karaniwang layout ng agent ay nagpapanatili ng mas malaking modelo para sa pagpaplano at ipinapadala ang mga paulit-ulit na subtask sa isang mura. Para sa pangalawang puwesto na iyon, mayroon ang CheapTokens ng DeepSeek-V4-Flash: isang 380K context, hanggang 32,768 output token kada sagot, isang presyo sa anumang oras ng araw na walang peak hours, isang OpenAI- at Anthropic-compatible na API, at isang balanse sa lahat ng modelo. Ang GLM-5.3-Flash ang iba pang opsyon para sa mga tool-call loop at pag-parse ng mahahabang dokumento, na may 390K context at hanggang 8,192 output token. Patakbuhin ang 20 sa sarili mong mga subtask sa DeepSeek-V4-Flash at ihambing ang mga resulta sa pamamagitan ng usage field.
Narito ang parehong 50-hakbang na sesyon, 20K token ang input at 500 ang output kada hakbang, na naka-live na presyo:
| Modelo | Input $/1M | Output $/1M | Bawat kahilingan | 50 mga kahilingan | OpenRouter, 50 mga kahilingan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00042 | $0.021 | $0.0356 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00035 | $0.0175 | $0.0735 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0011 | $0.0538 | $0.645 |
20,000 input at 500 output na token bawat kahilingan. Ang mga presyo kada 1M token ay kasalukuyan at nagbabago kasabay ng aming mga taripa; ang column ng OpenRouter ay nagpapakita ng reference na presyo para sa parehong workload.
Ang linya ng DeepSeek-V4-Flash para sa buong sesyon ay $0.0175; sa kabuuan, kasama ang input at output na binilang nang magkasama, mas mura ito kaysa sa reference na presyo ng OpenRouter para sa parehong modelo. Ang mga presyo sa pahinang ito ay nag-a-update nang kusa.
Isang request lang ang pagsubok nito. Ang key ay inilalagay sa isang environment variable, at ang model id ay ang buong isa mula sa docs (ang docs ay may listahan; pricing ang kasalukuyang mga rate):
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Extract the order number from: Order #48213 shipped today."}],
    "max_tokens": 100
  }'
Ang sagot ay may karaniwang usage object, kaya mababasa mo ang tunay na input at output token ng iyong subtask at maipasok ang mga ito sa talahanayan sa itaas. Para sa routing pattern mismo, tingnan ang model routing: cheap model first, escalate at, para sa higit pa tungkol sa modelo, DeepSeek on CheapTokens.
Bantayan ang output side#
Ang default na reasoning effort ng Ember ay max, at ang sariling benchmark na numero ng Meta ay karamihan ay pinatakbo sa ganoong paraan. Ang isang subtask na kailangan lang maghango ng isang field mula sa isang dokumento ay hindi nangangailangan nito, at ang mas mataas na reasoning effort ay maaaring mangahulugan ng mas maraming output token, ang mas mahal na side. Hindi sinasabi ng mga pahina ng Meta kung paano binibilang ang reasoning token, kaya basahin ang usage sa halip na ipagpalagay.
Subukan mo mismoSubukan: paano mo malalaman kung magkano talaga ang ginagastos ng isang subtask?Ipakita ang sagot
Magpadala ng 20 tunay na subtask sa pinakamababang effort setting, pagkatapos sa default, at basahin ang usage sa bawat sagot. I-multiply ang average na input at output sa iyong mga hakbang kada araw at kalkulahin ang gastos sa mga presyo ng Ember mula sa talahanayan sa itaas. Kung magkatugma ang mga sagot sa iyong mga kaso, ang mas murang setting ang panatilihin. Bakit gumagana iyon ay nasa reasoning effort and thinking tokens.
Ang praktikal na pagbasa para sa mga builder: ang Ember ay may presyo para sa murang puwesto sa isang agent, ang 200K na linya ang numero na dapat pagdisenyoan, at ang tanging figure na magpapasya nito ay ang mula sa sarili mong usage field.


