Novità AIAggiornamento
Prezzo API di Meta Muse Ember: $0,10 / $0,50, contesto da 1M
Muse Ember di Meta: fasce di prezzo, contesto da 1M, output da 512K e quanto costa una sessione di agente da 50 passaggi, con un'alternativa economica per i sotto-compiti.
In questa pagina
Il nuovo Muse Ember di Meta è un modello piccolo pensato per i passaggi economici e ripetuti all'interno di un agente e, secondo l'annuncio di Meta, costa $0,10 per l'input e $0,50 per l'output per 1M di token su prompt fino a 200K token. Oltre i 200K il prezzo triplica. Una sessione di agente da 50 passaggi con 20K token in input e 500 in output per passaggio arriva a circa $0,11 su Ember, e lo stesso ruolo è disponibile per te su CheapTokens con DeepSeek-V4-Flash.
Il modello è stato annunciato il 9 novembre 2026 sul blog di ricerca di Meta (research.meta.ai/blog/muse-ember); il post mostra una data ma nessun orario. Abbiamo controllato il blog e la pagina del modello su dev.meta.ai il 10 novembre 2026.
Cosa ha annunciato Meta#
Muse Ember (id del modello muse-ember-1.0) è il modello più piccolo ed efficiente della linea Muse di Meta, pensato per i sotto-compiti degli agenti: chiamate a tool, estrazione, routing, parsing di documenti lunghi. Puoi raggiungerlo in Muse Code, nella Meta Model API (solo modalità Standard), su Google Cloud e Oracle Cloud. Meta non annuncia pesi aperti, quindi API e Muse Code sono le vie d'accesso. Le regioni non sono indicate.
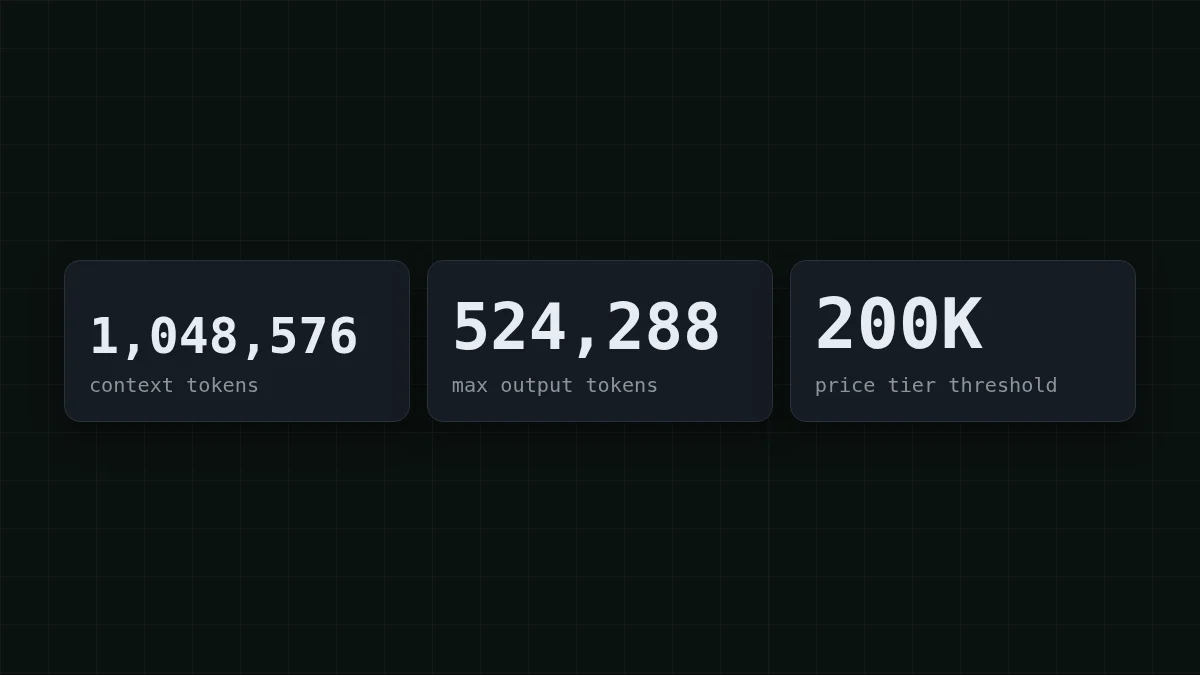
I limiti dalla pagina del modello di Meta (dev.meta.ai/docs/muse-ember, nessuna data sulla pagina). Finestra di contesto — 1.048.576 token, output massimo — 524.288 token, e la fascia di prezzo più alta parte oltre i 200K token di prompt.
Accetta testo, immagini, video, audio e PDF come input e restituisce testo. Puoi chiamarlo tramite gli endpoint Responses, Chat Completions o Messages, con tool calling, output strutturato, computer use, comprensione delle immagini e search grounding. Lo sforzo di ragionamento va da minimal a max, e il default è max. Lo streaming non è menzionato sulla pagina, quindi non lo dichiariamo.
Meta ha anche pubblicato numeri di benchmark, e sono quelli di Meta, per lo più con ragionamento max: Terminal-Bench 4.0 al 40,9% contro il 39,2% di Haiku 5.5, AutomationBench-AA al 37,8% contro 13,9% e 20,2% per gli altri due che Meta elenca, e FrontierCode 2.0-AA al 27,2%, dietro Haiku 5.5 al 34,9%. Sull'Artificial Analysis Intelligence Index segna 36 contro 37 di Muse Spark 1.3. Trattali come un'affermazione del fornitore finché non esegui i tuoi casi.
Quanto costa una sessione da 50 passaggi su Ember#
La tabella dei prezzi, secondo l'annuncio di Meta (la pagina del modello stessa rimanda a una pagina prezzi senza cifre):
Scorri la tabella verso destra →
| Dimensione del prompt | Input | Input in cache | Output |
|---|---|---|---|
| fino a 200K token | $0,10 | $0,004 | $0,50 |
| oltre 200K token | $0,30 | $0,012 | $1,50 |
I prezzi sono per 1M di token, verificati il 10 novembre 2026. Fonti secondarie descrivono diversamente la regola oltre i 200K, quindi confermala sulla pagina prezzi di Meta prima di fare budget.
Ora una sessione. Diciamo che il tuo agente fa 50 passaggi, e ogni passaggio invia circa 20K token (la cronologia che cresce più i risultati dei tool) e riceve indietro circa 500 token. In totale sono 1M di token in input e 25K in output. Su Ember: 1 × $0,10 + 0,025 × $0,50 = $0,1125 (conteggi dei token in milioni). Il lato input è quasi l'intera bolletta, ed è per questo che il prezzo dell'input in cache di $0,004 conta se il tuo agente mantiene lo stesso prefisso.
Indovina il numero
Supponiamo che la tariffa più alta si applichi all'intero prompt (è così che si legge la formulazione di Meta). Quanti centesimi costa l'input di un prompt da 250K token su Ember?
La tua risposta
020
Mostra risposta
Risposta: 7,5
Se la tariffa più alta si applica all'intero prompt: 250.000 × $0,30 per 1M = $0,075, quindi 7,5 centesimi solo per l'input. Cinquanta passaggi così sarebbero $3,75 di input.
Perché prompt lunghi? Perché gli agenti reinviano la cronologia a ogni passaggio; se è una novità per te, perché un agente rilegge tutta la sua cronologia lo spiega con un piccolo esempio.
In quale fascia cade il tuo prompt?#
La soglia dei 200K è quella da tenere d'occhio. Meta elenca tariffe tre volte più alte per i prompt più lunghi: $0,30 per l'input, $0,012 per l'input in cache e $1,50 per l'output.
Scegli il tuo caso
Dove si colloca la richiesta più grande del tuo agente?
Scegli un'opzione per vedere la risposta
Sotto i 200K token
Resti nella fascia più bassa. Fai budget con $0,10 in / $0,50 out e tieni d'occhio il lato output se mantieni lo sforzo di ragionamento al default.
Tra 200K e 1M di token
Si applica la fascia più alta, e la finestra da 1.048.576 token di Ember ti contiene ancora. Taglia l'output vecchio dei tool prima che superi i 200K, oppure suddividi il lavoro in modo che solo un passaggio porti il documento completo.
Oltre 1M di token
Non entra in una singola richiesta. Suddividi l'input in chunk e lascia che un planner unisca i risultati.
Lo stesso ruolo di sotto-compito economico su CheapTokens#
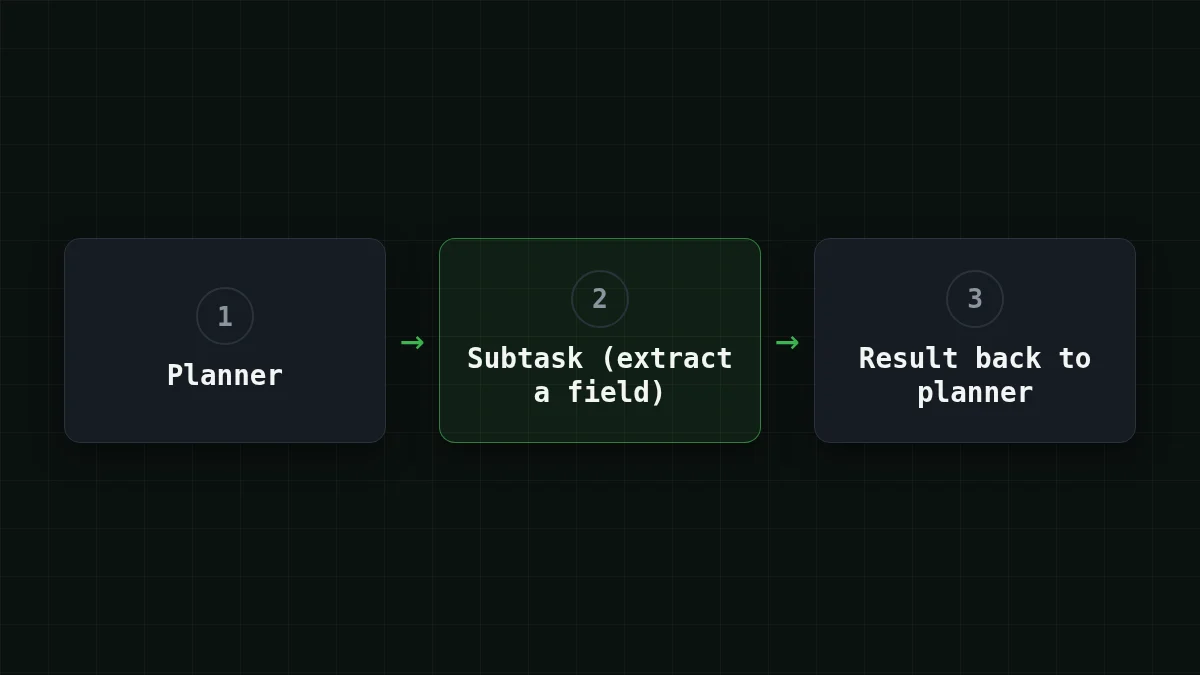
Una configurazione comune degli agenti tiene un modello più grande per la pianificazione e invia i sotto-compiti ripetuti a uno economico. Per quel secondo posto, CheapTokens ha DeepSeek-V4-Flash: contesto da 380K, fino a 32.768 token di output per risposta, un prezzo unico a qualsiasi ora del giorno senza fasce di punta, un'API compatibile con OpenAI e Anthropic e un unico saldo su tutti i modelli. GLM-5.3-Flash è l'altra opzione per i cicli di tool call e il parsing di documenti lunghi, con un contesto da 390K e fino a 8.192 token di output. Esegui 20 dei tuoi sotto-compiti su DeepSeek-V4-Flash e confronta i risultati tramite il campo usage.
Ecco la stessa sessione da 50 passaggi, 20K token in input e 500 in output per passaggio, con prezzi in tempo reale:
| Modello | Input $/1M | Output $/1M | Per richiesta | 50 richieste | OpenRouter, 50 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00042 | $0.021 | $0.0356 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00035 | $0.0175 | $0.0735 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0011 | $0.0538 | $0.645 |
20.000 token di input e 500 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
La riga di DeepSeek-V4-Flash per l'intera sessione è $0.0175; in totale, contando insieme input e output, risulta più economica del prezzo di riferimento di OpenRouter per lo stesso modello. I prezzi su questa pagina si aggiornano da soli.
Provarlo richiede una sola richiesta. La chiave va in una variabile d'ambiente, e l'id del modello è quello completo dalla documentazione (la documentazione ha la lista; i prezzi le tariffe attuali):
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Extract the order number from: Order #48213 shipped today."}],
    "max_tokens": 100
  }'
La risposta ha il solito oggetto usage, così puoi leggere i token reali di input e output del tuo sotto-compito e inserirli nella tabella qui sopra. Per il pattern di routing in sé, vedi model routing: prima il modello economico, poi escalation e, per saperne di più sul modello, DeepSeek su CheapTokens.
Tieni d'occhio il lato output#
Lo sforzo di ragionamento predefinito di Ember è max, e i numeri di benchmark di Meta sono stati per lo più ottenuti così. Un sotto-compito che deve solo estrarre un campo da un documento non ne ha bisogno, e uno sforzo di ragionamento più alto può significare più token di output, il lato più caro. Le pagine di Meta non dicono come vengono contati i token di ragionamento, quindi leggi usage invece di dare per scontato.
Provalo tu stessoProva: come scopri quanto spende davvero un sotto-compito?Mostra risposta
Invia 20 sotto-compiti reali con l'impostazione di sforzo più bassa, poi con quella predefinita, e leggi usage in ogni risposta. Moltiplica la media di input e output per i tuoi passaggi al giorno e calcola il costo ai prezzi di Ember dalla tabella qui sopra. Se le risposte coincidono sui tuoi casi, l'impostazione più economica è quella da tenere. Perché funziona è spiegato in sforzo di ragionamento e token di pensiero.
La lettura pratica per chi costruisce: Ember ha un prezzo pensato per il posto economico in un agente, la soglia dei 200K è il numero su cui progettare, e l'unica cifra che decide è quella del tuo campo usage.


