Notícias de IAAtualização
Preço da API do Meta Muse Ember: $0,10 / $0,50, contexto de 1M
Meta Muse Ember: faixas de preço, contexto de 1M, saída de 512K e quanto custa uma sessão de agente de 50 etapas, com uma alternativa barata para subtarefas.
Nesta página
O novo Muse Ember da Meta é um modelo pequeno criado para as etapas baratas e repetitivas dentro de um agente e, segundo o anúncio da Meta, custa $0,10 para entrada e $0,50 para saída por 1M de tokens em prompts de até 200K tokens. Acima de 200K o preço triplica. Uma sessão de agente de 50 etapas com 20K tokens de entrada e 500 de saída por etapa fica em cerca de $0,11 no Ember, e o mesmo papel está disponível para você na CheapTokens com o DeepSeek-V4-Flash.
O modelo foi anunciado em 9 de novembro de 2026 no blog de pesquisa da Meta (research.meta.ai/blog/muse-ember); o post mostra uma data, mas não um horário. Conferimos o blog e a página do modelo em dev.meta.ai em 10 de novembro de 2026.
O que a Meta anunciou#
O Muse Ember (id do modelo muse-ember-1.0) é o modelo menor e mais eficiente da linha Muse da Meta, voltado para subtarefas de agentes: chamadas de ferramentas, extração, roteamento, análise de documentos longos. Você pode acessá-lo no Muse Code, na Meta Model API (somente no modo Standard), no Google Cloud e no Oracle Cloud. A Meta não anuncia pesos abertos, então a API e o Muse Code são o caminho de entrada. As regiões não são informadas.
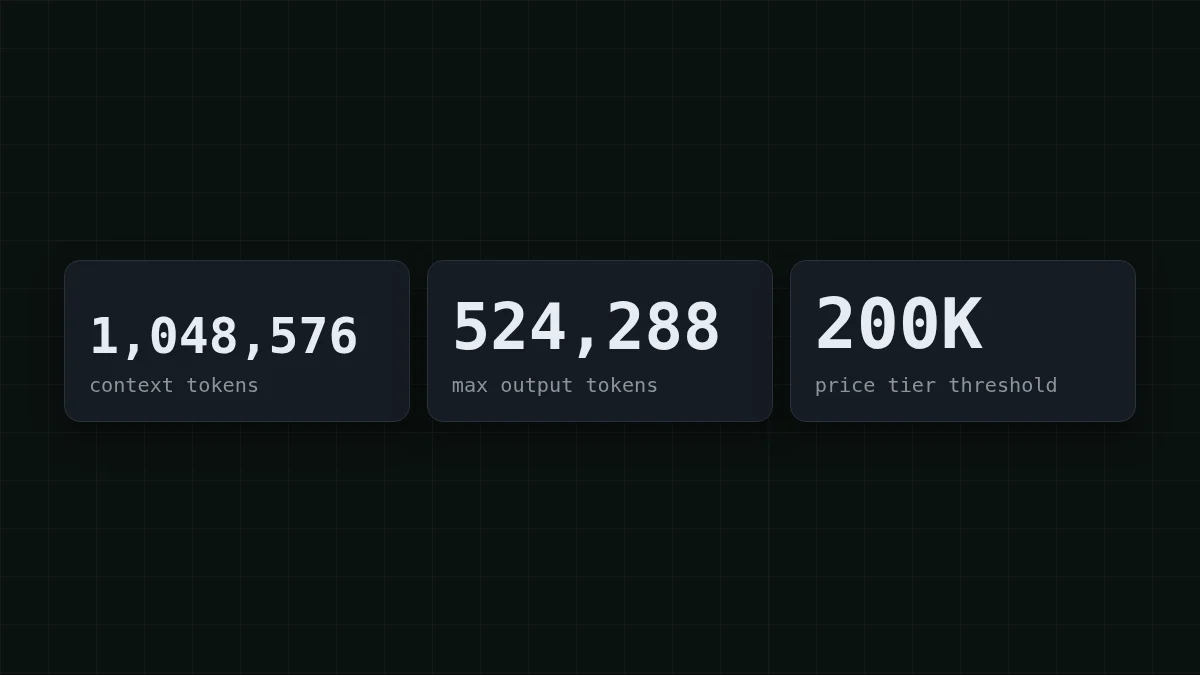
Os limites da página do modelo da Meta (dev.meta.ai/docs/muse-ember, sem data na página). Janela de contexto — 1.048.576 tokens, saída máxima — 524.288 tokens, e a faixa de preço mais alta começa acima de 200K tokens de prompt.
Ele aceita texto, imagem, vídeo, áudio e PDF como entrada e retorna texto. Você pode chamá-lo pelos endpoints Responses, Chat Completions ou Messages, com chamada de ferramentas, saída estruturada, uso de computador, compreensão de imagens e grounding de busca. O esforço de raciocínio vai de mínimo a máximo, e o padrão é máximo. Streaming não é mencionado na página, então não vamos afirmar isso.
A Meta também publicou números de benchmark, e são da Meta, em sua maioria com raciocínio no máximo: Terminal-Bench 4.0 em 40,9% contra 39,2% do Haiku 5.5, AutomationBench-AA em 37,8% contra 13,9% e 20,2% dos outros dois que a Meta lista, e FrontierCode 2.0-AA em 27,2%, atrás do Haiku 5.5 com 34,9%. No Artificial Analysis Intelligence Index ele marca 36 contra 37 do Muse Spark 1.3. Trate-os como alegação do fornecedor até rodar seus próprios casos.
Quanto custa uma sessão de 50 etapas no Ember#
A tabela de preços, segundo o anúncio da Meta (a própria página do modelo aponta para uma página de preços sem valores):
Role a tabela para a direita →
| Tamanho do prompt | Entrada | Entrada em cache | Saída |
|---|---|---|---|
| até 200K tokens | $0,10 | $0,004 | $0,50 |
| acima de 200K tokens | $0,30 | $0,012 | $1,50 |
Os preços são por 1M de tokens, conferidos em 10 de novembro de 2026. Fontes secundárias descrevem a regra acima de 200K de forma diferente, então confirme na página de preços da Meta antes de planejar seu orçamento com base nela.
Agora uma sessão. Digamos que seu agente faça 50 etapas, e cada etapa envie cerca de 20K tokens (o histórico crescente mais os resultados das ferramentas) e receba cerca de 500 tokens de volta. Isso dá 1M de tokens de entrada e 25K de saída no total. No Ember: 1 × $0,10 + 0,025 × $0,50 = $0,1125 (contagens de tokens em milhões). O lado da entrada é quase toda a conta, e é por isso que o preço de entrada em cache de $0,004 importa se seu agente mantém o mesmo prefixo.
Adivinhar o número
Digamos que a tarifa mais alta se aplique ao prompt inteiro (é como o texto da Meta soa). Quantos centavos custa a entrada de um prompt de 250K tokens no Ember?
O seu palpite
020
Mostrar resposta
Resposta: 7,5
Se a tarifa mais alta se aplica ao prompt inteiro: 250.000 × $0,30 por 1M = $0,075, ou seja, 7,5 centavos só pela entrada. Cinquenta etapas assim seriam $3,75 de entrada.
Por que prompts longos, afinal? Porque os agentes reenviam o histórico a cada etapa; se isso é novidade para você, por que um agente relê todo o seu histórico explica com um exemplo pequeno.
Em qual faixa está o seu prompt?#
A linha dos 200K é a que você precisa acompanhar. A Meta lista tarifas três vezes maiores para prompts mais longos: $0,30 para entrada, $0,012 para entrada em cache e $1,50 para saída.
Escolha o seu caso
Onde fica a maior requisição do seu agente?
Escolha uma opção para ver a resposta
Abaixo de 200K tokens
Você fica na faixa mais baixa. Planeje com $0,10 de entrada / $0,50 de saída e fique de olho no lado da saída se mantiver o esforço de raciocínio no padrão.
Entre 200K e 1M tokens
A faixa mais alta se aplica, e a janela de 1.048.576 tokens do Ember ainda cabe você. Corte a saída antiga de ferramentas antes de cruzar 200K, ou divida o trabalho para que só uma etapa carregue o documento inteiro.
Acima de 1M tokens
Não cabe em uma requisição. Divida a entrada em blocos e deixe um planejador mesclar os resultados.
O mesmo papel de subtarefa barata na CheapTokens#
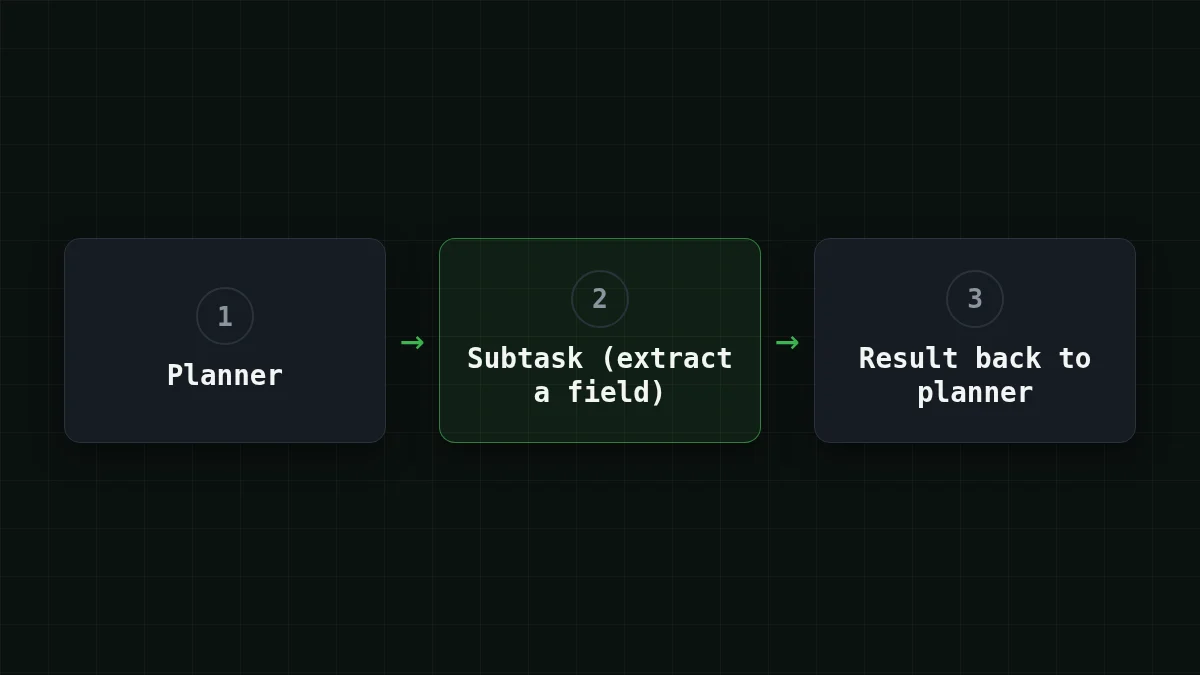
Um arranjo comum de agente mantém um modelo maior para planejamento e envia as subtarefas repetitivas para um barato. Para esse segundo assento, a CheapTokens tem o DeepSeek-V4-Flash: contexto de 380K, até 32.768 tokens de saída por resposta, um preço a qualquer hora do dia sem horário de pico, uma API compatível com OpenAI e Anthropic, e um saldo único para todos os modelos. O GLM-5.3-Flash é a outra opção para loops de chamada de ferramentas e análise de documentos longos, com contexto de 390K e até 8.192 tokens de saída. Rode 20 das suas próprias subtarefas no DeepSeek-V4-Flash e compare os resultados pelo campo usage.
Aqui está a mesma sessão de 50 etapas, 20K tokens de entrada e 500 de saída por etapa, com preço ao vivo:
| Modelo | Entrada $/1M | Saída $/1M | Por solicitação | 50 solicitações | OpenRouter, 50 solicitações |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00042 | $0.021 | $0.0356 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00035 | $0.0175 | $0.0735 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0011 | $0.0538 | $0.645 |
20.000 tokens de entrada e 500 tokens de saída por solicitação. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
A linha do DeepSeek-V4-Flash para a sessão inteira é $0.0175; no total, com entrada e saída somadas, sai mais barato que o preço de referência do OpenRouter para o mesmo modelo. Os preços nesta página se atualizam sozinhos.
Experimentar leva uma requisição. A chave vai em uma variável de ambiente, e o id do modelo é o completo da documentação (a documentação tem a lista; preços as tarifas atuais):
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Extract the order number from: Order #48213 shipped today."}],
    "max_tokens": 100
  }'
A resposta tem o objeto usage de sempre, então você pode ler os tokens reais de entrada e saída da sua subtarefa e encaixá-los na tabela acima. Para o padrão de roteamento em si, veja roteamento de modelos: modelo barato primeiro, escalar depois e, para saber mais sobre o modelo, DeepSeek na CheapTokens.
Fique de olho no lado da saída#
O esforço de raciocínio padrão do Ember é máximo, e os próprios números de benchmark da Meta foram em sua maioria rodados assim. Uma subtarefa que só precisa extrair um campo de um documento não precisa disso, e um esforço de raciocínio maior pode significar mais tokens de saída, o lado mais caro. As páginas da Meta não dizem como os tokens de raciocínio são contados, então leia usage em vez de supor.
Experimente você mesmoTeste: como você descobre quanto uma subtarefa realmente gasta?Mostrar resposta
Envie 20 subtarefas reais no esforço mais baixo, depois no padrão, e leia usage em cada resposta. Multiplique a média de entrada e saída pelas suas etapas por dia e calcule o custo com os preços do Ember da tabela acima. Se as respostas baterem nos seus casos, a configuração mais barata é a que deve ficar. Por que isso funciona está em esforço de raciocínio e tokens de pensamento.
A leitura prática para quem constrói: o Ember tem preço para o assento barato de um agente, a linha dos 200K é o número em torno do qual projetar, e o único número que decide é o do seu próprio campo usage.


