Nowości AIAktualizacja
Cena API Meta Muse Ember: $0.10 / $0.50, kontekst 1M
Meta Muse Ember: przedziały cenowe, kontekst 1M, wyjście 512K i ile kosztuje sesja agenta 50 kroków, z tańszą alternatywą do podzadań.
Na tej stronie
Nowy Muse Ember od Meta to mały model stworzony do tanich, powtarzalnych kroków wewnątrz agenta, a według ogłoszenia Meta kosztuje $0.10 za wejście i $0.50 za wyjście za 1M tokenów przy promptach do 200K tokenów. Powyżej 200K cena rośnie trzykrotnie. Sesja agenta złożona z 50 kroków po 20K tokenów wejścia i 500 wyjścia na krok kosztuje na Ember około $0.11, a ta sama rola jest dostępna dla Ciebie w CheapTokens z DeepSeek-V4-Flash.
Model został ogłoszony 9 listopada 2026 na blogu badawczym Meta (research.meta.ai/blog/muse-ember); wpis pokazuje datę, ale nie godzinę. Sprawdziliśmy blog i stronę modelu na dev.meta.ai 10 listopada 2026.
Co ogłosiła Meta#
Muse Ember (id modelu muse-ember-1.0) to najmniejszy i najbardziej wydajny model w linii Muse od Meta, skierowany do podzadań agenta: wywołań narzędzi, ekstrakcji, routingu, parsowania długich dokumentów. Można się do niego dostać w Muse Code, Meta Model API (tylko tryb Standard), Google Cloud i Oracle Cloud. Meta nie ogłasza otwartych wag, więc API i Muse Code to jedyna droga. Regiony nie są podane.
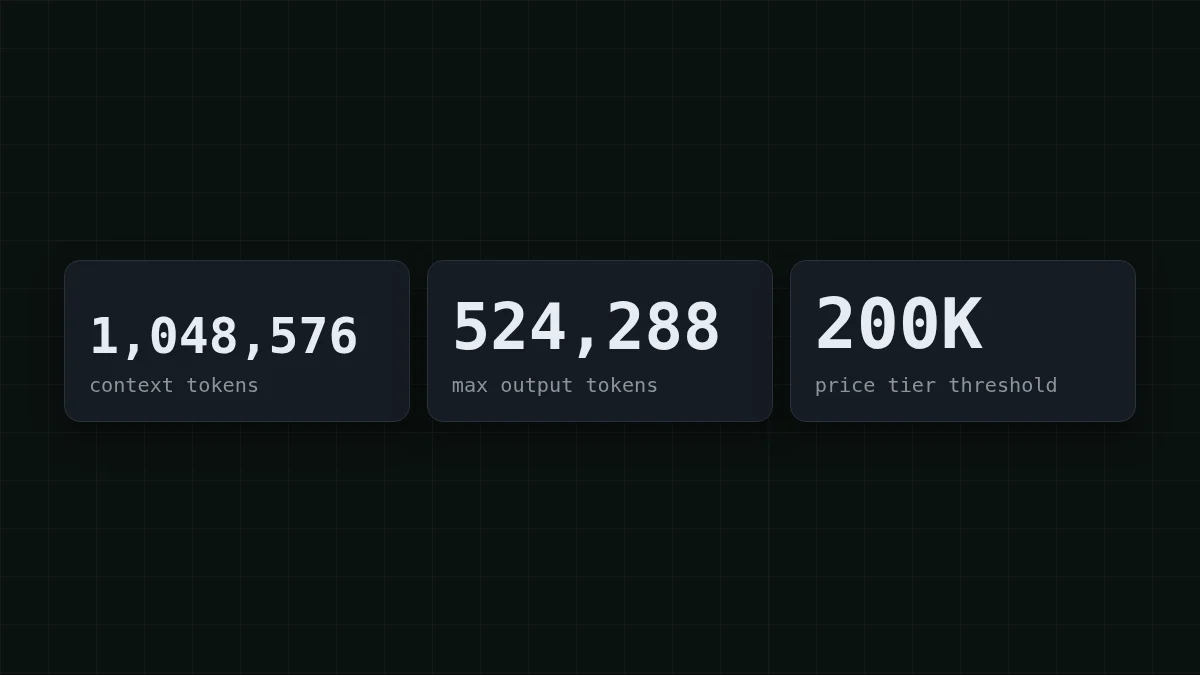
Limity ze strony modelu Meta (dev.meta.ai/docs/muse-ember, brak daty na stronie). Okno kontekstu — 1,048,576 tokenów, maksymalne wyjście — 524,288 tokenów, a wyższy przedział cenowy zaczyna się powyżej 200K tokenów promptu.
Przyjmuje tekst, obraz, wideo, audio i PDF jako wejście i zwraca tekst. Można go wywoływać przez endpointy Responses, Chat Completions lub Messages, z wywoływaniem narzędzi, ustrukturyzowanym wyjściem, computer use, rozumieniem obrazów i ugruntowaniem w wyszukiwaniu. Wysiłek rozumowania mieści się w zakresie od minimal do max, a domyślnie jest to max. Streaming nie jest wspomniany na stronie, więc nie będziemy tego twierdzić.
Meta opublikowała też wyniki benchmarków, i są to wyniki Meta, w większości przy maksymalnym rozumowaniu: Terminal-Bench 4.0 na poziomie 40.9% wobec 39.2% dla Haiku 5.5, AutomationBench-AA na poziomie 37.8% wobec 13.9% i 20.2% dla dwóch pozostałych wymienionych przez Meta, oraz FrontierCode 2.0-AA na poziomie 27.2%, za Haiku 5.5 z 34.9%. W Artificial Analysis Intelligence Index uzyskuje 36 wobec 37 dla Muse Spark 1.3. Traktuj je jako twierdzenie dostawcy, dopóki nie uruchomisz własnych przypadków.
Ile kosztuje sesja 50 kroków na Ember#
Tabela cen według ogłoszenia Meta (sama strona modelu wskazuje stronę z cenami bez liczb):
Przewiń tabelę w prawo →
| Rozmiar promptu | Wejście | Wejście z cache | Wyjście |
|---|---|---|---|
| do 200K tokenów | $0.10 | $0.004 | $0.50 |
| powyżej 200K tokenów | $0.30 | $0.012 | $1.50 |
Ceny są za 1M tokenów, sprawdzone 10 listopada 2026. Źródła wtórne opisują regułę powyżej 200K odmiennie, więc potwierdź ją na stronie cen Meta, zanim zbudujesz na niej budżet.
Teraz sesja. Załóżmy, że Twój agent wykonuje 50 kroków, a każdy krok wysyła około 20K tokenów (rosnąca historia plus wyniki narzędzi) i otrzymuje około 500 tokenów z powrotem. To daje 1M tokenów wejścia i 25K wyjścia łącznie. Na Ember: 1 × $0.10 + 0.025 × $0.50 = $0.1125 (liczby tokenów w milionach). Strona wejścia to niemal cały rachunek, dlatego cena wejścia z cache wynosząca $0.004 ma znaczenie, jeśli Twój agent zachowuje ten sam prefiks.
Zgadnij liczbę
Załóżmy, że wyższa stawka dotyczy całego promptu (tak brzmi sformułowanie Meta). Ile centów kosztuje wejście promptu o 250K tokenów na Ember?
Twoje przypuszczenie
020
Pokaż odpowiedź
Odpowiedź: 7,5
Jeśli wyższa stawka dotyczy całego promptu: 250,000 × $0.30 za 1M = $0.075, czyli 7.5 centa za samo wejście. Pięćdziesiąt takich kroków to $3.75 wejścia.
Po co w ogóle długie prompty? Bo agenci wysyłają historię ponownie przy każdym kroku; jeśli to dla Ciebie nowość, dlaczego agent odczytuje całą swoją historię wyjaśnia to na małym przykładzie.
W którym przedziale jest Twój prompt?#
Granica 200K to ta, na którą trzeba uważać. Meta podaje stawki trzykrotnie wyższe dla dłuższych promptów: $0.30 za wejście, $0.012 za wejście z cache i $1.50 za wyjście.
Wybierz swój przypadek
Gdzie znajduje się największe żądanie Twojego agenta?
Wybierz opcję, aby zobaczyć odpowiedź
Poniżej 200K tokenów
Zostajesz w niższym przedziale. Planuj budżet przy $0.10 wejście / $0.50 wyjście i pilnuj strony wyjścia, jeśli utrzymujesz domyślny wysiłek rozumowania.
Między 200K a 1M tokenów
Obowiązuje wyższy przedział, a okno 1,048,576 tokenów Ember wciąż Ci wystarcza. Przytnij stare wyniki narzędzi, zanim przekroczą 200K, albo podziel zadanie tak, aby tylko jeden krok niósł pełny dokument.
Powyżej 1M tokenów
Nie mieści się w jednym żądaniu. Podziel wejście na fragmenty i pozwól planerowi scalić wyniki.
Ta sama rola taniego podzadania w CheapTokens#
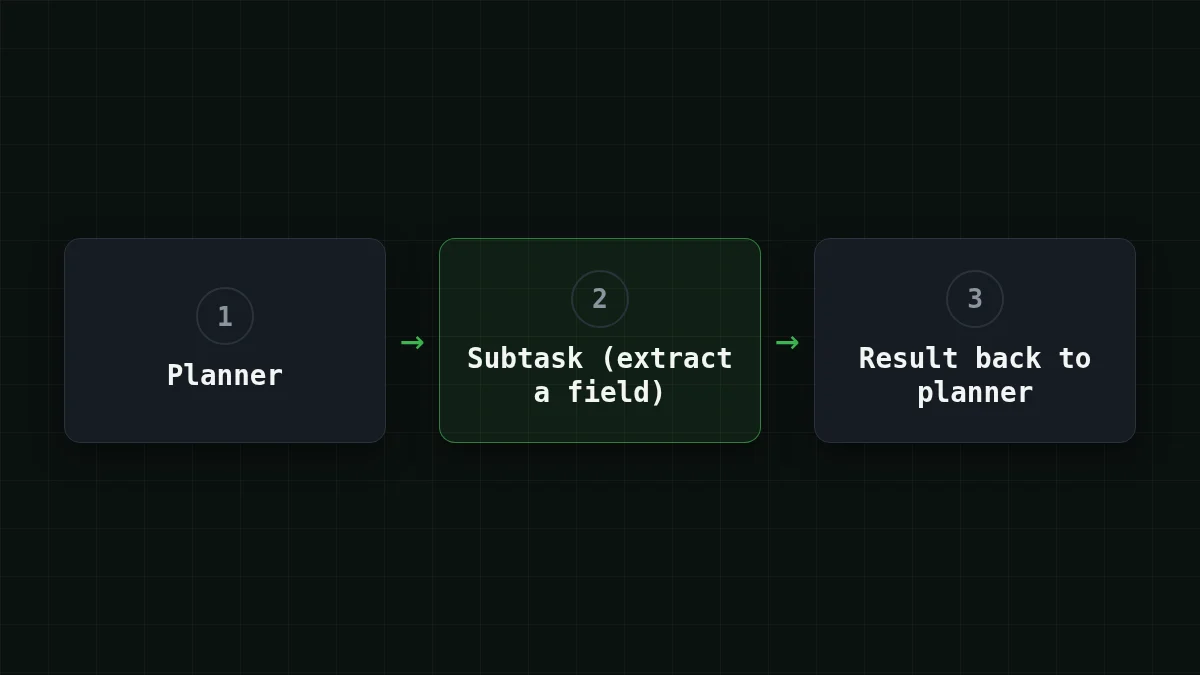
Typowy układ agenta trzyma większy model do planowania i wysyła powtarzalne podzadania do taniego. Na to drugie miejsce CheapTokens ma DeepSeek-V4-Flash: kontekst 380K, do 32,768 tokenów wyjścia na odpowiedź, jedna cena o każdej porze dnia bez godzin szczytu, API zgodne z OpenAI i Anthropic oraz jedno saldo dla wszystkich modeli. GLM-5.3-Flash to druga opcja do pętli wywołań narzędzi i parsowania długich dokumentów, z kontekstem 390K i do 8,192 tokenów wyjścia. Uruchom 20 własnych podzadań na DeepSeek-V4-Flash i porównaj wyniki po polu usage.
Oto ta sama sesja 50 kroków, 20K tokenów wejścia i 500 wyjścia na krok, wyceniona na żywo:
| Model | Wejście $/1M | Wyjście $/1M | Za żądanie | 50 żądań | OpenRouter, 50 żądań |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00042 | $0.021 | $0.0356 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00035 | $0.0175 | $0.0735 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0011 | $0.0538 | $0.645 |
20 000 tokenów wejściowych i 500 tokenów wyjściowych na żądanie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
Wiersz DeepSeek-V4-Flash dla całej sesji to $0.0175; łącznie, licząc wejście i wyjście razem, wychodzi taniej niż cena referencyjna OpenRouter dla tego samego modelu. Ceny na tej stronie aktualizują się same.
Wypróbowanie zajmuje jedno żądanie. Klucz trafia do zmiennej środowiskowej, a id modelu to pełne id z dokumentacji (dokumentacja zawiera listę; cennik aktualne stawki):
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Extract the order number from: Order #48213 shipped today."}],
    "max_tokens": 100
  }'
Odpowiedź zawiera zwykły obiekt usage, więc możesz odczytać rzeczywiste tokeny wejścia i wyjścia swojego podzadania i wstawić je do tabeli powyżej. Sam wzorzec routingu opisuje routing modeli: najpierw tani model, potem eskalacja, a więcej o modelu — DeepSeek w CheapTokens.
Pilnuj strony wyjścia#
Domyślny wysiłek rozumowania Ember to max, a własne wyniki benchmarków Meta były w większości uzyskane w ten sposób. Podzadanie, które ma tylko wyciągnąć pole z dokumentu, tego nie potrzebuje, a wyższy wysiłek rozumowania może oznaczać więcej tokenów wyjścia, czyli droższą stronę. Strony Meta nie mówią, jak liczone są tokeny rozumowania, więc czytaj usage, zamiast zakładać.
Spróbuj samSpróbuj: jak dowiedzieć się, ile naprawdę zużywa jedno podzadanie?Pokaż odpowiedź
Wyślij 20 rzeczywistych podzadań przy najniższym ustawieniu wysiłku, potem przy domyślnym, i odczytaj usage w każdej odpowiedzi. Pomnóż średnie wejście i wyjście przez liczbę kroków dziennie i oblicz koszt według cen Ember z tabeli powyżej. Jeśli odpowiedzi zgadzają się na Twoich przypadkach, tańsze ustawienie jest tym, które warto zachować. Dlaczego to działa, opisuje wysiłek rozumowania i tokeny myślenia.
Praktyczny wniosek dla budujących: Ember jest wyceniony na tanie miejsce w agencie, granica 200K to liczba, wokół której trzeba projektować, a jedyną liczbą, która to rozstrzyga, jest ta z Twojego własnego pola usage.


