KI-NewsUpdate
Meta Muse Ember API-Preis: $0.10 / $0.50, 1M Kontext
Metas Muse Ember: Preisstufen, 1M Kontext, 512K Output und was eine 50-Schritte-Agentensitzung kostet, mit einer günstigen Teilaufgaben-Alternative.
Auf dieser Seite
Metas neues Muse Ember ist ein kleines Modell, das für die günstigen, wiederholten Schritte innerhalb eines Agenten gebaut wurde, und laut Metas Ankündigung kostet es $0.10 für Input und $0.50 für Output pro 1M Tokens bei Prompts bis zu 200K Tokens. Oberhalb von 200K verdreifacht sich der Preis. Eine 50-Schritte-Agentensitzung mit 20K Tokens Input und 500 Output pro Schritt kommt auf Ember auf etwa $0.11, und dieselbe Rolle steht dir bei CheapTokens mit DeepSeek-V4-Flash offen.
Das Modell wurde am 9. November 2026 im Forschungsblog von Meta angekündigt (research.meta.ai/blog/muse-ember); der Beitrag zeigt ein Datum, aber keine Uhrzeit. Wir haben den Blog und die Modellseite unter dev.meta.ai am 10. November 2026 geprüft.
Was Meta angekündigt hat#
Muse Ember (Modell-ID muse-ember-1.0) ist das kleinste und effizienteste Modell in Metas Muse-Reihe, ausgerichtet auf Agenten-Teilaufgaben: Tool-Aufrufe, Extraktion, Routing, das Parsen langer Dokumente. Du erreichst es in Muse Code, der Meta Model API (nur Standard-Modus), Google Cloud und Oracle Cloud. Meta kündigt keine offenen Gewichte an, also sind API und Muse Code der Weg hinein. Regionen werden nicht genannt.
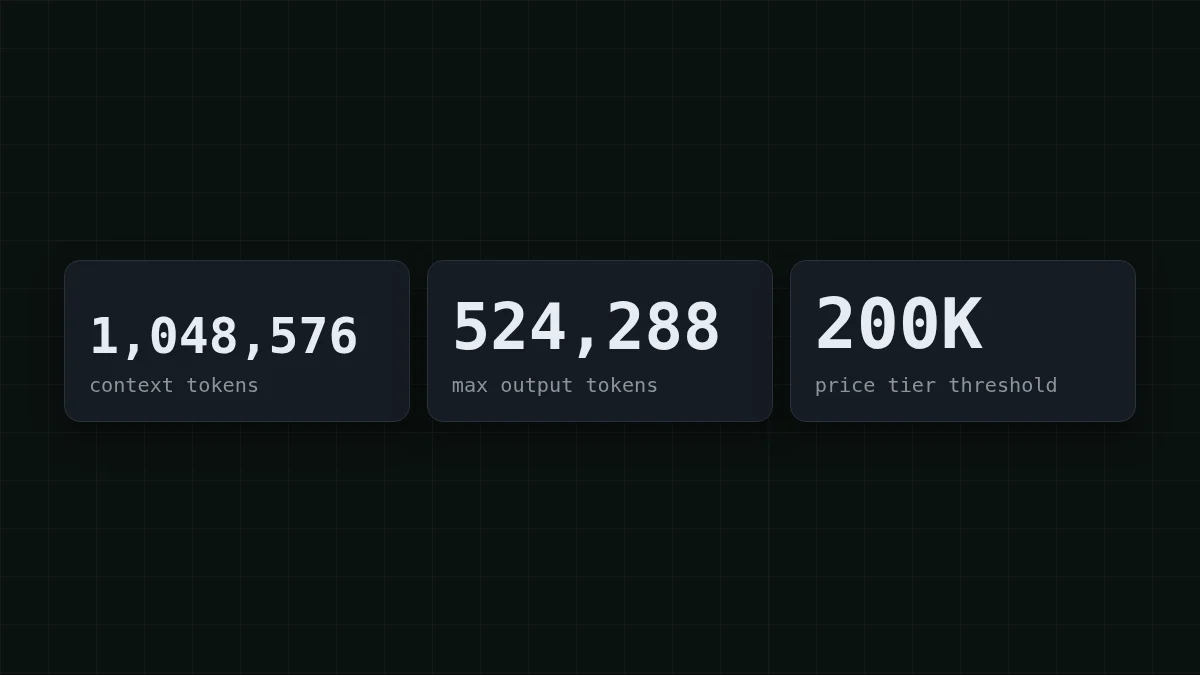
Die Limits von Metas Modellseite (dev.meta.ai/docs/muse-ember, kein Datum auf der Seite). Kontextfenster — 1,048,576 Tokens, maximaler Output — 524,288 Tokens, und die höhere Preisstufe beginnt oberhalb von 200K Tokens Prompt.
Es nimmt Text, Bild, Video, Audio und PDF als Input und gibt Text zurück. Du kannst es über die Endpunkte Responses, Chat Completions oder Messages aufrufen, mit Tool Calling, strukturiertem Output, Computer Use, Bildverständnis und Search Grounding. Der Reasoning-Aufwand reicht von minimal bis max, und der Standard ist max. Streaming wird auf der Seite nicht erwähnt, also behaupten wir es nicht.
Meta hat außerdem Benchmark-Zahlen veröffentlicht, und sie stammen von Meta, größtenteils bei max Reasoning: Terminal-Bench 4.0 bei 40,9 % gegenüber 39,2 % für Haiku 5.5, AutomationBench-AA bei 37,8 % gegenüber 13,9 % und 20,2 % für die beiden anderen, die Meta auflistet, und FrontierCode 2.0-AA bei 27,2 %, hinter Haiku 5.5 mit 34,9 %. Im Artificial Analysis Intelligence Index erreicht es 36 gegenüber 37 für Muse Spark 1.3. Behandle sie als Anbieterangabe, bis du deine eigenen Fälle laufen lässt.
Was eine 50-Schritte-Sitzung auf Ember kostet#
Die Preistabelle, laut Metas Ankündigung (die Modellseite selbst verweist auf eine Preisseite ohne Zahlen):
Tabelle nach rechts scrollen →
| Prompt-Größe | Input | Gecachter Input | Output |
|---|---|---|---|
| bis zu 200K Tokens | $0.10 | $0.004 | $0.50 |
| über 200K Tokens | $0.30 | $0.012 | $1.50 |
Preise pro 1M Tokens, geprüft am 10. November 2026. Sekundärquellen beschreiben die Über-200K-Regel unterschiedlich, also bestätige sie auf Metas Preisseite, bevor du darauf kalkulierst.
Nun eine Sitzung. Angenommen, dein Agent macht 50 Schritte, und jeder Schritt sendet etwa 20K Tokens (die wachsende Historie plus Tool-Ergebnisse) und bekommt etwa 500 Tokens zurück. Das sind insgesamt 1M Tokens Input und 25K Output. Auf Ember: 1 × $0.10 + 0.025 × $0.50 = $0.1125 (Token-Zahlen in Millionen). Die Input-Seite macht fast die ganze Rechnung aus, weshalb der Preis für gecachten Input von $0.004 zählt, wenn dein Agent denselben Prefix behält.
Zahl erraten
Angenommen, der höhere Satz gilt für den gesamten Prompt (so liest sich Metas Formulierung). Wie viele Cent kostet der Input eines 250K-Token-Prompts auf Ember?
Deine Schätzung
020
Antwort anzeigen
Antwort: 7,5
Wenn der höhere Satz für den gesamten Prompt gilt: 250,000 × $0.30 pro 1M = $0.075, also 7,5 Cent allein für den Input. Fünfzig solcher Schritte wären $3.75 Input.
Warum überhaupt lange Prompts? Weil Agenten bei jedem Schritt die Historie erneut senden; falls das neu für dich ist, erklärt warum ein Agent seine ganze Historie erneut liest es an einem kleinen Beispiel.
In welcher Stufe liegt dein Prompt?#
Die 200K-Grenze ist die, auf die du achten musst. Meta listet dreimal höhere Sätze für längere Prompts: $0.30 für Input, $0.012 für gecachten Input und $1.50 für Output.
Wähle deinen Fall
Wo liegt die größte Anfrage deines Agenten?
Wähle eine Option, um die Antwort zu sehen
Unter 200K Tokens
Du bleibst in der niedrigeren Stufe. Kalkuliere mit $0.10 Input / $0.50 Output und achte auf die Output-Seite, wenn du den Reasoning-Aufwand beim Standard belässt.
Zwischen 200K und 1M Tokens
Die höhere Stufe gilt, und Embers Fenster von 1,048,576 Tokens passt noch. Kürze alten Tool-Output, bevor er 200K überschreitet, oder teile die Aufgabe so auf, dass nur ein Schritt das vollständige Dokument trägt.
Über 1M Tokens
Es passt nicht in eine Anfrage. Teile den Input in Chunks und lass einen Planner die Ergebnisse zusammenführen.
Dieselbe günstige Teilaufgaben-Rolle bei CheapTokens#
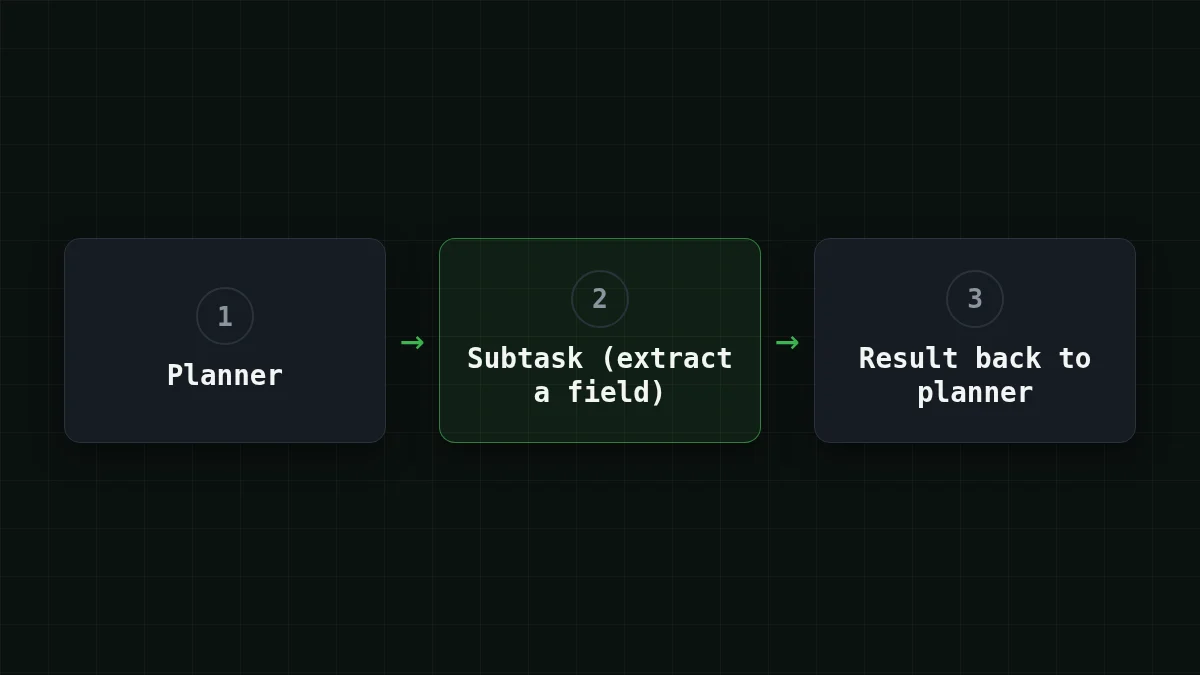
Ein üblicher Agenten-Aufbau behält ein größeres Modell für die Planung und schickt die wiederholten Teilaufgaben an ein günstiges. Für diesen zweiten Platz hat CheapTokens DeepSeek-V4-Flash: 380K Kontext, bis zu 32,768 Output-Tokens pro Antwort, ein Preis zu jeder Tageszeit ohne Stoßzeiten, eine OpenAI- und Anthropic-kompatible API und ein Guthaben über alle Modelle hinweg. GLM-5.3-Flash ist die andere Option für Tool-Call-Schleifen und das Parsen langer Dokumente, mit 390K Kontext und bis zu 8,192 Output-Tokens. Lass 20 deiner eigenen Teilaufgaben auf DeepSeek-V4-Flash laufen und vergleiche die Ergebnisse über das Feld usage.
Hier ist dieselbe 50-Schritte-Sitzung, 20K Tokens Input und 500 Output pro Schritt, live bepreist:
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 50 Anfragen | OpenRouter, 50 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00042 | $0.021 | $0.0356 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00035 | $0.0175 | $0.0735 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0011 | $0.0538 | $0.645 |
20.000 Input- und 500 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Die DeepSeek-V4-Flash-Zeile für die gesamte Sitzung ist $0.0175; insgesamt, Input und Output zusammengerechnet, kommt es günstiger heraus als OpenRouters Referenzpreis für dasselbe Modell. Die Preise auf dieser Seite aktualisieren sich von selbst.
Ausprobieren erfordert eine Anfrage. Der Key kommt in eine Umgebungsvariable, und die Modell-ID ist die vollständige aus der Doku (die Doku enthält die Liste; Preise die aktuellen Sätze):
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Extract the order number from: Order #48213 shipped today."}],
    "max_tokens": 100
  }'
Die Antwort hat das übliche usage-Objekt, sodass du die tatsächlichen Input- und Output-Tokens deiner Teilaufgabe ablesen und in die Tabelle oben einsetzen kannst. Zum Routing-Muster selbst siehe Modell-Routing: günstiges Modell zuerst, eskalieren und, für mehr zum Modell, DeepSeek auf CheapTokens.
Achte auf die Output-Seite#
Embers Standard-Reasoning-Aufwand ist max, und Metas eigene Benchmark-Zahlen wurden größtenteils so ermittelt. Eine Teilaufgabe, die nur ein Feld aus einem Dokument ziehen muss, braucht das nicht, und höherer Reasoning-Aufwand kann mehr Output-Tokens bedeuten, die teurere Seite. Metas Seiten sagen nicht, wie Reasoning-Tokens gezählt werden, also lies usage, statt es anzunehmen.
Probier es selbstProbier es aus: Wie findest du heraus, was eine Teilaufgabe wirklich kostet?Antwort anzeigen
Sende 20 echte Teilaufgaben mit der niedrigsten Aufwandsstufe, dann mit dem Standard, und lies usage in jeder Antwort. Multipliziere den durchschnittlichen Input und Output mit deinen Schritten pro Tag und berechne die Kosten zu Embers Preisen aus der Tabelle oben. Wenn die Antworten bei deinen Fällen übereinstimmen, ist die günstigere Einstellung die, die du behalten solltest. Warum das funktioniert, steht in Reasoning-Aufwand und Thinking-Tokens.
Die praktische Lesart für Entwickler: Ember ist für den günstigen Platz in einem Agenten bepreist, die 200K-Grenze ist die Zahl, um die herum du designst, und die einzige Zahl, die es entscheidet, ist die aus deinem eigenen Feld usage.


