KostenoptimierungAnalyse
Ein langes Agentenprojekt budgetieren: Compute vs. Tokens (Fall RSA-260)
Die 400.000-$-Schlagzeile zu RSA-260 ist GPU-Miete, keine Modell-Tokens. Teile ein langes Agentenprojekt in drei Budgetzeilen auf und bemesse den Token-Teil mit Sitzungen × Schritten × Tokens.
Auf dieser Seite
Die ~400.000-$-Zahl aus der RSA-260-Faktorisierung von Cognition ist GPU-Miete, keine Modellrechnung. Der Bericht bepreist die Agentenseite überhaupt nicht. Wenn du also ein langes Agentenprojekt planst, schätzt du die Token-Zeile selbst: Sitzungen × Schritte × Tokens pro Schritt, zu Live-Preisen. Genau das macht der Rest dieser Seite.
Die Quelle ist der Bericht von Eric Lu, einem Engineer bei Cognition (Factoring RSA-260, veröffentlicht am 9. September 2026, geprüft am 6. November 2026). Er wird mit der Dollarbetrag in der Überschrift erneut geteilt, und die Zahl ist leicht falsch zu lesen.
Wofür die 400.000 $ tatsächlich bezahlt werden#
Der Autor faktorisierte eine 260-stellige Zahl mit GNFS, unter Verwendung eines stark modifizierten CADO-NFS, das auf GPUs läuft. Der Bericht gibt die GPU-Zeit für jede Phase an:
- Polynomauswahl: 643 GPU-Tage
- Sieben: 3.813 GPU-Tage
- Lösen des linearen Gleichungssystems: 467 GPU-Tage
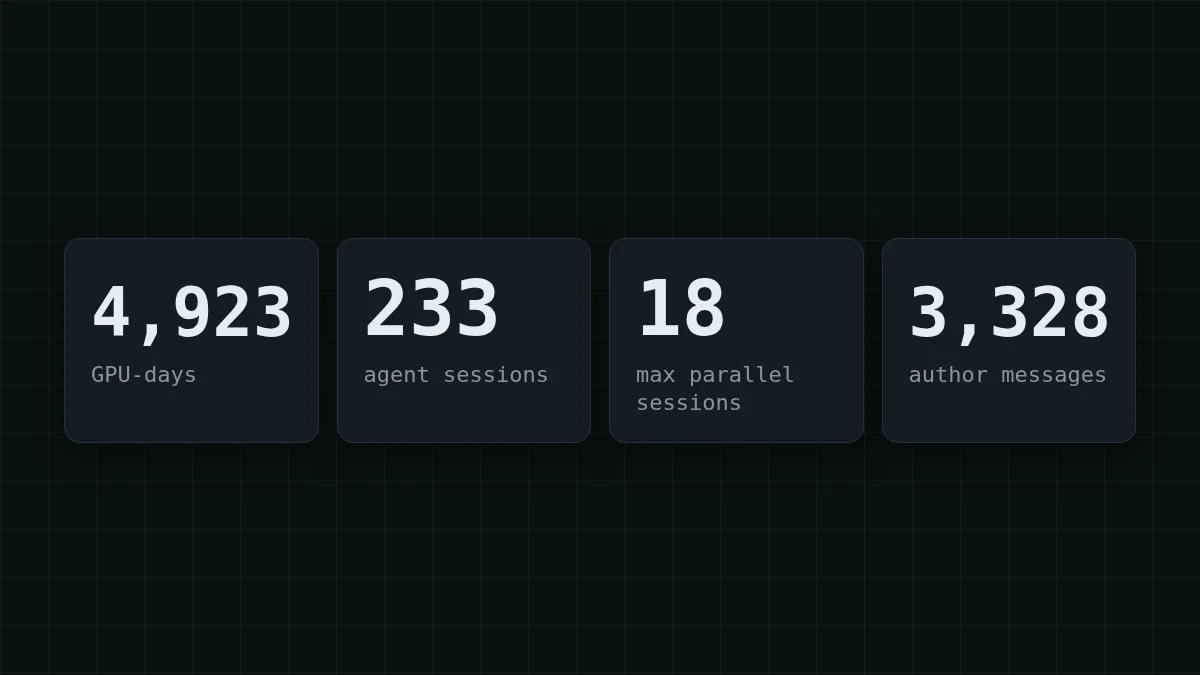
Das sind 643 + 3.813 + 467 = 4.923 GPU-Tage, die der Bericht auf ~4.900 rundet. Bei den im Bericht angenommenen 3,50 $ pro GPU-Stunde:
4.923 × 24 × 3,50 = 413.532
Das entspricht der GPU-Zahl von 414.000 $ im Anhang. Die Überschrift ist also gemietete Hardware, die wochenlang einen Rechenjob ausführt. In dieser Summe stecken keine Modell-Tokens.
Kurzer Check
Was ist die ~400.000-$-Zahl im RSA-260-Bericht?
Antwort anzeigen
Antwort: Marktübliche Miete von GPUs für den Faktorisierungslauf
Sie ergibt sich aus GPU-Tagen × 3,50 $ pro GPU-Stunde. Der Bericht nennt keine Modelle und gibt keine Token-Zahlen für den Agententeil an.
Was die Agenten taten und was der Bericht nicht sagt#
Die Agentenseite wird über Aktivität beschrieben, nicht über Kosten. Der erste Prompt ging am 13. August 2026 raus, die Arbeit dauerte etwa drei Wochen, und die Zahlen sind:
- 233 Devin-Sitzungen für die Faktorisierung, im Durchschnitt 3 parallel laufend und 18 zum Höhepunkt
- 192 davon erhielten Nachrichten vom Autor, 36 liefen ganz ohne menschliches Eingreifen
- 101 Kind-Sitzungen wurden von anderen Sitzungen gestartet
- Devins eigene Abrechnung: 14.450 ACUs (das ist Devins Einheit, nicht Tokens)
Die Sitzungen übernahmen Messung, Cluster-Betrieb, Tuning und Debugging. Der Mensch setzte Prioritäten und baute die Benchmarks. Zwei ehrliche Details vom Autor: Die Zerlegung rund um CADO-NFS wurde von einem Menschen entworfen und war essenziell, und die Agenten wurden umso verwirrter, je weiter der Code vom Upstream abwich.
Was fehlt, ist genau das, was ein Budget braucht: welche Modelle, wie viele Tokens. Versuche also nicht, aus 14.450 ACUs eine Token-Rechnung abzuleiten. Alles, was du online liest und das tut, ist geraten.
Die dritte Zeile: menschliche Steuerung#
Der Autor schickte 3.328 Nachrichten, insgesamt 82.702 Wörter. Das sind 82.702 ÷ 3.328 ≈ 25 Wörter pro Nachricht, kurze Anstöße statt Aufsätze. Diese Wörter kosten fast nichts an Tokens. Sie kosten Aufmerksamkeit: Jemand muss lesen, was die Agenten getan haben, und entscheiden, was als Nächstes kommt. Wenn du ein Agentenprojekt budgetierst, setze das als eigene Zeile in Stunden an, nicht in Dollar an API-Nutzung.
Ein langes Agentenprojekt hat also drei Zeilen:
Tabelle nach rechts scrollen →
| Zeile | Im RSA-260-Bericht | Was sie bei dir bestimmt |
|---|---|---|
| Compute | ~414.000 $ GPU-Zeit, bepreist mit 3,50 $ pro GPU-Stunde | Dein eigener Job: Builds, Tests, Training, Simulationen |
| Modell-Tokens | Nicht berichtet | Sitzungen × Schritte × Tokens pro Schritt |
| Menschliche Steuerung | 3.328 Nachrichten über ~3 Wochen | Wie oft du prüfst und umlenkst |
Schätze deine Token-Zeile#
Hier ist die Formel, und das eine, was Leute vergessen: Jeder Schritt sendet die Historie erneut. Ein Agent erinnert sich nicht an eine Sitzung; jeder Aufruf trägt die Aufgabe, die gelesenen Dateien und die bisherige Tool-Ausgabe mit sich. Deshalb übersteigen Input-Tokens normalerweise die Output-Tokens bei Weitem (mehr dazu in warum KI-Agenten so viele Tokens verbrauchen).
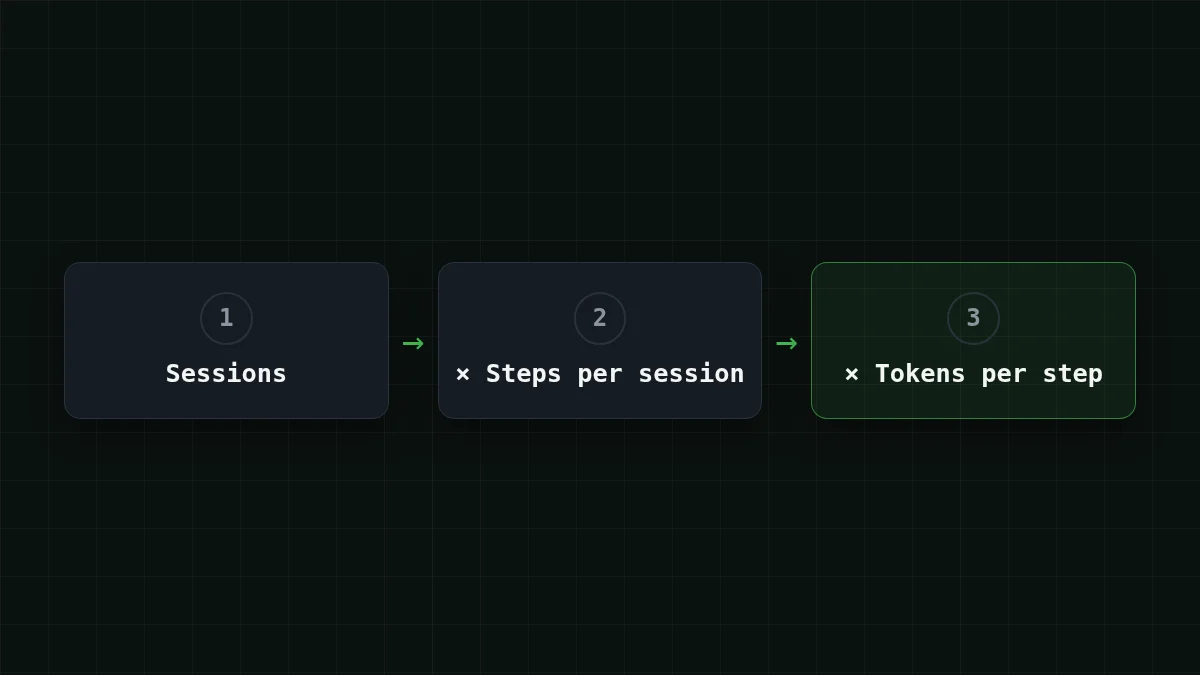
Angenommen, du planst ein Projekt in der Größe von Cognition, 233 Sitzungen, und nimmst 60 Schritte pro Sitzung an. Diese beiden Zahlen sind Annahmen dieser Seite, keine Cognition-Daten. Dann:
233 × 60 = 13.980
das sind 13.980 Modellaufrufe. Jetzt die Größe eines Aufrufs. Angenommen, ein durchschnittlicher Schritt sendet 60.000 Tokens hinein (Aufgabe, Historie, ein oder zwei Dateien) und bekommt 1.500 Tokens zurück (ein Befehl oder ein Patch). Summen:
60.000 × 13.980 = 838.800.000
1.500 × 13.980 = 20.970.000
Also etwa 839 Mio. Input-Tokens und 21 Mio. Output-Tokens. Der Input ist vierzigmal so groß wie der Output, und dort liegt dein Budget. Auf DeepSeek-V4-Flash kostet dieses Projekt $14.68, und eine Sitzung mit 60 Schritten kostet $0.063. Hier ist dieselbe Last auf jedem Modell, mit der OpenRouter-Referenz daneben:
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 13.980 Anfragen | OpenRouter, 13.980 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0013 | $17.61 | $29.84 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0011 | $14.68 | $61.65 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0032 | $45.09 | $541.03 |
60.000 Input- und 1.500 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Insgesamt betrachtet, Input und Output zusammen, ist jedes unserer Modelle für diese Last günstiger als OpenRouter. Die Preise sind live von der Preisseite, die Tabelle ändert sich also, wenn sich die Tarife ändern.
Probier es selbstProbier es aus: Die 60-Schritte-Sitzung sendet im Durchschnitt 60.000 Tokens hinein. Sendet Schritt 1 genauso viel wie Schritt 60?Antwort anzeigen
Nein. Schritt 1 sendet wenig (die Aufgabe und ein paar Dateien), Schritt 60 sendet alles erneut, was unterwegs gesammelt wurde. 60.000 als Durchschnitt anzunehmen setzt voraus, dass die Sitzung klein beginnt und bei etwa 100K oder mehr endet. Wenn du weißt, dass deine Sitzungen bei sagen wir 120K enden, liegt der Durchschnitt bei etwa der Hälfte davon. Miss also die größte Anfrage, nicht nur den Durchschnitt.
Hol dir deine eigenen Zahlen in zehn Minuten#
Annahmen sind nur ein Ausgangspunkt. Führe eine echte Sitzung deiner Aufgabe auf einem günstigen Modell aus und lies das usage-Objekt, das die API bei jeder Antwort zurückgibt. OpenAI-kompatible Endpunkte melden prompt_tokens und completion_ pro Aufruf:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "max_tokens": 1500, "messages": [{"role": "user", "content": "Summarize this test failure and propose a fix: ..."}]}'
Summiere usage über die ganze Sitzung, teile durch die Anzahl der Aufrufe und ersetze die 60.000 und 1.500 oben durch deine Durchschnittswerte. Details zum Setup stehen in der CheapTokens-Doku; das Tracking pro Schritt im Code steht in KI-Agenten-Token-Kosten in Python verfolgen. Für dieselbe Rechnung bei einer einzelnen 50-Schritte-Sitzung siehe Agenten-Sitzungskosten auf GLM, DeepSeek oder MiniMax.
Für lange Schleifen hat DeepSeek-V4-Flash ein Kontextfenster von 380K und bis zu 32.768 Output-Tokens pro Antwort, zu einem Preis zu jeder Stunde. GLM-5.3-Flash hat ein Fenster von 390K und MiniMax-M2.7 hat 180K, prüfe also, ob deine größte Anfrage hineinpasst.
Wähle deinen Fall
Welches Projekt sieht aus wie deins?
Wähle eine Option, um die Antwort zu sehen
Viele kurze Sitzungen
Kleine Aufgaben, jede startet frisch: Der Input pro Aufruf bleibt niedrig. Multipliziere Sitzungen mit Schritten, und erwarte, dass die Summe von der Anzahl der Aufrufe dominiert wird, nicht von ihrer Größe.
Wenige sehr lange Sitzungen
Die Historie wächst über die Sitzung, die letzten Schritte sind also die teuren. Schätze mit der größten Anfrage, teile die Arbeit in Kind-Sitzungen mit jeweils kurzem Briefing auf, und der Input hört auf, sich aufzuschaukeln.
Schweres Compute plus Agenten
Wie RSA-260: Der Job selbst braucht Hardware. Bepreise die Hardware pro Stunde bei deinem Anbieter und halte die Token-Zeile als separate Schätzung. Sie addieren sich nicht im Kopf, nur in einer Tabelle.
Verenge die Aufgabe, bevor du das Budget erhöhst#
Der Bericht hat eine weitere Lektion, die zu einem Budget passt: Je weiter der Code vom Upstream abwich, desto verwirrter wurden die Agenten. Verwirrte Agenten brauchen mehr Schritte. Wenn deine Schätzung zu hoch aussieht, verringere zuerst die Schritte pro Sitzung: ein klareres Briefing, ein kleinerer Codebereich, feste Schritte in Skripte ausgelagert (siehe brauchen Agenten bei jedem Schritt das Modell). Halbierst du die Schritte, halbierst du die Token-Zeile; das ist der einfachste Hebel, den du hast.


