成本优化深度解析
为长期 agent 项目做预算:计算 vs token(RSA-260 案例)
RSA-260 的 40 万美元标题数字是 GPU 租用费,不是模型 token。把长期 agent 项目拆成三条预算线,并用会话数 × 步数 × token 数来估算 token 部分。
Cognition 的 RSA-260 分解中约 40 万美元的数字是 GPU 租用费,不是模型账单。报告完全没有给 agent 侧定价,所以如果你计划一个长期 agent 项目,token 这一项得自己估算:会话数 × 步数 × 每步 token 数,按实时价格计算。本页剩下的内容就是做这件事。
来源是 Cognition 工程师 Eric Lu 撰写的文章(Factoring RSA-260,发布于 2026 年 9 月 9 日,2026 年 11 月 6 日核对)。它被重新分享时标题里带着这个美元数字,而这个数字很容易被误读。
这 40 万美元实际付的是什么#
作者用 GNFS 分解了一个 260 位数,使用的是经过大量修改、可在 GPU 上运行的 CADO-NFS。报告给出了每个阶段的 GPU 时间:
- 多项式选择:643 GPU-天
- 筛法:3,813 GPU-天
- 线性方程组求解:467 GPU-天
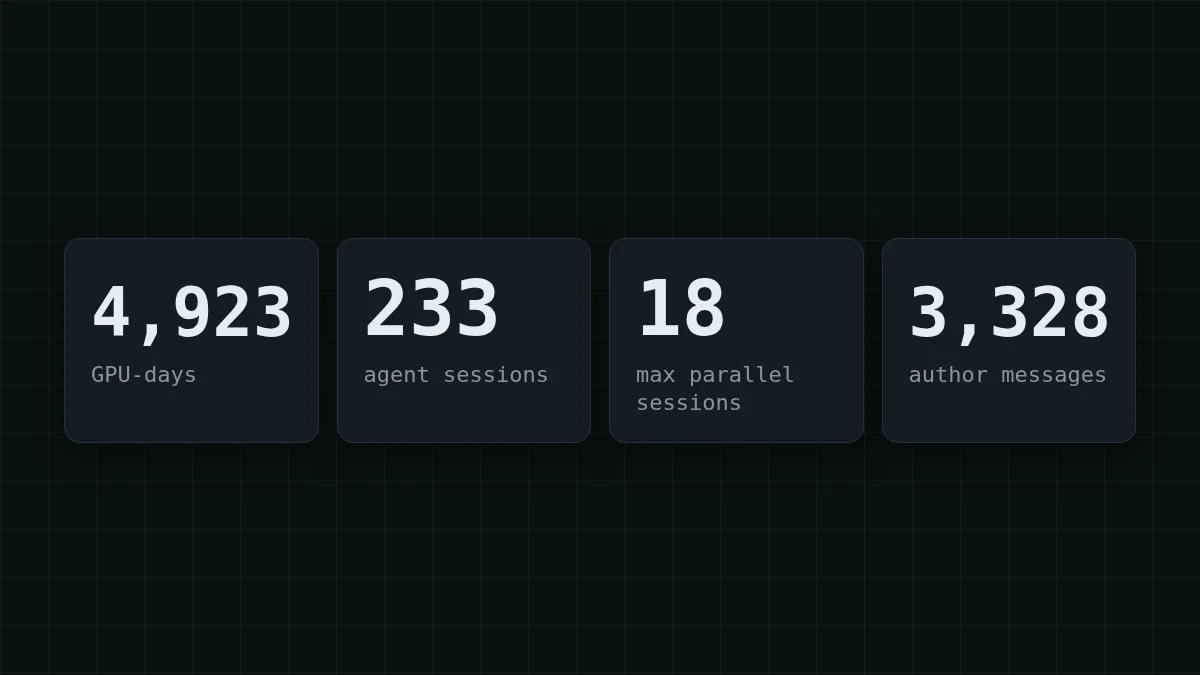
合计 643 + 3,813 + 467 = 4,923 GPU-天,报告将其四舍五入为约 4,900。按报告假设的每 GPU-小时 3.50 美元:
4,923 × 24 × 3.50 = 413,532
这与其附录中的 41.4 万美元 GPU 数字相符。所以标题数字是租用硬件跑一个持续数周的大量计算任务。这个总和里没有任何模型 token。
快速检查
RSA-260 报告中约 40 万美元的数字是什么?
显示答案
答案: 分解运行中按市场价租用 GPU 的费用
它来自 GPU-天 × 每 GPU-小时 3.50 美元。报告没有点名任何模型,也没有给出 agent 部分的 token 数。
agent 做了什么,以及报告没说什么#
agent 侧是按活动描述的,不是按成本。第一个提示于 2026 年 8 月 13 日发出,工作耗时约三周,数字如下:
- 分解工作共 233 个 Devin 会话,平均 3 个并行运行,峰值为 18 个
- 其中 192 个收到了作者的消息,36 个完全无人干预运行
- 101 个子会话由其他会话启动
- Devin 自己的统计:14,450 ACU(这是 Devin 的单位,不是 token)
这些会话负责测量、集群运维、调优和调试。人类设定优先级并构建基准。作者给出的两个诚实细节:围绕 CADO-NFS 的分解方案由人设计,且至关重要;代码偏离上游越远,agent 就越困惑。
缺失的恰恰是预算所需的东西:用了哪些模型、多少 token。所以不要试图从 14,450 ACU 反推 token 账单。网上任何这样做的内容都是猜测。
第三条线:人工引导#
作者发送了 3,328 条消息,总计 82,702 个词。也就是 82,702 ÷ 3,328 ≈ 每条消息 25 个词,是简短的提示而非长篇大论。这些词在 token 上几乎不花钱。它们花的是注意力:必须有人阅读 agent 做了什么并决定下一步。为 agent 项目做预算时,把这一项单独列成小时数,而不是 API 使用的美元数。
所以一个长期 agent 项目有三条线:
向右滚动表格 →
| 线 | RSA-260 报告中 | 你的项目由什么决定 |
|---|---|---|
| 计算 | 约 41.4 万美元的 GPU 时间,按每 GPU-小时 3.50 美元计价 | 你的任务本身:构建、测试、训练、模拟 |
| 模型 token | 未报告 | 会话数 × 步数 × 每步 token 数 |
| 人工引导 | 约 3 周内 3,328 条消息 | 你审查和调整方向的频率 |
估算你的 token 线#
公式如下,还有一件人们会忘记的事:每一步都会重新发送历史。 agent 并不记得一个会话;每次调用都携带任务、它读过的文件以及到目前为止的工具输出。这就是为什么输入 token 通常远超输出 token(更多内容见为什么 AI agent 使用这么多 token)。
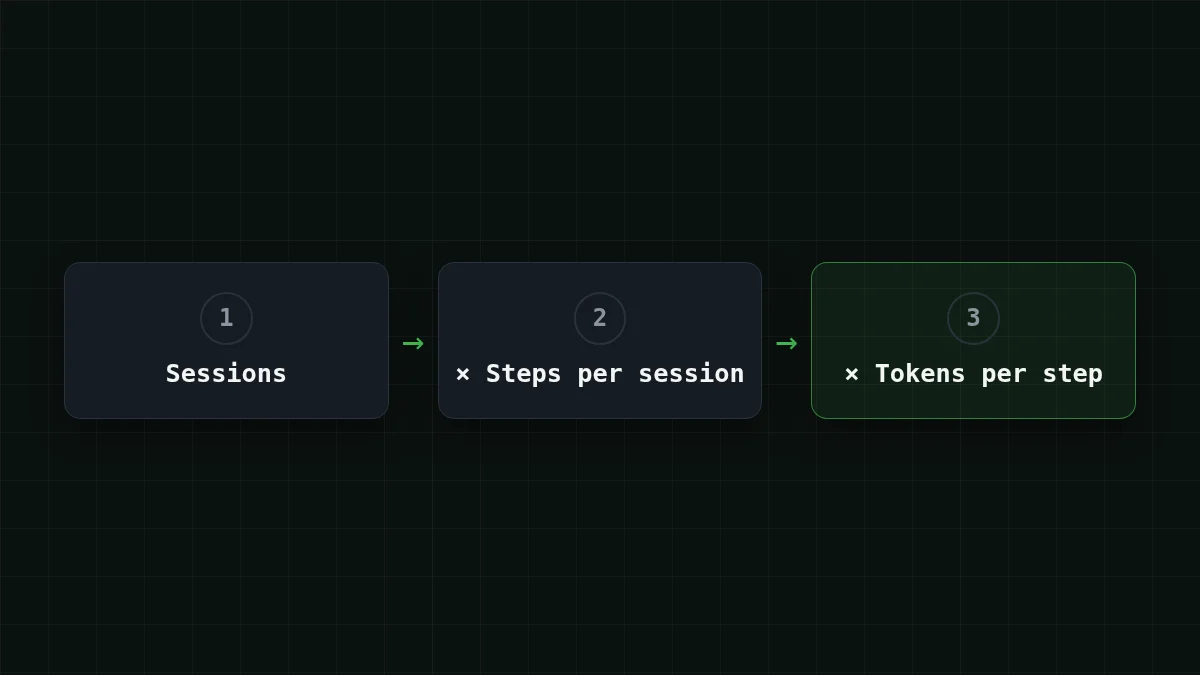
假设你计划一个与 Cognition 规模相当的项目,233 个会话,并假设每个会话 60 步。这两个数字是本页的假设,不是 Cognition 的数据。那么:
233 × 60 = 13,980
也就是 13,980 次模型调用。现在看单次调用的大小。假设平均一步发送 60,000 个输入 token(任务、历史、一两个文件),并返回 1,500 个 token(一条命令或一个补丁)。总计:
60,000 × 13,980 = 838,800,000
1,500 × 13,980 = 20,970,000
所以大约 8.39 亿输入 token 和 2,100 万输出 token。输入是输出的四十倍,而你的预算主要花在这一侧。在 DeepSeek-V4-Flash 上,这个项目花费 $14.68,一个 60 步的会话是 $0.063。下面是同样的负载在每个模型上的花费,旁边是 OpenRouter 的参考价:
| 模型 | 输入 $/1M | 输出 $/1M | 每次请求 | 13,980 次请求 | OpenRouter,13,980 次请求 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0013 | $17.61 | $29.84 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0011 | $14.68 | $61.65 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0032 | $45.09 | $541.03 |
每次请求 60,000 个输入 token 和 1,500 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
按输入和输出合计计算,对于这个负载,我们的每个模型都比 OpenRouter 便宜。价格实时来自定价页面,所以表格会随价格变动。
自己试试试一试:60 步的会话平均输入 60,000 个 token。第 1 步发送的量和第 60 步一样多吗?显示答案
不。第 1 步发送得很少(任务和几个文件),第 60 步会重新发送沿途收集的所有内容。把 60,000 当作平均值,意味着会话开始时很小,结束时接近 100K 或更多。如果你知道会话结束时是比如 120K,平均值大约是它的一半,所以要测量最大的请求,而不只是平均值。
十分钟内得到你自己的数字#
假设只是起点。用便宜模型跑一个你任务的真实会话,读取 API 在每次响应中返回的 usage 对象。OpenAI 兼容端点会报告每次调用的 prompt_tokens 和 completion_:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "max_tokens": 1500, "messages": [{"role": "user", "content": "Summarize this test failure and propose a fix: ..."}]}'
对整个会话的 usage 求和,除以调用次数,用你的平均值替换上面的 60,000 和 1,500。设置细节见 CheapTokens 文档;代码中的逐步跟踪见用 Python 跟踪 AI agent token 成本。对单个 50 步会话做同样的算术,见GLM、DeepSeek 或 MiniMax 上的 agent 会话成本。
对于长循环,DeepSeek-V4-Flash 有 380K 上下文窗口,每次回答最多 32,768 个输出 token,任何时段价格相同。GLM-5.3-Flash 有 390K 窗口,MiniMax-M2.7 有 180K,所以检查你最大的请求是否能放下。
选择你的情况
哪个项目像你的?
选择一个选项以查看答案
许多短会话
小任务,每个都从头开始:每次调用的输入保持较低。会话数乘以步数,预计总量主要由调用次数决定,而不是调用大小。
少数超长会话
历史随会话增长,所以最后几步最贵。用最大的请求来估算,把工作拆成子会话并各给一份简短说明,输入就不会滚雪球。
重计算加 agent
像 RSA-260:任务本身需要硬件。按小时从你的提供商那里给硬件定价,并把 token 线作为单独的估算。它们不会在你脑子里相加,只在电子表格里相加。
在提高预算之前先缩小任务#
报告还有一个适合预算的教训:代码偏离上游越远,agent 就越困惑。困惑的 agent 会走更多步。如果你的估算看起来太高,先减少每会话步数:更清晰的说明、更小的代码范围、把固定步骤移入脚本(见agent 是否每一步都需要模型)。步数减半,token 线就减半;这是你最容易的杠杆。


